OpenAI 发布 GPT-6.1 Sol:编程更强,价格仅 Astra 五分之一

OpenAI 发布 GPT-6.1 Sol,以五分之一价格接近旗舰性能,同期 GPT-6.1 Extra 因安全问题被取消。
OpenAI 发布 GPT-6.1 Sol,定位为编程与自动化场景的高性价比模型。其标准 API 定价(输入 2 美元/百万 token,输出 10 美元/百万 token)仅为 GPT-6 Extra 的五分之一,缓存输入价格更低至 0.1 美元/百万 token。在 DeepSWE-1.1 和 AutomationBench 两项专业评测中,该模型以显著更低的成本接近或超越竞品表现。同批发布的 Ultra Fast 加速版本速度最高达 Extra 的 8 倍,面向 500 美元/月 Pro 套餐开放。值得关注的是,原本预期发布的 GPT-6.1 Extra 因内部安全测试发现问题而被取消,显示出安全审查机制正在实质性影响产品发布节奏。对开发者而言,大幅下降的成本门槛有望使此前受限于预算的项目重新具备可行性。
OpenAI 突发上线 GPT-6.1 Sol
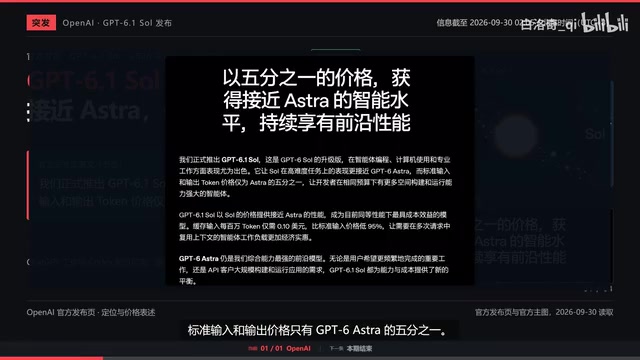
OpenAI 再度加速产品迭代,发布了 GPT-6.1 Sol,官方将其定位为 GPT-6 Sol 的升级版本,主打编程、计算机操作以及专业工作场景的能力提升。最引人关注的是价格策略——标准输入和输出价格仅为 GPT-6 Extra 的五分之一,直接把高性能模型的使用门槛拉低了一个量级。
目前 GPT-6.1 Sol 已经在 ChatGPT 工作台和 Codex 中面向 Plus 到 EDU 用户开放,普通聊天入口暂时还没有上线。开发者可通过 API 调用,型号名称为 GPT-6.1 Sol。这种「先开放专业工具、后铺开消费端」的节奏,也反映出 OpenAI 对编程与自动化场景的优先级判断。
性能表现:以更低成本逼近 Extra
从官方公布的评测数据看,GPT-6.1 Sol 的核心卖点是「性价比」。在 DeepSWE-1.1 基准上,它以大约五分之一的成本接近 GPT-6 Extra 的表现,同时比上一代 GPT-6 Sol 的最高分高出 6.4 个百分点。
在 AutomationBench 上,GPT-6.1 Sol 比 Opus-5.5 高出 2.2 个百分点,而成本仅为其约三分之一。换句话说,这个模型试图在编程与自动化任务上重新定义「够用且便宜」的坐标点。
不过 OpenAI 也明确强调,GPT-6 Extra 仍然是当前最强的旗舰模型。GPT-6.1 Sol 的定位更接近一个「高效替代品」——在绝大多数专业任务中提供接近顶配的体验,同时把预算压到可接受的范围内。

DeepSWE-1.1 是一个专门面向软件工程任务的大模型评测基准,全称 Deep Software Engineering Benchmark,主要考察模型在真实代码库中完成 bug 修复、功能实现、代码重构等任务的能力。与早期只测试代码补全准确率的基准不同,DeepSWE 系列更强调「端到端解决实际工程问题」的能力,评测场景来自真实的开源项目 issue,要求模型不仅能生成代码,还要能理解项目上下文、定位问题、并产出可通过测试的补丁。AutomationBench 则侧重于计算机操作自动化,测试模型在操作浏览器、桌面应用、执行多步骤任务等场景下的表现,更贴近 AI Agent 的实际落地需求。这两个基准的选取本身就透露出 OpenAI 对 GPT-6.1 Sol 应用方向的明确定位——不是通用对话,而是编程与自动化工作流。
定价细节:缓存输入价格成为焦点
具体价格方面,GPT-6.1 Sol 的标准 API 定价为每百万 token 输入 2 美元、输出 10 美元,缓存输入低至每百万 token 0.1 美元。缓存输入比标准输入便宜 95%,对于需要反复调用相同上下文的应用来说,成本优势极为明显。
另一边,OpenAI 还推出了 GPT-6 Extra Ultra Fast 和 GPT-6.1 Sol Ultra Fast 两个加速版本,官方称速度最高可达 Extra 的 8 倍,并向新的每月 500 美元 Pro 套餐开放。

社区的讨论也集中在价格上。据 B 站 UP 主转述的社区反馈,Hacker News 上最高赞评论引用官方页面指出,缓存输入价格降到每百万 0.1 美元,比 GPT-6 Sol 的缓存价格又低了一半。这种阶梯式降价,正在持续压低大模型的调用边际成本。

Token 缓存(Prompt Caching) 是一种 API 层面的优化机制:当请求中包含与上一次调用相同的前缀内容(如固定的系统提示、长文档、代码库上下文)时,服务端可以复用已计算好的中间状态,跳过重复的计算步骤,从而大幅降低该部分的处理成本。OpenAI 将这部分费用单独计价,即「缓存输入价格」。对于需要在每次请求中携带大量固定上下文的应用——例如基于完整代码库进行问答的开发工具、拥有长篇系统提示的客服机器人——缓存命中率越高,实际单次调用成本就越接近缓存价格而非标准价格。GPT-6.1 Sol 将缓存输入价格压到每百万 token 0.1 美元,相当于标准输入价格的 5%,这对高频、长上下文场景的成本结构影响极为显著。
缺席的 GPT-6.1 Extra 与安全隐忧
值得关注的是,此前市场普遍预期的 GPT-6.1 Extra 并没有随本次更新一同发布。据《华尔街日报》报道,该模型因内部测试中发现的安全问题而被取消。
这一细节透露出 OpenAI 在能力扩张与安全把控之间的取舍。旗舰级模型的推迟或取消,说明厂商在推向市场前的红线正在收紧,尤其是在模型能力越来越接近可自主完成复杂任务的阶段。对于关注 AI 安全的从业者而言,这可能比价格调整更具信号意义。
AI 安全审查中的「内部测试发现问题」通常涵盖多个维度,包括越狱鲁棒性(模型能否被诱导输出有害内容)、自主行为评估(模型在 Agent 场景下是否会执行未经授权的操作)、以及能力危险性评估(模型是否达到可辅助生物武器、网络攻击等高风险任务的能力阈值)。随着模型能力持续增强,主流 AI 实验室普遍引入了分级安全评估框架——Anthropic 的「AI Safety Levels」、OpenAI 的「Preparedness Framework」均属此类。一旦模型在某项危险能力评估中触发红线,即便其综合性能表现优异,也可能被推迟发布或要求针对性缓解后再上线。GPT-6.1 Extra 的取消,是该类框架实际发挥约束作用的公开案例之一。
对开发者意味着什么
综合来看,GPT-6.1 Sol 的发布传递出几个明确趋势:一是编程与自动化场景成为大模型竞争的核心战场;二是价格战仍在延续,缓存机制成为降本的关键杠杆;三是安全审查开始实质性影响产品发布节奏。
对于依赖 API 构建应用的团队来说,五分之一的价格加上接近旗舰的性能,意味着许多此前因成本受限的项目重新具备了可行性。而 Ultra Fast 版本则为对延迟敏感的实时应用提供了新的选项。在旗舰仍是 Extra、性价比交给 Sol 的分层策略下,开发者需要更精细地根据任务类型匹配模型档位。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。