OpenAI GPT-5.6发布:三版本怎么选?三合一超级应用全解析

OpenAI发布会重点速览
OpenAI再次带来一场信息密度极高的发布会,核心围绕两条主线展开:全新旗舰模型GPT-5.6,以及将ChatGPT、Work、Codex三大功能整合为一体的「超级应用」。话说回来,图像生成赛道也杀出黑马——Reve 2.1,直接跻身竞技场排名前列。
对普通用户而言,OpenAI的产品线越来越丰富,反而容易带来「选择困难」。本文将梳理这次发布会的关键信息,帮你理清模型怎么选、三大模式如何区分。
GPT-5.6三个版本如何选
GPT-5.6正式推出,划分为三个能力层级,覆盖不同预算和使用场景:
- SOUL(旗舰版):综合实力最强,多项测试表现优于对标模型Fable 5,定价反而更具竞争力。适合复杂编程和高强度知识工作,需订阅后使用。
- TERA(均衡版):未订阅用户的默认选项,水平与上一代GPT-5.5相当,能够胜任日常绝大多数任务。
- LUNA(性价比版):专为开发者设计,编程测试分数超过Opus 4.8,同时保持更高的性价比。
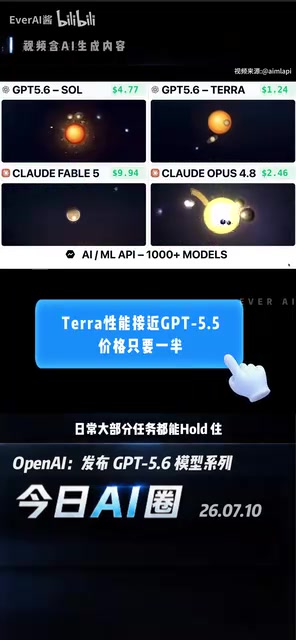
这种分层策略延续了大型科技公司产品矩阵的惯常思路,类似Adobe Creative Cloud的分级订阅体系。从技术层面看,三个版本并非简单的「阉割」关系,而是在模型参数规模、推理计算量(FLOPs)和上下文窗口等维度上做出差异化取舍。LUNA专攻编程任务的设计,暗示OpenAI可能针对代码数据进行了特定微调(Fine-tuning),延续了早期Codex模型的专项优化路线。这种分层策略体现了OpenAI的双线思路:旗舰模型进入订阅墙,性价比模型专攻开发者场景,对用户需求做进一步细分。
遇到难题时的进阶模式
如果连SOUL版本都难以完成的任务,还有两个进阶选项可用:
- MAX模式:为AI提供更长的推理时间,适合需要深度思考的复杂问题。
- AUTO模式:调动四个Agent并行处理,通过多智能体协作提升任务完成效率。
AUTO模式背后的多智能体(Multi-Agent)架构是当前AI工程领域的热点范式。不同于单一大模型的串行推理,多Agent系统将复杂任务分解为子任务,由多个专门化Agent并行处理后汇总结果,理论上可以突破单次上下文长度限制并降低错误累积风险。这一架构与学术界的「Mixture of Experts(MoE)」思路有相通之处,但MoE发生在模型内部权重层面,而多Agent协同则是在推理调度层面的外部编排。两种模式分别在「思考深度」和「并行广度」两个维度上增强能力,代表了大模型从单次推理走向多智能体协同的重要技术方向。
ChatGPT桌面端:三大模式整合进一个应用
本次发布会最重要的产品变化,是ChatGPT桌面端将Chat、Work、Codex三大功能合并到同一入口,各模式定位清晰:
- Chat:日常聊天问答,处理普通对话和信息查询。
- Codex:面向编程开发者的智能体模式,专注代码相关任务。
- Work:新推出的职场办公智能体,底层由Codex与GPT-5.6共同驱动。

说个细节,Chat定位于问答,而Codex和Work都是能「直接干活」的智能体模式——这标志着ChatGPT正从对话工具向真正的生产力平台转型。
Work智能体的核心能力
Work智能体是本次发布的重头戏。依托GPT-5.6增强的计算机操作能力,AI可以查看屏幕、输入内容,并在多个应用之间协同工作,制作PPT、撰写文档、处理表格均可胜任。
此外还新增了名为SYS的能力,可将工作内容或想法直接转化为交互式网站或小应用,并支持公开发布。Work智能体在必要时能持续工作数小时,还支持设置定时任务,实现真正的自动化办公。

「能看屏幕、跨应用操作、长时间运行」的能力组合在技术上依赖计算机视觉(OCR与GUI识别)和操作系统级API调用,业内将其称为「Computer Use」能力。Anthropic的Claude早在2024年底便率先推出类似功能,OpenAI此次的跟进标志着该能力从实验性走向产品化。真正的工程挑战在于任务规划的可靠性——AI必须具备足够的长流程跟踪能力(Long Horizon Planning),才能完成跨小时级别的自动化任务,而非仅仅响应单步指令。这一能力组合标志着AI从被动响应转向主动执行,也是通往实用型AI Agent的关键一步。
两个需要注意的产品调整
随着功能整合,OpenAI也对部分产品做出调整:
- AI浏览器Atlas:功能已整合进ChatGPT。如需在自己的浏览器中使用GPT,可更新Chrome扩展插件,在侧边栏直接调用。
- 群聊功能逐步停用:后续只能查看历史记录、无法继续发送消息,常用该功能的用户需提前做好迁移准备。
竞争格局与图像生成新势力
Anthropic同步重置额度
OpenAI在此次发布中重置了用户使用额度,而Anthropic几乎同步跟进,也对所有用户完成了额度重置。两大厂商几乎同时行动,为用户提供了难得的横向对比窗口。

对用户而言,这场「AI巨头竞速」带来的直接好处是更充裕的免费额度和更快的能力迭代节奏。
Reve 2.1:图像生成赛道新黑马
大模型之外,图像生成领域也出现了值得关注的选手——Reve 2.1。它目前在竞技场排名仅次于GPT Image 2,官方宣称视觉智能与推理能力均有显著提升。
Reve 2.1的差异化在于生图逻辑:它不完全依赖纯文本提示词直接出图,而是先搭建结构化布局,再渲染生成画面。这种「先规划、后渲染」的范式,在技术上与扩散模型(Diffusion Model)的条件控制机制密切相关。传统文生图模型(如Stable Diffusion、DALL-E)直接从文本提示词通过去噪过程生成图像,构图控制依赖提示词工程技巧,容易产生主体错位、元素叠加等问题。Reve引入的结构化布局阶段类似于ControlNet的「骨架先行」思路——先生成场景的空间关系图(Layout),再以此为条件约束扩散过程,从而将构图决策从随机采样中解耦出来,让构图更加细致可控,理论上能有效减少AI生图中常见的构图混乱问题。
总结
这次OpenAI发布会传递出两个明确信号:一是模型能力持续分层,从旗舰到性价比全面覆盖;二是产品形态从对话工具向多智能体生产力平台加速演进,Work智能体的推出尤为关键。
结合Anthropic同步的额度重置,以及Reve 2.1在图像领域的突破,不难看出整个AI行业正处于高速迭代期。对普通用户来说,理清模型版本与工具模式的选择逻辑,才能真正把这些能力用到实处。
核心要点
相关推荐

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。

Zapier、Make、n8n实测对比:同一AI工作流三次翻车
Zapier、Make、n8n三款自动化工具实测对比:用同一个AI线索分类工作流各搭一遍,三者全部翻车。深度拆解搭建时间、运行速度、计费逻辑及各自的静默失败陷阱,帮你选对AI自动化平台。

用n8n搭建AI内容引擎:全自动运营Facebook主页实战
一位创作者用开源工具n8n搭建AI内容引擎,实现Facebook主页全自动运营:选题、写作、配图、审核、发布五步流水线,287篇写出238篇发布,拆解其人机分工逻辑与可复制性。