OpenAI Jalapeño 推理芯片首测拆解:胜负写在每瓦 Token 上
OpenAI 自研推理芯片 Jalapeño 首测,以每瓦吞吐和端到端延迟重新定义推理芯片评价标准。
OpenAI 联合 Broadcom 与 Celestica 推出自研推理芯片 Jalapeño,并公布了与 NVIDIA GB200/GB300 的对比跑分。三组测试显示,在 8K 输入、1K 输出场景下,Jalapeño 实现约 1.5 至 1.9 倍的每瓦混合吞吐提升,端到端延迟缩短 43% 至 72%。这背后的设计逻辑是针对推理 Decode 阶段的内存带宽瓶颈——将 KV Cache 锁定本地、把网络揉进芯片架构,以换取更低的 Token 间延迟。但这批数据存在明显边界:测试由 OpenAI 提供且无公开原始日志,未覆盖长上下文 Agentic 任务,也未纳入即将量产的 Vera Rubin 作为对照。行业大趋势已经明确:缓存、带宽、互联与 Serving 软件协同,是当下推理系统竞争的核心战场。
OpenAI 自研推理芯片首秀,规则被重新定义
OpenAI 刚刚公布了自研推理芯片 Jalapeño 的首批测试成绩。这颗芯片封装额定功耗 700W,但官方特别强调,实测持续功耗并没有超过 550W。这个细节很关键——在看图表时要注意,指标里的 Mixed TPS/kW 是按 700W 归一化计算的,而 550W 才是实际跑分时的真实状态。
整个对比的核心,不再是过去大家熟悉的乘加运算频率或峰值算力,而是转向了一个更务实的坐标系:在固定功耗预算下,系统能吞吐多少 Token、延迟有多低。需要先对齐口径的是,这套数据不包含整个机架的 CPU、网络或散热开销,更不是数据中心最终的 PUE。
平时我们写代码或用 AI 聊天,感受到的从来不是冷冰冰的 TFLOPs,而是首字蹦得快不快、生成卡不卡。工程上这对应的是 TTFT(首 Token 延迟)和 TBT(Token 间延迟)。GPU 的理论算力是天花板,但落地后,内存带宽、KV Cache、排队策略和跨卡通信都会来拖后腿。Jalapeño 首批公布的成绩,直接把核心指标从算力切到了「既定功耗和延迟下的 Token 交付率」,对线上服务而言,这个视角明显更贴近现实。
攒机阵容与研发周期:分工明确,但时间表存疑
这次的合作阵容分工清晰:OpenAI 负责架构定义,Broadcom 做芯片实现和网络连接,Celestica 搞定板卡和系统集成。作为跑真实线上负载的模型厂商,OpenAI 最清楚哪个算子跑得慢、Agent 会怎么消耗上下文,然后把这些需求提给芯片厂。
OpenAI 宣称,从初始设计到 Tape Out(流片)只用了 9 个月。而 Semi Analysis 算上团队组建的时间,认为大概是 16 个月。无论怎么算,「最快研发周期」都是 OpenAI 自己的口径,听听就好,不宜当成行业审计标准。
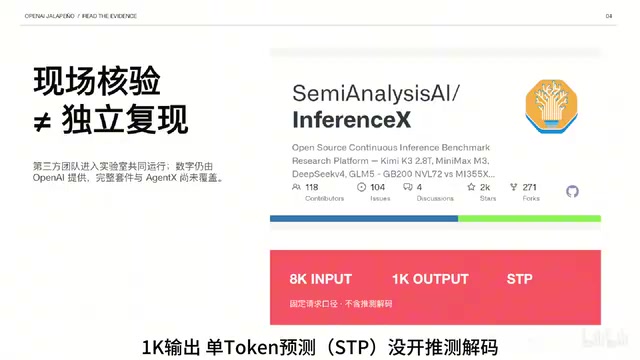
值得警惕的是这组跑分的含金量。这次用的是 Semi Analysis 的 InferenceMAX 框架,第三方确实进了实验室,跟工程师现场一起跑,但数据依然是 OpenAI 提供的,且没跑完整套件,也没有公开原始日志。严谨地说,这是「第三方现场核验过的厂商成绩」,目前还不具备外部独立复现的条件。测试场景也被严格限制在 8K 输入、1K 输出,没开推测解码(Speculative Decoding),也没测多轮长上下文的 Agentic 任务。
Tape Out(流片)是芯片研发中的关键里程碑,指设计团队将最终确认的版图数据提交给晶圆厂,启动实际的光刻制造流程。在此之前,设计团队需要完成 RTL 编写、逻辑综合、时序收敛、物理实现(布局布线)及大量仿真验证;Tape Out 之后还有封装、测试、良率爬坡等环节,从流片到芯片可以真正跑线上负载,通常还需要数月时间。9 个月或 16 个月的数字,指的是从设计启动到 Tape Out,并不涵盖后续的量产爬坡周期。Broadcom 在这次合作中承担芯片实现角色,其 2nm 级先进制程经验和与台积电的深度合作关系,是压缩研发周期的重要外部条件之一。
三组跑分拆解:优势真实,但边界必须划清
三组跑分都在比拼 Mixed TPS/kW,也就是混合吞吐除以功耗。注意这里的「Mixed」,是把输入和输出的 Token 处理量混在一起算的,它能反映系统在固定功耗下的整体工作量,但不能直接等价于用户能多快看到输出。想看纯输出速度,得去查 InferenceMAX 单独拆分出的输出吞吐指标。
第一组:gpt-oss 120B 对标 GB200。 Jalapeño 峰值每瓦吞吐约 85,448 对 44,960,约 1.9 倍;端到端延迟从 1.80 秒压到 1.03 秒,缩短约 43%;最低 TBT 从 1.87 毫秒降到 0.69 毫秒。TBT 越低,输出越连贯。
第二组:DeepSeek广告 R1 670B 对标 GB300(精度 MXFP4)。 每瓦吞吐约 1.7 倍(19,641 对 11,781);端到端延迟从 5.99 秒降到 1.65 秒,砍掉约 72.5%。
第三组:Kimi K2 1T 对标 GB300。 每瓦吞吐约 1.5 倍(18,195 对 11,862);端到端延迟从 5.31 秒降到 1.56 秒,缩短约 70.6%。万亿参数模型极度吃跨芯片传输,权重、激活值和 KV Cache 在不同层级搬运的路径成本很高。
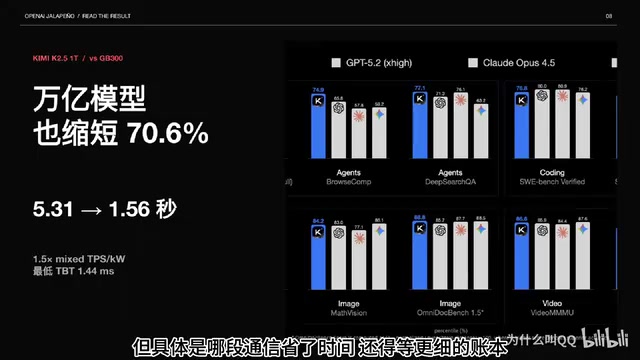
结论到这里就足够了:在划定的模型、请求长度和运行环境内,Jalapeño 确实跑出了更高的混合吞吐和更低的延迟。但把「1.9 倍」直接换算成数据中心省电比例,就是跨界了——不同供应商测的并发、序列长度和网络形态都不一样。OpenAI 把功劳归于软硬件协同,但公开数据并没拆解出排队、内存访问或通信分别贡献了多少,「结果就是结果」,工程归因还得打问号。
MXFP4 是微软、英特尔等公司联合推动的 MX(Microscaling)浮点数格式标准中的 4 位精度变体。与传统 FP16 或 BF16 相比,MXFP4 每个数值只占 4 位,理论上可将内存占用和带宽需求压缩到约 1/4,同时允许硬件在相同面积内堆入更多计算单元。MX 系列格式的关键设计在于引入了共享缩放因子(shared scaling factor),一组数值共用一个指数块,以此在极低位宽下保留足够的动态范围,减少量化误差。第二组测试使用 MXFP4 精度运行 DeepSeek R1 670B,意味着模型权重被量化到该精度,这会对模型质量产生一定影响。跨精度的性能对比在工程上有实际意义,但在评估「哪块芯片更强」时,需要同时确认两侧使用的精度是否对等,否则吞吐差异可能部分来自量化收益而非纯粹的硬件优势。
设计思路:把 Prefill 和 Decode 当两半来打
要理解 Jalapeño 的设计逻辑,得把推理拆成两个阶段。
Prefill 阶段:你丢给模型一大段 prompt,它需要飞速消化并建立状态。这一步是纯粹的算力密集型,矩阵计算量极大,很容易把计算单元跑满。如果沿用训练大模型的思路,很容易只盯着这半程。
Decode 阶段:请求进入连续生成后,模型开始一个字一个字往外蹦,单步计算量断崖式下降,但每次都要反复读内存里的权重和状态。这时瓶颈从算力变成了内存带宽和访问延迟。就像一条流水线,前面是集中备料,后面变成每拧一颗螺丝都得回远处仓库取件——通道一堵,生产就停,TBT 随之飙升。OpenAI 自己也强调,decode 极度受限于内存带宽。
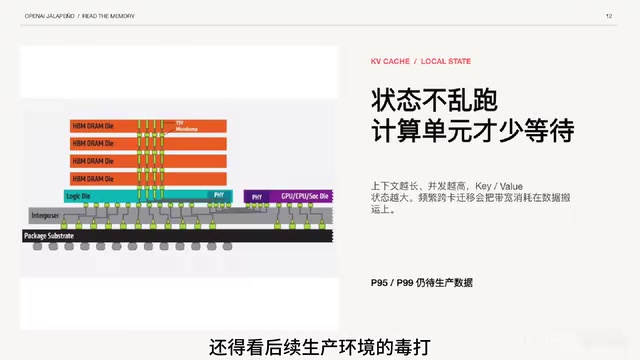
破局关键在 KV Cache。生成下一个 token 时,模型要查之前的记忆(key 和 value),上下文越长这坨记忆越大。如果在多张卡之间来回搬,带宽全用来运数据,计算单元只能干等。Jalapeño 的核心解法就是把 KV Cache 等状态强行留在本地。当然,这是理想状态,尾部延迟(P95、P99)到底稳不稳,还得看生产环境的实际考验。
KV Cache 的规模会随上下文长度呈线性乃至更快速度增长。以一个典型的 7B 参数模型为例,处理 32K tokens 的请求时,KV Cache 可能占用数 GB 显存,而权重本身大约只有 14GB。当并发请求增多,KV Cache 很快会把显存挤满,迫使系统将部分状态卸载到更慢的存储层级(如 CPU 内存或 NVMe),每次读回的延迟会让 TBT 出现明显抖动。这也是为什么各家芯片厂商在设计推理加速器时,会把片上 SRAM 容量、HBM 带宽和跨芯片互联速率当作首要约束——不是算力不够用,而是「记忆搬运」的代价越来越难以消化。Jalapeño 将 KV Cache 尽量锁定在本地的设计选择,本质上是在用更大的本地存储换取更低的搬运延迟,这是一种以空间换时间的系统级权衡。
网络揉进架构:全站控制权才是终局
到了线上,单块硅片再强也没用。请求进来要过路由、处理、缓存切分,最后才是网络分发,任何一环掉链子,用户就会觉得卡。Jalapeño 把网络直接揉进了芯片架构,尽量让请求留在一个互联域里跑完。做基础设施的都知道,计算单元闲着多半是在等数据,如今瓶颈往往不是算力不够,而是缓存和数据调度还没落位。
OpenAI 亲自下场造芯,本质是想要全栈控制权。它既做模型又写 Serving,现在手伸到了底层的内存和网络:线上发现某类 Kernel 跑得慢,下一代硬件直接改;发现 Agent 任务吃等待,调度策略马上跟进。它的终极指标不再是单纯的 FLOPs,而是「每亿美元的有用智能」——少花几度电、同等电力多跑几个并发,这才是产品侧真正能感知到的账单。
竞争格局与几个冷静的提醒
NVIDIA 的基本盘依然稳固。GB200 NVL72 那套 130TB/s 通信带宽的液冷机架,系统工程壁垒极高。Jalapeño 初期主阵地肯定是 OpenAI 自家机房,用真实负载磨合。要特别注意,这次公开附录只比了 GB200 和 GB300,并没有带上即将量产出货的 Vera Rubin,数据只代表当前切面,远没到下定论的时候。
大厂都在把推理提炼出来做定制:Google TPU 狂堆片上 SRAM,微软 Maia 主打超大内存和以太网互联,AWS Trainium 卷整机互联吞吐。各家测试环境不同,无法直接拉通对比,但趋势高度统一——缓存、带宽、互联和 Serving 软件已是当下推理系统的绝对核心。
关于 OpenAI 和 Broadcom 那个数十吉瓦级加速器合作计划,这是规划到 2029 年底的长期蓝图,并不意味着 Jalapeño 第一代就已铺开产能。芯片流片、高级封装、液冷、供电、拿地建机房,缺一不可。算力战争早过了发 PPT 的阶段,设备能按时塞进机房并点亮,才是有效产能。
还有个卖点:AI 辅助造芯。OpenAI 称在某些特定算子实现上,AI 写的代码比人类专家快 1.5 到 1.8 倍。但这仅限局部环节,芯片验证依然是苦力活,跑仿真、做综合、查时序,AI 生成的候选代码最后仍要经过极其严格的回归测试。
最后一个反直觉的点:能效高了机房未必省电。杰文斯悖论告诉我们,推理成本越低、速度越快,大家就越敢滥用——常驻 Agent、多轮对话全冒出来,总电力需求反而可能暴涨。看能耗,必须把单位功耗和暴增的总需求放在一起算。
杰文斯悖论(Jevons Paradox)源自 19 世纪英国经济学家威廉·斯坦利·杰文斯的观察:蒸汽机效率提升之后,英国煤炭总消耗量非但没有下降,反而大幅攀升,因为更高效率使得更多场景用得起蒸汽机。这一规律在 IT 行业反复应验——CPU 能效每隔几年翻倍,但数据中心总用电量依然持续增长;移动网络速率提升,用户消耗的流量也等比例膨胀。推理芯片领域的逻辑同理:当每次 API 调用的成本降低到足够低,之前因为「太贵」而克制的场景——常驻后台的个人 Agent、每隔几分钟自动触发的代码审查、多模型串联的 Agentic 工作流——都会被解锁并规模化部署。因此,评估一代新芯片对数据中心能耗的真实影响,需要同时建模需求侧的弹性,而不仅仅看单位工作负载的功耗数字。
结语:评价标准已经换了
首批跑分释放的信号很明确:推理芯片的评判标准已经彻底倒向每瓦 Token、端到端延迟和系统利用率。接下来该盯什么?盯开放的原始日志,盯长上下文的 Agentic 任务实测,还有生产环境里的 P99 尾部延迟。
对普通用户而言,这也许只是一次「出字快点」的体验升级;但在基础设施层面,一整套评价标准已经改朝换代。你在乎的是首字响应速度,还是系统极限吞吐量?
相关推荐
Fable 5.2灰度测试曝光:Anthropic或将超越GPT-6 Astra
Anthropic疑似灰度测试Fable 5.2和Opus 5.2,社区测试者称其推理能力超越GPT-6 Astra,但代价是更慢的生成速度与更高成本。本文梳理泄露细节、IPO商业博弈与AI安全叙事争议,并提醒相关信息未获官方证实。
免费调用 GPT-6 Astra:配合 Cline 实测生成 4 款 3D 游戏
详解如何免费试用 GPT-6 Astra 模型:通过 Zenslab 关联 Telegram 领取积分,配合 VS Code 的 Cline 扩展接入 API,实测生成烹饪游戏、战术射击及 Dust2 地图等 4 款 3D 游戏,并分析免费额度的实际能力与限制。
警惕第三方ChatGPT充值陷阱:三种方式的风险辨析
针对社交平台流行的第三方ChatGPT充值教程,本文客观辨析代充网站、境外信用卡直充、移动端内购三种方式的流程与风险,重点提示所谓"不给密码就安全"的误导性及封号隐患。