OpenAI撤回三项数学成果:AI科研可信度再受拷问

OpenAI撤回三项数学成果,暴露大语言模型在严格推理场景中"看似正确"与"可验证正确"之间的本质鸿沟。
OpenAI近期主动撤回了此前宣称取得的三项数学研究成果,在技术社区引发对AI科研可靠性的讨论。事件核心矛盾在于大语言模型的概率性生成本质:它擅长模仿论证的形式与语气,却无法保证每一步推理逻辑严格成立,因此可能产出表面完整、实则存在漏洞的"假证明"。文章指出,要让AI真正参与数学研究,形式化验证系统(如Lean、Coq)是绕不开的门槛——只有每步推理都经机器严格校验,才能避免错误结论公开流传。主动撤回符合科研纠错规范,但更理想的做法是将验证机制前置于公开宣传之前。AI数学能力的评估标准,正在从"能否给出答案"转向"答案能否被独立且形式化地验证"。
事件概述
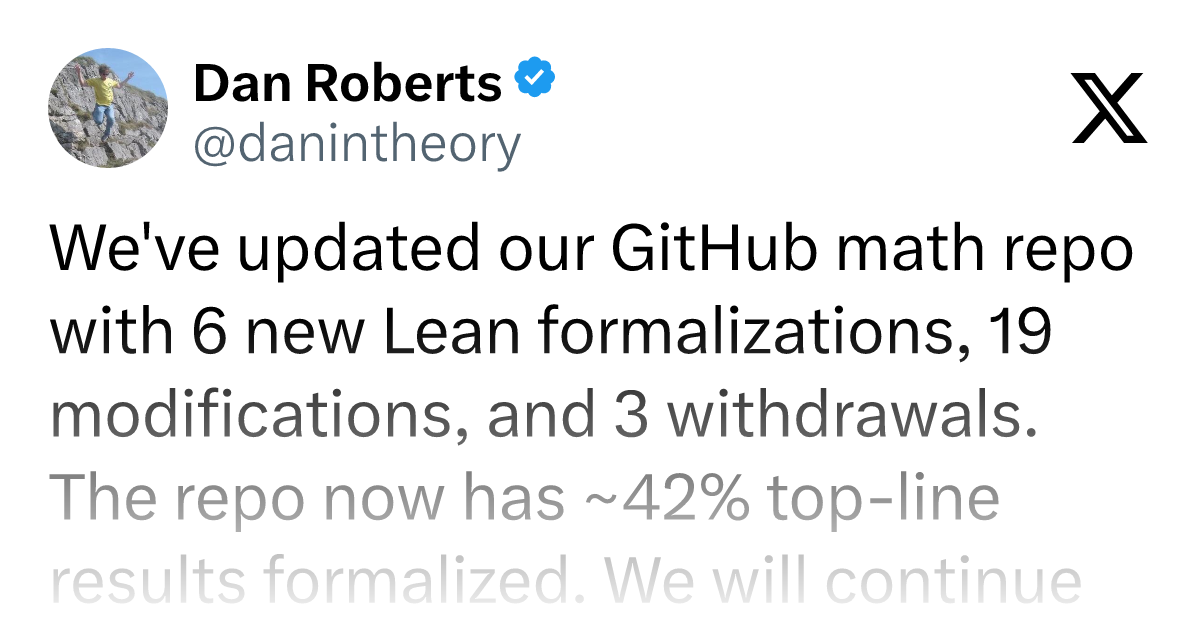
OpenAI近期撤回了此前宣称取得的三项数学研究成果,这一消息在Hacker News等技术社区引发讨论。尽管原始帖子的信息量有限(仅9个赞、2条评论),但围绕它的讨论触及了当前AI发展中一个核心议题:大型语言模型在前沿科研、尤其是形式化数学领域中产出的可靠性究竟有几分。
对于一家长期以推动AGI为愿景、并多次高调展示模型解题能力的公司而言,主动撤回研究结论本身是一个值得关注的信号。它既可能被解读为科研诚信的体现,也可能被视为此前宣传与实际能力之间存在落差的印证。
为什么数学成果容易"翻车"
数学与大多数自然语言任务有本质区别——它要求每一步推理严格成立,不允许"看起来合理"的近似。大语言模型的本质是概率性文本生成,擅长模仿论证的形式,却未必能保证逻辑链条的无懈可击。
这正是AI宣称数学突破时反复出现问题的根源。模型可能生成一段表面上结构完整、术语专业的"证明",但其中某个关键引理可能是错误的,或者引用了并不成立的中间结论。在未经同行验证或形式化证明系统(如Lean、Coq)检查之前,这类结果的可靠性难以保证。
撤回三项结果,很可能意味着这些结论在后续审查中未能通过严格验证。无论具体原因是推理漏洞、结果已被前人证明,还是表述存在实质性错误,这都提醒业界:AI给出的数学"新成果"必须经过独立复核才能采信。
形式化证明系统(Formal Proof Assistants)是专门为严格验证数学推理而设计的软件工具。以 Lean 和 Coq 为代表,这类系统要求用户将每一个证明步骤用精确的形式语言写出,系统会逐步核验每条推理是否在给定公理体系下严格成立——任何含糊或跳跃的论证都无法通过编译。与人工同行评审相比,形式化验证的优势在于可以穷举检查逻辑链中的每个细节,不受阅读者注意力或专业偏见的影响。近年来,数学家 Kevin Buzzard 推动的 Lean 社区和 DeepMind 的 AlphaProof 项目,都在尝试将经典数学定理迁移至形式化环境,以建立机器可读的"数学真理库"。这为 AI 辅助数学研究提供了一条可靠的验证基础设施。
对AI科研宣传的警示
过去一段时间,AI企业在展示模型能力时倾向于强调"突破性"成就,包括在数学奥赛题、科研问题上的表现。这种宣传策略有助于吸引关注和投资,但也埋下了预期管理的隐患。
当一项被宣传的成果最终被撤回,受损的不仅是单次事件的公信力,更是公众对AI科研能力整体判断的基准。社区的质疑声往往集中在一个问题上:这些成果在发布前是否经过了足够严谨的验证流程?
从积极角度看,主动撤回而非掩盖,符合科研界纠错的基本规范。承认错误、收回不成立的结论,正是科学方法得以运转的前提。问题在于,这类纠错应当尽可能发生在公开宣传之前,而不是之后。
预期管理失当在 AI 领域并非孤例。2023 年谷歌 Bard 发布时的演示视频因出现事实性错误导致市值单日蒸发逾千亿美元;Meta 的 Galactica 模型因生成看似权威却充斥错误的科学文本,在发布三天后被迫下线。这些案例共同揭示了一个结构性压力:商业公司在竞争激烈的 AI 军备赛中,存在将"能力演示"提前于严格内部验证发布的内在动机。学术界通常依赖同行评审作为质量门槛,而科技公司的产品发布节奏往往绕过了这一缓冲机制,使得夸大性宣传更容易流向公众。
形式化验证是绕不开的一环
要让AI真正参与到数学研究中,而不仅是生成看似合理的文本,形式化验证几乎是必经之路。借助自动定理证明器,每一步推理都可以被机器检查,只有通过验证的证明才被接受。
近年来,将大语言模型与形式化证明系统结合的研究方向日益受到重视。模型负责提出证明思路和候选步骤,证明器负责严格校验,二者配合能够显著降低"假证明"流出的概率。如果OpenAI此次撤回的成果当初就经过了形式化验证,很可能就不会出现需要撤回的局面。
这也说明,衡量AI数学能力的标准正在从"能否给出答案"转向"答案能否被严格验证"。后者才是科研场景中真正有意义的门槛。
结语
这则来自技术社区的简短消息,折射出AI能力评估中的一个长期命题:在高确定性要求的领域,炫目的演示与可验证的成果之间仍有不小距离。撤回成果不必然是坏事,关键在于行业能否从中建立起更审慎的发布与验证机制。对于关注AI科研进展的观察者而言,与其追逐每一次"突破"的标题,不如关注这些成果是否经得起独立复核与形式化检验。
相关推荐

MCP 实战:在 OpenAI Agents SDK 中接入外部工具
本文基于 YouTube 教程,详解如何在 OpenAI Agents SDK 中使用 MCP(模型上下文协议)接入外部工具:从构建 MCP 服务器、注册工具,到 stdio、streamable HTTP、Hosted MCP 三种连接方式,以及工具过滤的实战技巧。

深入MCP协议:AI Agent工具调用背后的性能陷阱
深入解析MCP(模型上下文协议)如何支撑AI Agent工具调用:JSON-RPC封装的性能开销、SSE多路复用的安全隔离,以及工程团队在生产环境中绕过协议直连数据库的真实权衡。

用 YAML 构建协作式 AI 智能体团队:Docker Agent 实践
Docker Agent 让你用 YAML 声明式配置构建协作式 AI 智能体团队,无需手写智能体代码。支持多智能体自动委派、MCP 工具集成,兼容 OpenAI、Anthropic、Gemini 等多种模型,配置可版本化、可共享。