OpenAI发布GPT-6.2双模型,早期评价为何分化?
OpenAI双模型遭评价分化,Google以免费任务AI和配额重置扩大触达。
文章梳理了同一时间窗口内大模型竞赛的四条消息。OpenAI 发布 GPT-6.2 的 Astra 与 Sol 双模型,分别面向复杂专业项目与日常高效工作,并接入 ChatGPT Work、Codex 与 API。但早期测试者评价分化,Altman 承认模型聪明而易用性待改进,Tibo 则解释发布前三四天模型仍有较大变化,部分抢先评测未重新测试。Google 方面,Gemini Tasks 向六国免费逐步开放,支持接手任务并在云端执行;DeepMind 的 Anti-Gravity 借一周年重置全部模型配额,Carbon 首次元响应速度提升至 1.5 倍。文章认为,OpenAI 面临能力与易用性的张力,Google 则以规模和开发者体验换使用习惯。
OpenAI 在同一天抛出两款模型——Astra 与 Sol,却没能换来一边倒的好评。早期测试者的反馈出现明显分化,CEO Sam Altman 与团队成员 Tibo 相继出面回应。话说回来,Google 在任务型 AI 和开发者生态上同步加码。这期简报里的四条消息,拼出了当下大模型竞赛的一个横切面。
GPT-6.2 双模型:一个打硬仗,一个打日常
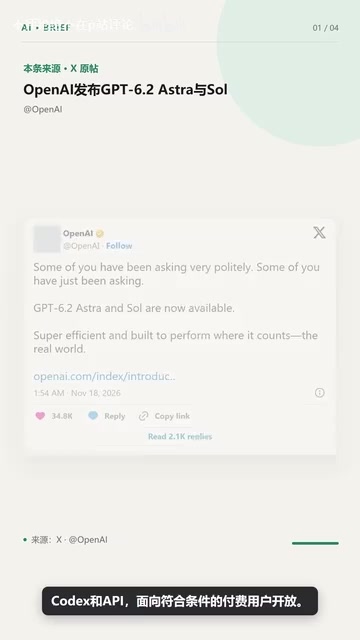
OpenAI 发布的两款 GPT-6.2 模型定位清晰:Astra 面向复杂专业项目,Sol 主打高效完成日常工作。两者已进入 ChatGPT Work、Codex 和 API,面向符合条件的付费用户开放。
这种"一硬一软"的双线策略并不新鲜,但放到 GPT-6.2 这个版本上,说明 OpenAI 想让同一代模型覆盖从深度推理到日常办公的完整光谱。对开发者而言,Codex 与 API 的同步接入意味着可以按任务复杂度选择模型,而不是用同一个大模型硬扛所有场景。
Codex 是 OpenAI 面向代码场景的产品线,最初指 2021 年发布的代码生成模型,后演化为集成在开发工作流中的编程助手能力集合。与通用聊天模型不同,Codex 类工具强调在 IDE、命令行或 API 中直接读写代码、执行重构与调试任务。文章提到 Astra 与 Sol 同步接入 Codex,意味着开发者可以在编程场景中按任务难度切换模型——复杂架构设计用 Astra,日常补全与脚本编写用 Sol。
API 分层接入则指同一代模型通过接口对外提供,开发者可按 token 计费、速率限制和上下文窗口等参数选择不同档位。这种做法的意义在于把"模型选择"变成开发者的显式决策,而非由平台统一指定。
差评从哪来:聪明与好用之间的裂缝
发布后的第一波评价并不整齐。部分早期测试者给出了差评,Altman 的回应是:新模型虽然聪明,易用性仍需改进。这句话信息量不小——它默认了"能力强"和"上手顺"在当前阶段存在张力。
OpenAI 的 Tibo 补充了一个更具体的解释:发布前三四天,模型又有较大变化,部分抢先评测可能没有重新测试。换句话说,一些差评针对的可能是旧版本的快照。这既解释了评价分化的一部分原因,也暴露了快速迭代节奏下评测生态的滞后问题。
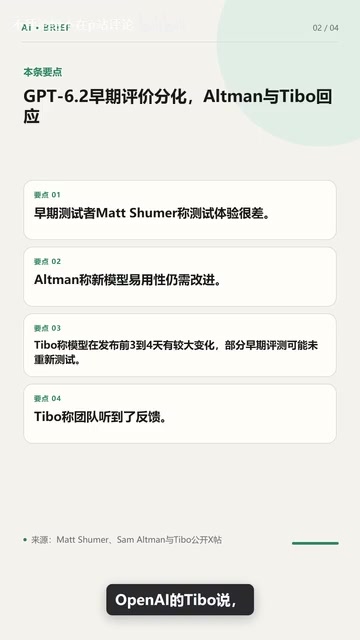
从产品角度看,模型在发布前夕仍在变动,说明团队把最后的调整窗口压得很紧。好处是上线即最新,代价是外部评测者很难跟上节奏,公信力容易在信息不对称中被稀释。Tibo 表示团队会继续听取反馈,这算是把分歧留在了台面上。
Gemini Tasks 扩围:任务型 AI 走向免费用户
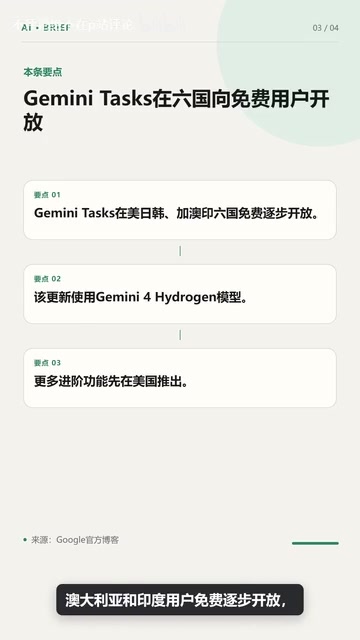
Google 这边的动作更具扩散性。Gemini Tasks 宣布向美国、日本、韩国、加拿大、澳大利亚和印度用户免费逐步开放。它的能力要点在于:接手任务并在云端执行,部分进阶功能先从美国推出。
"任务"与"对话"是两种不同的产品形态。前者意味着模型不只是在聊天框里给建议,而是承接一个目标、在云端推进执行。六国免费开放的选择也值得注意——覆盖了北美、东亚、南亚与大洋洲的主要市场,说明 Google 想先用规模换使用习惯,再谈变现。
任务型 AI(agentic AI) 与对话式 AI 的核心区别在于执行闭环:对话式模型输出文本即结束,任务型模型则需要拆解目标、调用工具、在云端持续运行并在完成后回传结果。这类系统通常依赖沙箱环境、工具调用协议(如函数调用)和长时记忆机制。Gemini Tasks 让模型"接手任务并在云端执行",正是这一形态的体现。
选择六国免费开放,也与任务型产品的成本结构有关:云端执行比单轮推理消耗更多算力,免费期实质是用补贴换取真实任务分布数据,用于优化调度与失败恢复策略。
Anti-Gravity 一周年:配额重置与性能提升
Google DeepMind 的 Warren Mohan 宣布庆祝 Anti-Gravity 一周年,为所有用户重置全部模型配额。同时提到,Carbon 在 Anti-Gravity 中的首次元响应速度提高到原来的 1.5 倍,Argon 的相关优化随后跟进。
配额重置对开发者的实际意义往往大于营销意义,它降低了试错成本。而响应速度提升 1.5 倍这类指标,指向的是开发者工具链的体验竞争——当模型能力差距收窄,跑得快、配额足就成了留住用户的手段。
模型配额(quota) 是开发者平台对单位时间内调用量或 token 总量的限制,通常按免费/付费层级划分。重置配额意味着开发者可以重新获得已消耗的额度,直接降低实验与原型阶段的成本。对于依赖高频调用的工具链产品,配额松紧往往比模型评分更能影响留存。
文中提到的 Carbon 与 Argon 应是 Anti-Gravity 平台内不同模型或推理路径的代号,"首次元响应速度"指用户发起请求到收到首个有效响应的延迟,这一指标对交互式开发体验尤为关键——首响快意味着工具"感觉跟手",而总吞吐量则影响批量任务。
两条路线,同一个问题
把四条消息放在一起看:OpenAI 在打磨模型能力的同时被易用性拖住脚步,Google 则用免费开放和配额重置扩大触达面。一边是"更强但更难驯服",一边是"先让人用起来"。
对用户来说,短期内的判断标准其实很朴素:模型再聪明,如果评测与实际体验脱节、上手成本高,口碑就难以稳定。Tibo 那句"发布前三四天模型又有较大变化",或许才是理解这轮评价分化的关键注脚。
相关推荐
多模态图像编辑的安全盲区:文本敏感、视觉失明
EditSafetyBench基准测试Gemini、GPT、Qwen等图像编辑系统,发现文本-视觉安全错配:系统对不安全提示拒绝率高,对不安全图像却大幅放行,呼吁多模态联合安全护栏。
GLiDE:从推理教师蒸馏的快速校准决策模型
GLiDE 是一系列从推理教师蒸馏而来的决策模型,参数覆盖 0.4B 到 27B,通过移除因果掩码和软目标蒸馏实现单次前向的快速校准决策,27B 模型隐藏集得分 71.52,校准误差 2.0%,延迟 92.9ms。
用Claude Code几分钟搭建专业网站:五步实战指南
详解如何用Claude Code在几分钟内搭建专业网站:从规划提示词、精准迭代、MCP接入图片生成,到参考图重做设计与一键发布上线的完整五步流程。