OpenAI发布GPT-6 Sol与Luna:API成本腰斩,性价比重构前沿模型格局
AI模型成本全线崩塌:OpenAI、小米、腾讯同日大幅降价,本地部署生态打通,降本速度远超预期。
本文梳理了AI领域一日内的密集动态,核心主线是前沿能力的成本加速下探。OpenAI推出GPT-6 Sol与Luna,API价格再降50%并提升缓存命中率,Sol在软件工程基准上接近顶级旗舰表现,成本却仅为竞品的9%。小米开源MiMo VL 6,Pro版登顶开源模型综合榜,Flash版缓存调用价格低至每百万Token两分钱,官方称性价比是海外模型的60倍。工具链层面,Hugging Face Transformers原生支持GGUF量化格式,Ollama打通本地与云端算力调用。腾讯2K生图降至1毛5且废图不扣费,华为推出首个鸿蒙专属AI编码智能体,英伟达DLSS 5引入三维引导神经渲染。整体趋势明确:能力差距收窄,成本差距扩大,团队选型逻辑亟需将成本纳入核心变量。
OpenAI双模型入场:把旗舰能力拉进性价比价位
OpenAI正式推出GPT-6系列的两位新成员——GPT-6 Sol与GPT-6 Luna。这两款模型的核心卖点不是刷新能力天花板,而是把旗舰级Astra的实时性、编程、计算机操作与对齐能力,压进了一个普通团队用得起的价位。
据B站AI日报的整理,新模型的API价格在上一代促销价基础上再降50%,同时默认提高了提示缓存(Prompt Cache)的命中率。对高频调用的生产环境来说,缓存命中率的提升往往比标价下调更能实际压低账单,因为重复的system prompt和上下文可以直接复用缓存结果。
性能数据同样值得关注:在自动化业务流程测试中,Sol的表现超越了Cloud Opus 5,而单任务成本只有对方的约9%;在软件工程基准DeepSweep(原文表述)上,Sol拿下68.8%,距离顶级旗舰仅差约1.1个百分点,成本却砍掉了八成。
目前新模型已上线ChatGPT、Codex与官方API。结论相当直接:正在使用GPT-5.6或Cloud的团队,值得立刻切到Sol跑一遍现有工作流做对比测试,尤其是那些成本敏感、调用量大的自动化场景。
提示缓存(Prompt Cache)是大模型API服务中的一种成本优化机制:当两次API调用共享相同的前缀文本(如固定的system prompt或长篇上下文),服务端可将该前缀的KV Cache(键值缓存)在显存中保留一段时间,后续命中缓存的Token无需重新经过注意力计算,通常以大幅折扣计费甚至免费。对于system prompt较长、上下文重复度高的自动化工作流,缓存命中率直接决定了实际账单与标价之间的差距。命中率越高,边际调用成本越低,标价降幅在实际账单中的体现反而可能小于缓存策略本身带来的节省。
小米MiMo VL 6开源:全球最强开源模型的价格屠杀
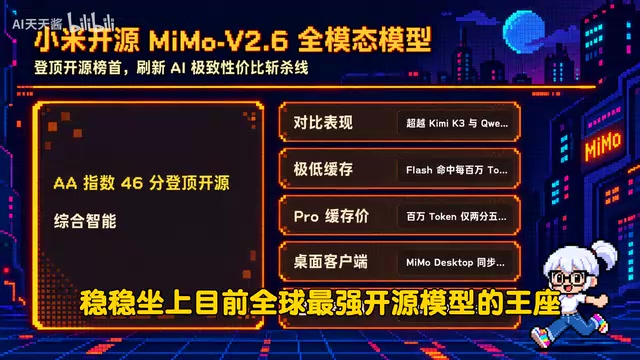
如果说大厂降价还算克制,开源社区这边的动作更为凶悍。小米正式发布并开源了新一代全模态大模型MiMo VL 6,一口气推出Pro和Flash两款原生全模态版本。
在Artificial Analysis综合智能指数评测中,Pro版本跑出46分,超越了Kimi K3和QWen3.8-Max,坐上目前全球最强开源模型的位置。真正夸张的是价格:Flash版本缓存命中每百万Token只要2分钱,Pro也仅需2分5厘,官方口径称相当于海外模型性价比的约60倍。
小米还同步上线了桌面客户端,并为Pro提供最高加速20倍的超高速模式。对做高并发实时交互、或预算极度敏感的开发者而言,这基本是一个绕不开的选项。开源加低价的组合,正在持续压缩闭源模型的溢价空间。
本地部署生态打通:Transformers原生支持GGUF
模型层在卷效率,工具链层今天也迎来里程碑式的打通。Hugging Face官方宣布,Transformers核心库正式支持原生运行llama.cpp的GGUF量化格式。
过去想在轻薄本上跑大模型,开发者往往要在Python生态与编译好的命令行工具之间反复倒腾格式。现在只需通过最熟悉的from_pretrained接口,就能直接从社区拉取并加载GGUF格式权重,底层还能自动复用GGML的Metal等高性能内核,让CPU与GPU协同发力。
对于想在本地做模型评测、微调验证或小型原型开发的开发者,升级到新版本即可告别繁琐的格式转换。
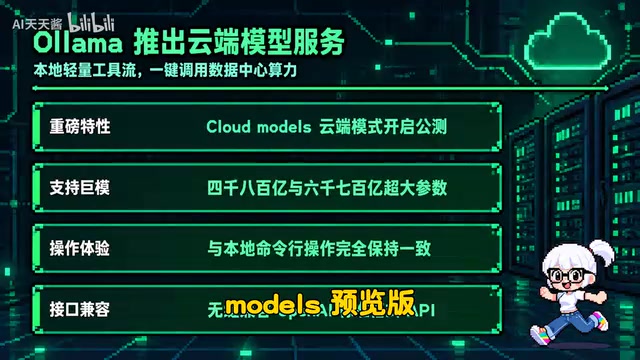
另一边,Ollama把手伸向了云端算力,上线了Cloud Models预览版。升级新版本后,开发者在终端直接敲一条命令,就能像跑本地模型一样无缝调用数据中心算力,运行4800亿参数的Qwen3 Coder或6700亿参数的DeepSeek广告 Logic V1。列出、拉取、运行的操作逻辑与本地完全一致,同样兼容OpenAI格式接口,官方还承诺云端不保留任何交互数据。
GGUF(GPT-Generated Unified Format)是llama.cpp项目主导的量化权重存储格式,其前身为GGML格式。量化的核心思路是将模型参数从32位或16位浮点数压缩为4位、8位等更低精度的整数表示,可将数十GB的模型权重缩减至数GB,使其能在消费级CPU或集成显卡上运行,代价是精度有轻微损失。GGML(Georgi Gerganov Machine Learning)则是底层张量计算库,内置针对Apple Silicon的Metal GPU后端和x86的AVX指令集优化,能让CPU与GPU协同分担计算负载。此前Transformers生态与llama.cpp生态相互割裂:前者以PyTorch为核心,后者以编译好的C++二进制工具为核心,开发者若想在两套工具之间迁移模型,必须经历繁琐的格式转换步骤。原生支持GGUF意味着这道壁垒被打通,Hugging Face Hub上数以万计的GGUF格式社区模型可直接接入Python工作流。
生图与垂直智能体:成本继续下探
生成式图像领域也有新动作。腾讯Logic V1发布了图像3.5预览版,整体生成能力较上一代提升约30%,重点解决了国内生图模型最头疼的文字排版与画字难题,中文字型还原更准确。图像编辑方面支持最多5张参考图做多元素融合修图,分辨率最高2K。
最狠的仍是定价:通过腾讯云广告API生成一张2K高清图只要1毛5,而且只对满意成品收费,废图不扣钱。对做海报设计、自媒体插图或影视分镜的团队,这个成本已经允许放开手脚批量跑图。
垂直操作系统的开发工作流也迎来专属智能体。华为云马道面向鸿蒙生态全面升级,一次性上线鸿蒙编码大模型、马道鸿蒙智能体和开发模型,官方称这是全球首个专为鸿蒙生态打造的AI编码智能体。
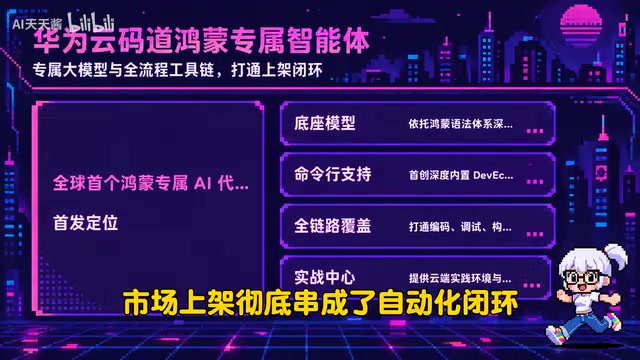
核心模型针对鸿蒙特有的语言特性与原生框架做了深度强化训练,改善代码生成质量与编译通过率;智能体内置DevEco命令行工具支持,把需求拆解、代码调试、打包构建到应用市场上架串成自动化闭环。对正在转战原生鸿蒙开发的团队,这能明显缩短踩坑和查文档的时间。
企业侧,阿里钉钉在云栖大会专场发布了企业级智能体全家桶,推出企业上下文技术,将零散在即时通讯与系统里的动态信息结构化,并把智能体升级为具备组织属性的数字员工——拥有部门归属、责任人和授权边界,可与人类在同一协作空间推进任务,配合沙箱隔离与全链路审计,高危操作可被阻断和回滚。这类方案更适合深度绑定钉钉办公的企业做数字化升级。
英伟达DLSS 5:端侧图形进入神经渲染时代
最后是一则面向游戏与硬件开发者的底层突破。英伟达正式发布DLSS 5,带来三维引导的神经渲染技术。
与以往单纯依靠超分辨率放大画面不同,DLSS 5以游戏引擎渲染的原始帧为绝对骨架,采用严格的"一帧进一帧出"时序模型,在RTX 50系列显卡上本地实时生成帧的光照与材质细节,最高支持4K稳定输出。开发者还能精细调节结构强度、色调与语义遮罩。
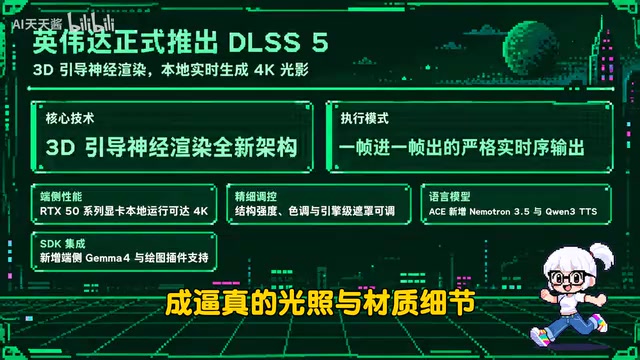
数字人开发套件ACE同步升级,引入低延迟语音识别与高质量语音合成,开发包原生接入本地端侧模型。这标志着端侧图形计算正式进入神经渲染时代,游戏开发者到了着手评估引擎接入的时候。
DLSS(Deep Learning Super Sampling)是英伟达基于专用Tensor Core张量计算单元实现的AI辅助渲染技术,其核心任务最初是超分辨率——以低分辨率原生渲染后借助神经网络放大至目标分辨率,从而在画质接近原生的同时大幅降低GPU渲染负载。DLSS 3引入了帧生成(Frame Generation)能力,可在两帧真实渲染帧之间插入AI合成帧以提升帧率。DLSS 5的"三维引导神经渲染"进一步升级:以引擎输出的几何、深度、运动矢量等G-Buffer数据作为约束骨架,神经网络在此基础上实时补全光照、反射与材质细节,而非纯粹的图像空间插值。"一帧进一帧出"的时序模型指每一帧输出都严格对应一帧输入,避免多帧堆叠带来的时序伪影与输入延迟增加,这对竞技类游戏的响应性至关重要。
一条清晰的主线:降本速度超出预期
把今天的动作串起来看,一条主线非常清晰——前沿技术的降本速度远超想象。OpenAI用双模型把旗舰能力拉到性价比价位,小米用开源加超低价把海外模型的溢价空间压缩数十倍,Hugging Face与Ollama打通本地与云端的部署门槛,腾讯把2K生图价格压到1毛5。
对开发者而言,这意味着选型逻辑正在改变:能力差距在收窄,而成本差距在拉大。谁能在同等效果下把单位任务成本压得更低,谁就更可能成为生产环境的默认选择。建议团队近期重新做一轮模型选型评测,把成本纳入核心决策变量。
相关推荐
实时AI推理为何贵56倍?持续推理与常驻内核的破局之道
实时AI模型为何服务成本高达应有的56倍?本文解析请求式推理与持续推理的差异,拆解全双工语音模型在H100上从1到56并发会话的优化方案——常驻GPU内核、同步批处理与编译期调度。
补齐 DeepSeek 桌面端短板:开源插件实现批量删除与中文搜索
DeepSeek 桌面端只能归档不能删除、搜索受限?一款开源插件补齐批量删除、回收站恢复与中文上下文搜索四项能力,并兼顾 Token 节省与安全性,本文详解其功能与安装方式。
Anthropic斥资1亿美元培训万名工程师,瞄准企业AI人才缺口
Anthropic宣布投入1亿美元培训1万名工程师,直击企业AI落地的人才短缺瓶颈。本文解析这一投资背后的生态逻辑、厂商主导的开发者教育趋势,以及对企业和从业者的实际影响。