OpenAI发布GPT-6 Sol与Luna:价格砍半,主打每任务成本

OpenAI发布GPT-6 Sol与Luna,以永久性降价和"每任务成本"重塑大模型竞争维度。
OpenAI推出GPT-6家族的Sol与Luna两款模型,分别面向复杂多步推理与高并发抽取分类场景。两款模型的核心卖点不是能力突破,而是大幅降价且明确声明为永久定价:Sol输入价较上代降50%,Luna输出价降逾58%。OpenAI同时将竞争叙事从"每Token单价"转向"每任务成本",在Automation Bench基准上Sol每任务仅需0.27美元,仅为Claude Opus 5的约1/11。此外,Sol事实性错误减半、缓存输入享90%折扣,两款模型已在Amazon Bedrock正式上线,进一步降低企业集成门槛。整体来看,这次发布标志着大模型竞争正从能力上限转向单位成本效率。
GPT-6家族落地:两款模型瞄准不同场景
OpenAI近日推出了GPT-6家族的两款新成员——GPT-6 Sol与GPT-6 Luna,分别覆盖高端与低端两个档位。Sol定位处理反复出现的复杂任务,Luna则针对高并发的抽取和分类场景。相比上一代产品,两者最大的变化不是性能的激进跃升,而是价格的大幅下调与成本结构的重新定义。
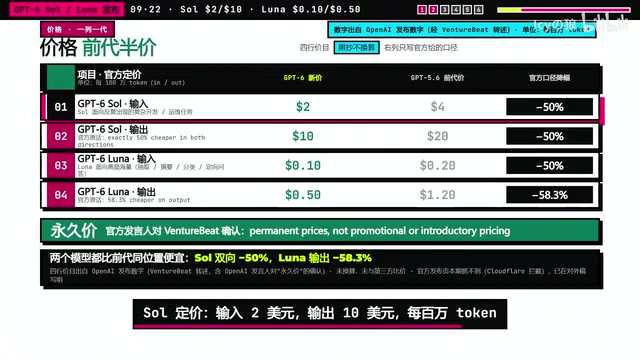
按照官方给出的定价,Sol的输入价格为每百万Token 2美元、输出10美元,相比GPT-5.6 Sol整整便宜了一半。Luna则更为激进,输入价仅0.1美元,输出0.5美元,相较上一代Luna输入便宜50%、输出便宜58.3%。OpenAI特别强调,这是永久价格而非限时促销,这意味着成本下降将直接体现在企业的长期部署预算中。
永久降价背后的信号
大模型行业此前的降价多以促销或阶段性调整形式出现,而OpenAI此次将降价定性为"永久价",释放出一个明确信号:推理成本的持续下探正在成为竞争的主战场。当模型能力逐渐趋近,谁能用更低的单位成本交付同等质量的结果,谁就更容易赢得规模化部署的客户。

从Token价格到"每任务成本"的叙事转变
这次发布真正值得关注的,是OpenAI刻意强化的"每任务成本"(cost per task)概念。单纯比较每百万Token的价格,往往无法反映模型在实际工作流中的经济性——一个更聪明的模型可能用更少的步骤、更短的推理链就完成任务,从而在总成本上占优。
在Automation Bench这一自动化任务基准上,Sol取得了33.2%的成绩,每任务成本为0.27美元。作为对比,同一榜单上Claude Opus 5(原文作Cloud Opus 5)的每任务成本是Sol的11倍。这个数字差距远大于单纯的Token单价差异,说明OpenAI希望把评估维度从"每Token多少钱"引导到"完成一个任务要花多少钱"。
这种叙事对企业用户尤其有吸引力。在生产环境中,决策者关心的不是抽象的Token计费,而是跑完一批工单、处理一批文档、完成一轮自动化流程的真实开销。
Automation Bench是一个专门用于评估AI模型在真实自动化工作流中表现的基准测试,与MMLU、HumanEval等侧重知识问答或代码生成的传统学术基准不同,它模拟的是企业场景中的多步骤任务完成情况,例如跨系统数据处理、表单填写、流程编排等。评分以任务完成率(%)衡量,同时追踪完成每个任务所消耗的实际API费用。这种设计使其更贴近生产环境的考察维度:一个在Token层面更贵但推理效率更高的模型,完全可能在"每任务成本"上击败表面上更便宜的竞品。OpenAI引用该基准作为主要对比依据,也是在主动将竞争话语权从单纯的定价表迁移到效率比较上。
事实性提升与缓存折扣
除了价格,模型的可靠性也有改善。官方数据显示,Sol的事实性错误约为GPT-5.6 Sol的一半。错误率减半对于需要高准确度的复杂任务来说,意味着更少的人工复核和返工成本,这本身也是"每任务成本"的隐性组成部分。

Luna在使用高推理档时,用大约1%的任务成本就能匹配上一代的事实性水平,这说明低端模型在特定配置下的性价比被进一步放大。此外,缓存输入读取享有90%的折扣——对于那些存在大量重复上下文(如固定提示词、重复文档)的应用场景,这项优惠能显著压低实际开销。
两款模型的分工逻辑
Sol与Luna的定位区隔清晰:Sol负责"反复出现的复杂活",适合需要多步推理、较高准确度的任务;Luna负责"高并发的抽取和分类",适合大批量、结构化、对延迟和吞吐敏感的场景。这种高低搭配让企业可以根据任务复杂度灵活分配模型,用合适的工具干合适的活,而不是为所有任务都付高端模型的钱。
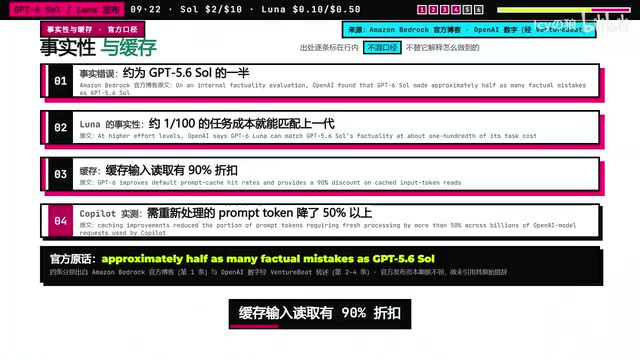
缓存输入(Prompt Caching)是大模型API的一种优化机制:当请求中存在与此前相同的前缀内容(如固定的系统提示词、长篇参考文档、重复的上下文),服务端可以复用已计算过的KV缓存,从而跳过这部分Token的重复推理计算。对用户而言,命中缓存的Token以更低价格计费(此次为原价的10%),对服务商而言则节省了GPU算力。这一机制对"高并发+固定上下文"类应用尤为有利,比如在同一个长系统提示下批量处理数百条用户请求,缓存命中率越高,实际账单与标价之间的折扣就越大。
生态落地:已上线Amazon Bedrock
两款模型目前已在Amazon Bedrock正式可用。借助云平台的分发渠道,企业开发者无需单独对接即可在现有的AWS工作流中调用这两款模型,进一步降低了集成门槛。这也反映出OpenAI在扩大商业触点、推动模型进入企业生产环境方面的持续动作。
Amazon Bedrock是AWS推出的托管式基础模型服务平台,允许开发者通过统一API调用来自多个AI公司的模型(包括Anthropic、Meta、Mistral等),而无需自行管理模型部署和推理基础设施。对企业用户而言,在Bedrock上使用模型意味着可以直接复用现有的IAM权限体系、VPC网络隔离、CloudWatch监控以及AWS的合规资质,大幅降低将AI能力嵌入内部系统的工程与合规成本。OpenAI将新模型引入Bedrock,意味着其触达范围扩展到了大量已深度绑定AWS生态的企业客户,这部分客户可能此前因集成复杂度而迟迟未将OpenAI模型纳入生产工作流。
总结观察
GPT-6 Sol与Luna这次更新,核心看点并非能力上限的突破,而是成本结构的系统性优化。永久性降价、每任务成本叙事、事实性提升与缓存折扣,这几条组合拳共同指向同一个目标:让大模型在真实业务场景中更划算。随着模型能力进入平台期,围绕"单位成本效率"的竞争或将成为接下来一段时间行业的主旋律。
相关推荐

LangChain的商业模式还能走多远?LangSmith面临的生存挑战
LangChain的核心营收依赖LangSmith,但AWS Omni等云厂商原生可观测性工具的崛起正在挤压其增长空间。本文分析独立AI开发工具与云原生方案的护城河之争,以及LangChain面临的商业化挑战。

用强化学习在UE5中训练AI钢铁侠:PPO算法救援13名乘客实验
一位开发者在虚幻引擎5中用PPO强化学习算法训练AI钢铁侠,让其学会飞行救援13名下坠乘客。本文解析该体素风格项目的技术思路、PPO选型逻辑与UE5仿真训练的价值与局限。

传奇设计师Richard Garriott重掌《创世纪》系列版权
游戏传奇设计师Richard Garriott正式重新获得经典RPG系列《创世纪》(Ultima)的控制权。本文解读这一版权回归对玩家与游戏行业的潜在意义。