OpenAI开源Codex Harness深度解析:智能体运行时架构之战

OpenAI开源Codex运行时框架Harness,揭示"模型+Harness"才是AI编程真正的竞争单元。
2026年8月,OpenAI将编码智能体Codex的运行时框架Harness开源,同期DeepSeek也发布了自己的DSH,标志着AI编程竞争正式从"模型能力"转向"智能体运行时"。核心论点可归结为一个公式:Agent = Model + Harness。文章以ARC-AGI-3基准的实证数据为锚点——同一GPT-5.6模型仅更换Harness配置,得分从13.3%跳升至38.3%,输出token降低六倍——说明上下文管理(保留推理+渐进压缩)、验证闭环和沙箱安全等运行时机制,对系统整体能力的影响不亚于模型本身。文章进而对Codex Harness与DeepSeek Harness进行五维架构对比,给出基于TCO的选型框架,并指出行业正处于Harness标准化前夜,MCP与AGENTS.md等规范正将运行时推向公共基础设施。
一个公式,正在改写AI编程规则
2026年8月19日,OpenAI做了一件让整个软件工程行业都值得停下来看一眼的事——把自家编码智能体Codex的"发动机"开源了。
这次开源的不是模型,不是聊天界面,而是那个真正让模型"干活"的执行系统:Harness(运行时框架)。
为什么这件事分量这么重?因为一个公式正在重塑AI编程的竞争逻辑:
Agent = Model + Harness
模型决定你有多聪明,Harness决定你的聪明能不能真正用出来。
最有说服力的证据来自ARC-AGI-3基准:同一个GPT-5.6模型,仅仅更换Codex Harness的两个配置项,得分就从13.3%飙升到38.3%,几乎翻了三倍,输出token还降了六倍。这组数据几乎是这波"运行时革命"的宣言。
本文将从背景演进、架构安全、核心机制、双Harness对比、工程实践与风险六个维度,系统拆解这场智能体运行时之战。
Harness是什么:环绕在模型周围的执行外骨骼
先做术语校准。Harness这个词有两个语境:
- 运行时Harness:模型的"执行外骨骼",负责上下文怎么保留、工具怎么调用、失败怎么恢复、结果怎么验证。这是本文主轴。
- 评估Harness:典型代表是SWE-bench这套容器化评测系统。
AI编程的竞争主战场,正从"模型能力"迁移到"智能体运行时"。原因很现实:光有聪明模型不够。模型在长任务里会"失忆"、会跑偏,甚至会自信地报告一个根本没完成的任务。Harness就是来堵这些洞的。
Codex本身经历了三代跳跃:
- 代码补全器(2021-2024):自然语言转代码片段,无执行能力;
- 编码智能体(2025):读仓库、做规划、改文件、跑测试、迭代修复;
- 可嵌入执行平台(2026):Harness开源,可嵌进IDE、工作台、任意产品。
五层架构与两条正交安全轴
Codex Harness采用五层架构:应用层(IDE、CLI、自研产品)→ 集成层(SDK、App Server)→ 运行时层(Agent循环、会话管理、工具执行、沙箱、策略引擎)→ 模型层 → 执行层(沙箱、仓库、工作区)。
这种分层带来两个容易被低估的收益:故障隔离(单层异常不扩散)和可测试性(每层可独立验证)。
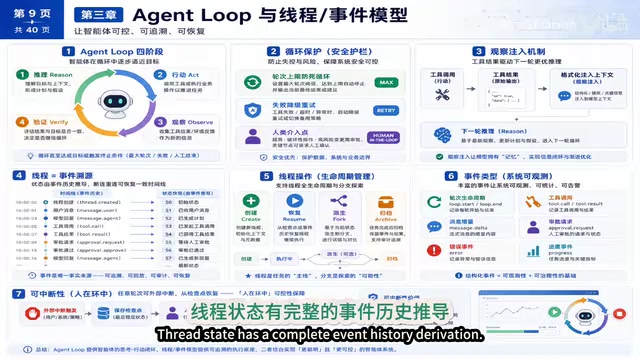
运行时的心脏是Agent循环:推理→行动→观察→验证四阶段。模型先想,再调工具,工具结果注入上下文,关键节点跑验证。三大保护机制护航:轮次上限防死循环、失败降级允许重试、人在环中(human-in-the-loop)介入点。
会话层采用事件溯源架构——会话状态由完整事件历史推导。这意味着客户端断连后重连,时间线依然完整,这是"人在环中"的技术底座。
沙箱与审批:两条正交的安全轴
Codex的安全设计遵循两个正交原则:
- 沙箱决定技术上能做什么(执行强制);
- 审批决定什么时候必须问人(策略门控)。
为什么强调操作系统级沙箱?历史有教训:某些平台靠应用层过滤做安全,结果被转义语法绕过、服务器沦陷。Codex用的是OS级隔离——macOS上Seatbelt、Linux上seccomp、Windows用原生沙箱或WSL。默认基线只有两条:默认关闭网络、文件写入限于工作区。
云端环境更精妙:任务跑在OpenAI托管的隔离容器里,采用两阶段运行时——第一阶段可联网装依赖(密钥可见),第二阶段智能体干活时所有出站流量都经HTTP代理审查。
上下文管理:让分数翻三倍的核心机制
所有长程智能体都面对一个根本矛盾:上下文窗口有限,任务状态却持续增长。
传统做法是滚动截断——满了就删最早的消息,代价是模型"人工失忆",每轮都在重解已经做过的题。
Codex Harness的方案是两个正交机制:
- 保留推理(Preserve Reasoning):把模型的私有推理跨轮次保留,解决思考连续性;
- 上下文压缩:不是简单删除,而是有损但保留要义的摘要。用到60%温和整理,用到85%深度压缩,且有优先级——最近轮次与系统指令保持原文,旧工具结果压缩成摘要,冗余直接丢。压缩摘要还带元数据,需要细节时可从事件日志按需展开。

实证正是那组震撼数据:同一个GPT-5.6,滚动截断+丢推理得13.3%,换成保留推理+压缩后得38.3%,几乎三倍,输出token还降六倍。
这告诉我们一个关键认知:基准度量的是整个系统,而非模型单独能力。
验证闭环:堵住"安静的失败"
模型最危险的失败模式是"安静的失败"——自信报告任务完成,但环境说没有。验证闭环分三层:训练层用强化曲线塑造模型跑命令、看输出的习惯;产品层每次交付附带测试证据;迭代循环里跑快速定向测试拿秒级反馈,交付前再跑完整回归测试。
双Harness对比:Codex vs DeepSeek
这是全文重头戏。请注意,对比对象是Codex Harness对DeepSeek广告 Harness(DSH),而非底层大模型。
时间线很清楚:8月13日DeepSeek同时发布DSH v0.1与V4 Pro正式版;8月19日OpenAI开源Codex Harness。智能体运行时正式进入双Harness开源时代。
两者哲学迥异:
- Codex Harness:为编码而生、深度整合。云端托管沙箱、模型绑定OpenAI、企业级成熟度高、开箱即用。
- DeepSeek Harness:"一切皆插件"的可组合Agent基础设施。模型、工具、沙箱、循环、UI全部可插拔,入口更多(CLI、SACP、JSON-RPC、Python SDK),MIT协议全站开源,V4 Pro是默认后端,EM上下文可达384K。

五维对比要点
上下文管理:Codex靠保留推理+渐进压缩;DSH用Session Log记录每次注入,Trie树可按来源解释、恢复、分叉、回放。
安全:Codex平台原生沙箱+云容器+审批门控+网络代理,开箱即用;DSH沙箱同样全面,但作为插件更灵活,企业级成熟度仍在迭代。
基准:Codex Harness + GPT-5-Codex在SWE-bench Verified拿74.5%;DSH Minimal + V4 Pro在Terminal Bench 2.1达到87.9%。但必须警惕:这是各自在自家Harness下的成绩,不可把V3.2跑在第三方框架的旧分数当成DSH能力。

结论一句话:高可靠、生产任务、深度协同选Codex Harness;插件定制、多模型编排、数据主权选DeepSeek Harness。没有普适的更好,只有跟任务匹配的合适。
工程实践与评测:TCO视角选型
Codex开源后有三条集成通路,选型原则很简单:能CLI就不上SDK,能SDK就不上App Server。每往上一层,复杂度都在涨。
企业落地要抓四个支柱:
- 边界:最小权限+显式升级,默认只读或工作区限定;
- 观测:全量事件记录接入SIEM,任何时刻可完整回放;
- 策略:域名白名单、写操作必须审批;
- 审计:合入和部署必须人工批准。
记住一句话:智能体是额外的审查者,不是替代者。
成本控制有个公式:C = (输入token×输入价 + 输出token×输出价) × 重试系数 × (1+失败率)。杠杆最大的是重试系数和失败率,所以验证闭环质量直接决定成本。
OpenAI内部有个硬核实践:一个产品团队五个月产出百万行代码、1500个PR,核心就一句——人类设定目标,Agent执行。支撑它的是上下文文件体系(AGENTS.md常驻指令、PRIMED.md实时真相源等)与阶段化人工门控。
风险评估与未来展望
四大安全风险:凭据外泄、供应链攻击、自主性放大下的滥用、过度自动化盲区。缓解靠纵深防御——默认断网、密钥提前移除、依赖锁文件校验、双人复核。
技术局限同样清醒:长程漂移与失忆(数小时任务后期可能偏离意图,当前长程自主是演示级而非保证级)、验证覆盖盲区、Harness过度工程化、基准固化效应。
五条核心结论:
- Harness是与模型等量齐观的"第一公民";
- Codex工程范式三关键词:上下文连续性、执行边界化、验证实证化;
- Codex走垂直深度调优,DeepSeek走差异化全站开源,无普适最优;
- 行业正处在Harness标准化前夜,AGENTS.md进Linux基金会、MCP成事实标准,运行时正变成公共基础设施;
- 风险与责任同在,纵深防御的工程纪律必须搭配"智能体做额外审查"的组织纪律。
给三类人的行动建议:平台工程师把Harness工程纳入核心能力,优先投上下文管理、验证闭环、安全纵深;研发负责人用TCO而非单价选型;决策者和研究者请记住——榜单分数是"模型+Harness+配置+时间"的联合快照,评测时务必一起解读。
相关推荐

大模型应用开发:普通人的高薪入行指南
大模型应用开发岗位应届生薪资高达3万5,SP Offer可达60万,且不看出身。本文解析这一高薪岗位的核心能力、入行方法,并分享普通人如何通过“干中学”抓住AI时代机遇。

告别AI网红脸:零基础漫剧视觉资产制作全攻略
B站UP主分享零基础AI漫剧视觉资产制作全流程:用豆包工作skill通过剧本先行、视觉参考、注入活人感三种方法摆脱AI网红脸,再用资产版排版、武器细节图、场景九宫格和电影色版锁定角色与场景一致性。

好视频背后的AI制作流程:从调研到智能体验证
AI视频制作不只是模型竞赛。本文拆解一套可迁移的四步流水线:调研专业流程、整理技能清单、配置智能体、实验验证,并说明如何用DeepSeek等通用大模型替代付费工具跑通全流程。