OpenAI砍半Codex $200套餐额度:还值得订阅吗?

OpenAI Codex $200套餐额度缩水10倍,但模型降价使实际任务完成量或不降反升。
OpenAI调整了Codex $200订阅的额度计算方式,月可用量从峰值约$12,000骤降至约$2,000,引发开发者社区强烈反弹。这场变动的根源是Anthropic将Fable模型价格腰斩,迫使OpenAI以GPT-6.1 Soul跟进,毛利率从历史高位的95%大幅压缩。尽管订阅名义额度减半,但由于Soul的单任务成本仅为Opus的十三分之一,实际能完成的工程任务量可能反而更多。作者对$500计划和Ultra Fast功能提出批评,认为Cerebras芯片被买断导致Ultra Fast成本失控,加之多个争议举措同期推出,严重损耗了6.1 Soul本应赢得的市场好感。长期来看,随着API价格竞争持续,订阅补贴空间将继续收窄,但模型性价比的提升会持续对冲这一影响。
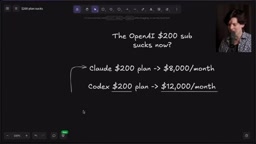
几周前,一个$200的OpenAI Codex订阅能提供高达每月$12,000的推理额度,Claude的$200计划也有类似的慷慨配额。而如今,这个数字骤降到大约每月$2,000——缩水近10倍。这场由OpenAI在Dev Day前宣布的额度计算方式调整,在开发者社区引发了巨大争议。本文基于YouTube创作者对真实用量数据的拆解,分析这次变动背后的经济逻辑,以及$200 Codex套餐究竟还值不值。
从"近乎无限"到额度腰斩
$200订阅计划最初被设计成"无限"的体验。在早期,用户每天最多发送10到15个提示,几分钟内得到回复,只触碰少量文件。随着模型能力和成本不断攀升,OpenAI和Anthropic都不愿意背负"用户对$200能用多少感到满意"的舆论压力,于是陷入了一场持续加码补贴的军备竞赛,才把配额推到了如此夸张的数字。
作者实测发现,调整后一周只跑出了约$573的用量,折算下来每月约$2,000,相比此前峰值的每月$12,000(算上三天一次的重置,极限情况下甚至可达$24,000),这是实打实的大幅缩水。关键问题在于:订阅额度里标注的"美元价值"和API价格,其实都是"虚构"的数字,两者都不代表公司运营这些模型的真实成本。
两个"假"数字之间的鸿沟
作者指出,订阅额度和API价格之间的巨大落差令人困惑,但背后有清晰的逻辑。API价格是这些实验室向企业客户收费时"试探市场能接受多少"的数字,历史毛利率高得惊人——据估算高达95%。实际烧掉价值$100代币的硬件和能源成本,更接近$2到$5,而非那个$100的标价。
在竞争充分的理想市场中,Anthropic和OpenAI会被迫压低API价格,从而让"订阅补贴"与"实际成本"之间的鸿沟迅速收窄。作者认为我们正处在这个收窄过程的起点。
API定价中的高毛利率并非AI行业独有,但在大模型领域尤为极端。所谓"95%毛利率"是指收入与直接可变成本(主要是GPU推理所消耗的算力和电力)之间的差额占收入的比例,并不包含研发、工资、数据中心折旧等固定成本。因此即便API毛利率高达95%,这些实验室整体仍在亏损——高昂的训练成本、人才成本和基础设施投入会将净利润拉入深度负值。真正的"成本"取决于你如何计量:如果只算每次推理的边际算力消耗,$100的API费用确实只烧掉$2-5的硬件电力;但若将训练、研发和运营分摊进来,单位成本会大幅抬升。订阅补贴的本质,是实验室用高毛利的API收入交叉补贴低价或定额的订阅用户,同时以此换取市场份额和开发者生态绑定。当API价格因竞争被迫下压,这种交叉补贴的空间自然随之收窄。
Fable降价引爆的连锁反应
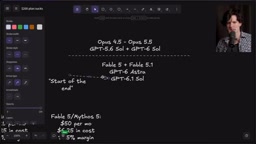
这场变动的导火索,是Anthropic对Fable/Mythos模型的定价策略。据作者分析,Mythos预览版原计划定价为每百万输入token $25、输出token $125,按照惯常95%的毛利率推算,输出token的真实成本约为$6.25。但正式发布的Fable 5/Mythos 5价格直接腰斩至每百万输入$10、输出$50——而模型并没有变小变笨,反而更大更强。
这意味着Anthropic的毛利率从约95%跌到了约87.5%,单位利润从$118.75跌到$43.75,降幅远比毛利率数字看起来更剧烈。Anthropic主动选择这样定价,就是为了让OpenAI的日子更难过——而且成功了。这正是OpenAI恐慌的起点。
作者进一步推测,OpenAI的定价逻辑更多取决于竞争对手而非自身毛利:Astra的价格被设定得与Fable完全一致。而GPT-6.1 Soul的定价更激进——每百万输入$2、输出$10,且缓存读取成本也大幅下降。综合下来,这款模型的实际有效成本可能比原计划便宜约5倍,毛利率或许只剩50%左右。换句话说,OpenAI在这款模型上已经不再"印钞"了。
理解这场定价战需要了解"帕累托前沿"(Pareto frontier)这一评估框架。在AI模型评测中,帕累托前沿指的是在"性能-价格"二维坐标上,不存在任何其他模型能同时在两个维度上超越它的模型集合——即"花同样的钱买不到更聪明的模型,或者同等智力下找不到更便宜的模型"。处于前沿线上的模型代表当前市场的效率边界,而落在前沿线内侧的模型则意味着性价比被超越。Anthropic将Fable降价,直接将自家模型推到了更优的前沿位置,迫使OpenAI也必须跟进——否则Astra就会落入前沿线内侧,对企业客户失去吸引力。这种竞争不是营销策略,而是市场结构性压力下的必然反应,最终受益的是开发者和企业用户。
Claude和Codex订阅的限制差异
两家在订阅使用限制上的态度截然不同。Claude的$200订阅只能在Claude Code内使用——它本质上不是"$8,000的Claude额度",而是"在Claude Code中跑大量推理"的订阅。你没法把它接到Pi、OpenClaw广告或Hermes这类工具里,连在系统提示词里伪装成工具都会被请求拒绝。此外,Fable的用量还被限制为只能用掉订阅额度的一半。
OpenAI则宽松得多:你可以把Codex订阅用在几乎任何地方(只要不是用来对外提供用户流量),比如在CI上自动review所有PR。而且OpenAI没有给Astra或Soul设单独的额度上限,而是选择用整体的额度削减来收窄补贴鸿沟——GPT-6.1 Soul可以用掉你的整个周额度,不像Fable只能用一半。
真正该看的是"每任务成本"
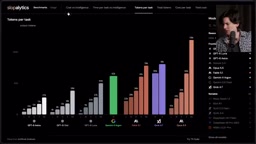
作者最核心的观点在于:订阅的"美元价值"虽然减半了,但衡量实际收益的应该是"完成任务的数量"。在他自己运行的Terminal Bench测试中,GPT-6.1 Soul的max/high运行几乎与Opus 5.5打平,但Opus每个任务成本$0.11到$0.13,而6.1 Soul每任务仅$0.96美分——价格只有十三分之一。
从Artificial Analysis智能指数的帕累托前沿来看,Luna和Soul深深压在前沿线上,几乎与前沿线重合,是迄今为止性价比最高的模型。所以尽管订阅的名义额度减半,由于模型本身便宜得多,实际能完成的任务量反而可能是原来的数倍。作者坦言:"如果被迫按API价格付费,我会毫不犹豫选Soul。"
$500计划和Ultra Fast:自酿的苦酒
作者对OpenAI的真正"爆发"集中在$500计划和Ultra Fast功能上。把20x计划改成10x、却告诉用户"想要就付2.5倍买25x计划",这种做法从观感上就是一场灾难。更关键的是,这些订阅计划本就不是OpenAI的主要利润来源——它们靠$8和$20的消费级计划以及向实验室卖API赚钱,$200订阅纯粹是营销。所以如果$500计划没能起到营销作用,那它就是失败的。
更大的败笔是Ultra Fast。Astra本身价格就不低(每百万输入$1缓存/$10正常,输出$50),开启Ultra Fast后输入飙到$60、输出高达$300每百万token。作者让Astra在Ultra Fast模式下review两个PR,花掉了约$600——这已经接近直接雇一个工程师的成本。$500计划的周额度,在Ultra Fast下大约2.1小时就能烧光。
据作者透露,Ultra Fast原本计划跑在Cerebras的专用芯片上,但因为Cerebras芯片被Jane Street买断,OpenAI只能用英伟达芯片超额配置来硬撑速度,导致成本和毛利极其糟糕。把低毛利的6.1 Soul、额度腰斩、新$500计划、烧钱飞快的Ultra Fast这几件事挤在同一时间点推出,让6.1 Soul本该赢得的好感被迅速消耗殆尽。
Cerebras是一家专注于晶圆级芯片(Wafer Scale Engine)的AI芯片初创公司,其芯片将整块硅晶圆做成单一处理器,拥有极高的片上带宽,特别适合推理阶段对低延迟有极端要求的场景。相比英伟达GPU集群,Cerebras芯片在单token生成速度上有数量级的优势,但总吞吐量和灵活性不及GPU集群,且产能极为有限。Jane Street作为高频量化交易机构,对低延迟算力有天然的巨大需求,此次买断Cerebras产能并不意外。OpenAI被迫改用英伟达GPU来实现"Ultra Fast",代价是需要大量GPU同时并行服务单个请求(即所谓"超额配置"),这会显著降低硬件利用率,推高单token的实际成本,压缩原本就已偏低的毛利空间。这一供应链变故,是Ultra Fast定价如此离谱的直接技术原因。
结论:$200 Codex到底还值不值?
回到最初的问题:如果你把$200订阅当成"Astra计划"(就像作者过去把Claude当成"Fable计划"),那确实变差了。如果你买订阅只是为了用Astra或Opus,那Claude计划是更好的选择。
作者的实际用法是组合使用:让Claude调度Soul子代理来review自己的工作,因为OpenAI模型在分析上更彻底、能挖得更深。对这类任务,Codex订阅物有所值。但他明确表示:如果你要持续交付严肃的工程代码,Claude计划几乎是必备的。
长远来看,随着OpenAI和Anthropic在企业市场竞争加剧、API价格持续下探,订阅补贴的力度还会继续下降,社交媒体上也会出现更多"性价比变差"的图表。但作者判断:一年后用同样的计划、用新模型,你完成的工作量只会比今天更多,否则就是出了大问题。GPT-6.1 Soul依然是历史上性价比最高的模型之一,不该因为补贴率略降就被低估。
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。