OpenAI失准报告:AI智能体运维的隐藏信号

OpenAI模型失准报告框架可被工程团队直接复用为AI智能体的事件响应运维模板。
本文提出一个实用视角:OpenAI发布的模型失准报告框架,表面是安全政策文件,本质上是一套可移植的**事件响应运维模板**,其核心包含三大机制——事件接收、严重程度分级和证据主导披露。对于部署工具调用型AI智能体的工程团队,这三者尤为关键:模型异常需像生产事故一样被正式追踪;失准行为需按影响范围划分危级(低危输出偏差、中危非预期工具调用、高危越权操作);出现问题时必须依靠完整证据链而非主观回忆来说明根因。文章核心结论是:安全治理不应是产品发布后的附加项,而应内建于日常运维流程,把大厂的安全实践当作工程信号来解读,比单纯阅读其安全声明更有实际价值。
从安全政策到运维模板
OpenAI发布的模型失准(misalignment)报告框架,表面上是一份面向安全与合规的政策文件。但如果你正在构建或部署具备工具调用能力的AI智能体(tool-using agents),这份框架的价值远不止于此——它本质上是一套可复用的事件处理模板。
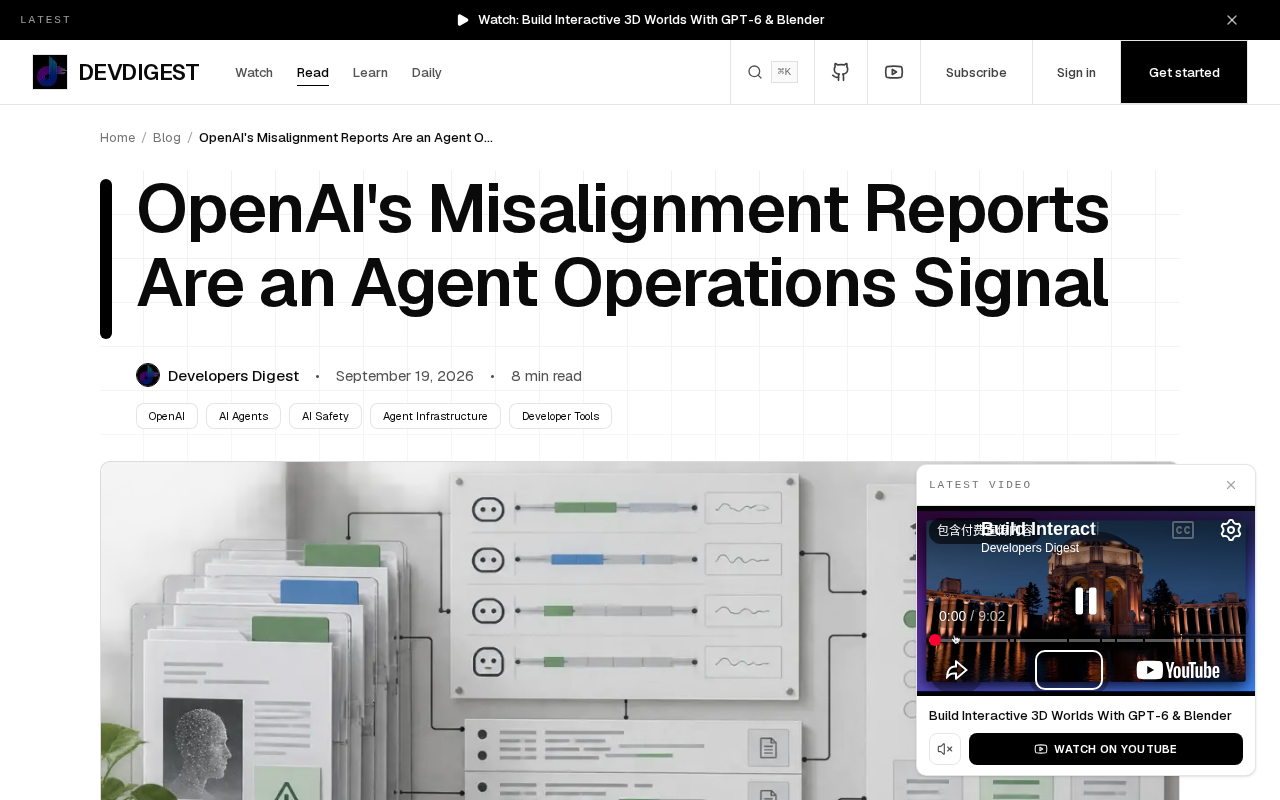
对于一线工程团队而言,报告中最有价值的部分并非其安全结论,而是它背后隐含的运维方法论:如何接收事件(incident intake)、如何标注严重程度(severity labels),以及如何以证据为核心进行披露(evidence-led disclosure)。这三个要素,恰好构成了任何生产级智能体系统都需要的事件响应闭环。
事件接收:把模型异常当作生产事故
传统软件运维中,事件接收(incident intake)是一套成熟机制:告警触发、工单生成、责任归属明确。而在AI智能体的世界里,模型的失准行为——比如越权调用工具、执行未授权操作、或产生误导性输出——同样需要被当作正式的生产事故来对待。
OpenAI的报告框架提供了一个参照系:它把模型的异常行为结构化地记录下来,而不是任由其散落在日志或用户投诉中。对于运维团队,这意味着需要建立专门针对智能体行为的接收通道,让每一次异常都能进入可追踪、可复盘的流程,而非被简单归为"模型幻觉"一笔带过。
值得注意的是,AI智能体的事件接收比传统软件更复杂,因为异常行为往往缺乏明确的"报错信号"。传统系统抛出异常时会有堆栈跟踪,而模型的失准行为可能表现为语义层面的偏差——输出在语法上完全合法,却在意图上已经越界。这要求接收通道不仅要捕获系统级错误,还需要对模型行为本身建立基线(baseline),将偏离基线的行为识别为"软异常"并纳入追踪。常见的实现方式包括:记录每次工具调用的完整调用链(call trace)、对高风险操作设置人工审核节点(human-in-the-loop checkpoint),以及建立行为日志的结构化存储,使事后分析可以按时间线还原完整上下文。
严重程度分级:给AI异常行为定级
并非所有失准行为都同等严重。一次无害的措辞偏差和一次绕过权限边界执行危险操作,显然应当对应不同的响应优先级。OpenAI框架中的**严重程度标签(severity labels)**为此提供了思路。
为什么分级至关重要
对于工具调用型智能体,风险的杠杆效应被显著放大。当模型不再只是生成文本,而是能够真正触发外部动作——发送邮件、修改数据库、调用API——一次失准的后果可能从"尴尬"升级为"损失"。因此,团队需要预先定义清晰的分级标准:
- 低危:输出偏差,无实际操作影响
- 中危:非预期的工具调用,但影响可控
- 高危:越权操作、数据泄露或不可逆的外部动作
这套分级不仅指导响应速度,也决定了升级路径与披露范围。
以证据为核心的披露
OpenAI框架强调证据主导的披露(evidence-led disclosure),这一点对企业智能体运维尤为关键。当出现失准事件时,仅凭主观判断或事后回忆是不够的——需要完整的证据链:模型的输入上下文、调用的工具、返回的结果、以及最终产生的行为。
这种做法既保障了对内的可复盘性,也支撑了对外的透明沟通。当团队需要向客户、监管方或内部管理层说明一次异常时,扎实的证据远比空泛的解释更有说服力。它把"AI出错了"这种模糊表述,转化为可分析、可归因、可改进的具体事件。
实现证据主导的披露,技术前提是完整的可观测性(observability)基础设施。对于LLM智能体,这通常包括三个层次:追踪(tracing)——记录每一次推理调用的输入prompt、输出token及延迟;日志(logging)——结构化记录工具调用参数与返回值;指标(metrics)——统计异常调用频率、拒绝率、重试率等聚合数据。目前业界常用的方案包括LangSmith(针对LangChain生态)、Weights & Biases Weave、以及OpenTelemetry的LLM语义约定扩展。没有这一层基础设施,所谓"证据主导"就只是一句口号——出现事故时既无法还原现场,也无法定位根因,披露也就无从谈起。
对智能体开发团队的启示
随着越来越多的团队将LLM封装为能够自主执行任务的智能体,安全与运维的边界正在模糊。OpenAI的失准报告框架提醒我们:安全治理不应是发布后的附加项,而应内建于运维流程之中。
将事件接收、严重程度分级、证据披露这三大机制移植到自己的智能体系统中,团队就能在异常发生时快速响应、准确定级、透明沟通。这不仅是一种合规姿态,更是构建可信AI产品的工程基础。对于身处快速迭代环境中的开发者,把大厂的安全实践当作运维信号来解读,或许比单纯阅读其安全承诺更有实际价值。
相关推荐
Cursor入门指南:AI编程工具全景解析与主流对比
Cursor入门教程第一讲:解析AI编程核心逻辑,横向对比Cursor、GitHub Copilot、Windsurf、Trae、通义灵码等主流AI编程工具的优劣势与适用场景,助你快速选型。
Cursor的Agent团队实践:如何突破40%生产力瓶颈
Cursor团队分享Agent团队实战经验:为何AI编程效率停滞在40%?答案在于AI只替代了软件开发生命周期的一小部分。本文解析PM Agent、安全Bot、代码审查与增长自动化如何重构研发全流程。
Pi 1.0 实测:11万星开源AI编程智能体,被称工具界Neovim
开源AI编程智能体Pi 1.0实测:GitHub 11.17万星、MIT许可、支持15家AI服务商和多模型路由,被社区称为AI工具界的Neovim。本文详解其架构、四大功能、Pi Durable运行时及与Claude Code、Cursor的对比。