GPT Live发布:语音正在成为AI交互的新入口

从打字到通话:AI交互入口的一次范式转移
OpenAI近期发布了名为GPT Live的新一代语音模型,官方表示它已开始支撑ChatGPT Voice的语音交互体验。根据对OpenAI官方RSS的观察,此次发布归类为「Product(产品)」,摘要中明确指向「更自然的人机语音交互」。
这次更新的意义,并不在于「又多了一个模型名字」,而在于聊天入口正在从打字往实时语音迁移。这是一个方向性的信号:过去我们与AI的交互依赖键盘输入,未来可能越来越像一通电话。
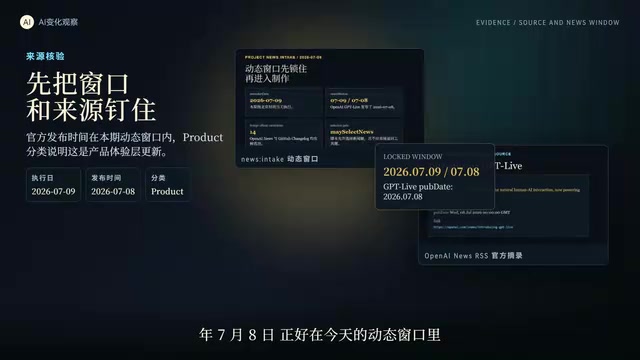
需要谨慎指出的是:目前可确认的信息仅限于OpenAI官方RSS所披露的产品方向,GPT Live的具体表现、是否全面开放API等细节尚未得到验证。本文不对其真实对话质量下定论,也不将其描述为「已全面开放」。
语音交互难在哪:延迟、打断与「接得住」
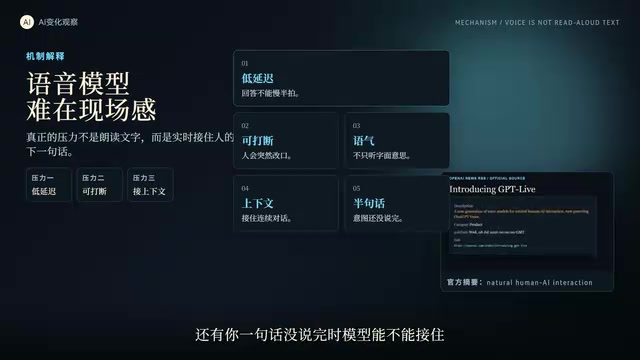
很多人以为语音AI就是「把文字念出来」,但实际情况远比这复杂。真正的实时语音交互需要攻克一系列工程与体验难题。
技术架构的演进:从级联到端到端
要理解GPT Live的意义,需要先了解语音AI技术走过的漫长历程。语音识别技术从1950年代贝尔实验室只能识别数字的Audrey系统,到1990年代IBM ViaVoice实现商用连续识别,再到2010年代深度学习带来的质变——这段历程本质上是人类对「机器如何听懂人话」这一问题不断深化认知的过程。
早期系统依赖隐马尔可夫模型(Hidden Markov Model,HMM)对声学信号进行统计建模,需要语言学家手工设计大量规则,将声音信号拆解为音素序列再逐级向上映射到词语和句子。HMM的核心假设是「当前状态只依赖上一状态」(马尔可夫假设),这一简化虽然在数学上带来了可处理性,却严重限制了模型对长距离语音依赖的建模能力。这一方法在安静受控环境下表现尚可,但面对口音、噪音和自然连续语流时迅速失效。深度学习时代,循环神经网络(RNN)与长短期记忆网络(LSTM)凭借对时序信息的天然适应性,逐步取代了HMM成为主流——LSTM由Hochreiter与Schmidhuber于1997年提出,其门控机制(输入门、遗忘门、输出门)使模型能够有选择地记忆或遗忘历史信息,解决了标准RNN的梯度消失问题,极大提升了对长距离语音依赖的建模能力。2017年Transformer架构的出现进一步颠覆了格局——其自注意力机制能够捕捉音频序列中的长距离依赖关系,且所有位置可并行计算(无需像RNN那样顺序处理),使模型在嘈杂环境下的鲁棒性大幅提升,训练效率远超RNN类模型。2022年OpenAI发布的Whisper则是这一演进的重要里程碑:基于68万小时多语言音频训练的单一神经网络,证明了无需手工设计声学模型即可实现高精度语音识别,彻底绕开了传统路径,为端到端语音交互奠定了工程基础。
传统语音AI系统通常采用「级联式」架构:语音识别(ASR)→ 自然语言处理(NLP)→ 语音合成(TTS),每个环节独立运行,误差逐级叠加,延迟也随之累积。更关键的是,文字转写过程会永久丢失原始音频中的语气、停顿、犹豫与情感信息——语言学家将这些被丢弃的信息称为副语言信息(Paralinguistic Information),包括基频(音调高低,反映说话者的情绪状态与语句的疑问/陈述性质)、音强(声音响度,体现情绪强度与强调重点)、时长(停顿节奏,传递思考状态与语义边界信号)等维度。值得注意的是,人类对副语言信息的依赖程度往往超出直觉——心理学家Albert Mehrabian的研究(尽管常被过度引用)指出,情感沟通中语调等非语言成分占据了远超字面意义的比重,而这些细节恰恰是人类判断「对方在认真听我说话」的核心线索。GPT Live所代表的新一代语音模型,正在向「端到端」架构演进——模型直接处理音频输入并输出音频,跳过中间的文字转换环节,从而大幅压缩延迟,同时保留这些在级联架构中会永久丢失的副语言信息。
值得注意的是,语音交互也并非全新赛道。Siri(2011年,苹果公司收购SRI International的语音助手项目后推出)、Google Assistant、Amazon Alexa构成了第一代智能语音助手浪潮,但它们本质上是「指令响应系统」——底层依赖预定义意图槽(Intent Slot)的填充逻辑,即系统预先定义「设置闹钟」「播放音乐」等有限意图,并从用户语音中提取对应的槽位参数(时间、歌曲名等),擅长执行「设个明天早上八点的闹钟」这类结构化指令,面对开放式对话时则会迅速暴露理解上限。OpenAI在2024年发布的GPT-4o首次展示了低延迟、带情感的实时语音对话能力,引发广泛关注。GPT Live可视为这一路线的持续深化——从「能用」到「自然」的跃迁,而同期竞争对手包括Google的Gemini Live和正在扩张语音能力的各类开源模型(如Meta的SeamlessM4T、微软的Azure Speech等)。
延迟与实时性
打字时,我们可以慢慢组织语言、反复修改;但语音对话是实时的,哪怕轻微的延迟都会让对话陷入尴尬。模型必须在极短时间内理解并回应,才能维持自然的对话节奏。
研究表明,人类对话中的正常话轮切换间隔约为200毫秒,这一数字有其深刻的神经科学根源。人类大脑处理语音的听觉皮层(位于颞叶的赫氏回,Heschl's Gyrus,负责对音频信号进行初级频率分析,相当于大脑的「声音接收站」)与负责预测和规划语言的布洛卡区(Broca's Area,位于左额下回,损伤后会导致表达性失语症,证明其在语言产出中的关键地位)协同工作,使我们能在对方尚未说完时就开始在神经层面准备回应——这一过程被语言学家称为「前瞻性话轮设计」(Anticipatory Turn Design)。人类并非被动等待对方停止发音后才开始组织语言,而是在实时解码对方语音的同时,借助语法结构的可预测性持续预测句子走向并预先规划自己的回应。例如,当听到「你能不能帮我……」时,大脑已在预测后续会是动词短语,并开始筹备相应回应,这种预测机制基于大脑对目标语言语法结构的深度内化。跨语言、跨文化的实验室研究(包括对曼达林语、日语、荷兰语等十余种语言的测量)均显示话轮间隔集中在200ms附近,被认为是认知处理极限与社交流畅性之间的进化最优解。对AI系统而言,实现这一延迟意味着从音频采集、特征提取(通常为梅尔频谱图,Mel Spectrogram,一种模拟人耳对频率非线性感知的时频表示方式——人耳对低频变化更敏感,梅尔刻度通过对数变换压缩高频、展开低频,更接近人类听觉系统的实际响应曲线)、语义理解到语音合成的完整链路必须压缩在100-150ms内完成——考虑到网络传输本身就可能占用50ms以上,这为模型推理效率设定了极为苛刻的基准。
打断与语气处理
真实对话中,人们经常互相打断、补充、改口。这背后涉及一项关键底层技术——语音活动检测(Voice Activity Detection,VAD),负责判断「用户是否还在说话」。
早期VAD系统依赖固定的能量阈值和过零率(Zero-Crossing Rate,即音频波形每秒穿越零点的次数,是判断有声/无声的简单特征——清音如「s」「f」的过零率远高于浊音如「a」「o」)等手工特征,本质上是在判断「当前音频帧是否有声音」,而非「用户是否还在表达」。这导致两类典型错误:将思考时的短暂停顿(通常400-800ms)误判为对话结束而过早打断,或将空调噪音、键盘敲击声等环境音误判为有效输入。现代神经网络VAD(如Silero VAD,基于LSTM在数千小时多语言、多噪声环境音频上训练;或WebRTC VAD的深度学习改进版)结合了声学特征与语义上下文,能更准确地识别「话轮转换」时机——比如识别出下行语调(降调,F0基频下降趋势)通常意味着陈述句结束,而上行语调(升调,F0基频上升趋势)则可能是疑问句或列举未完,这些韵律特征(Prosodic Features)构成了语音中超越词汇本身的元信息层,使VAD系统从单纯的声学信号检测升级为具备初步语言学理解能力的语义边界判断器。
打断处理则更进一步,要求模型在被中断时立刻停止当前音频输出流、清空待生成队列、切换到新的响应状态,而不是僵硬地继续执行原有生成逻辑——这对推理引擎的实时任务调度与内存管理是极高的工程挑战,需要生成进程与音频输出进程之间有低延迟的中断信号机制。从操作系统的视角看,这类似于抢占式多任务调度(Preemptive Multitasking)中的高优先级中断,但发生在神经网络推理这一计算密集型任务上,需要在不破坏模型状态一致性的前提下实现毫秒级的任务切换。
上下文的「接话」能力
最考验模型的场景是——当你一句话还没说完,模型能不能接住你的意思。这背后依赖的技术是流式推理(Streaming Inference)与预测性上下文建模,而其工程实现远比概念本身复杂。
流式推理与传统批处理推理存在根本矛盾:大语言模型的自回归生成(Auto-regressive Generation,即每次生成一个token,并将其作为下一步生成的输入,形成串行依赖链——这一特性使得并行化加速极为困难,因为第n个token的生成必须等待第n-1个token完成)天然需要完整输入序列才能启动注意力计算,而实时场景要求在输入未完成时就开始响应。当前的主流解决方案形成了一套组合拳:
投机解码(Speculative Decoding)让参数量小10-20倍的草稿模型预生成候选token序列,由大模型并行验证——若草稿被接受则跳过重复计算,若被拒绝则回退并由大模型重新生成,相当于用小模型替大模型「打草稿」,在保持输出质量的同时将吞吐量提升2-3倍;这一技术的理论基础是大模型的输出分布与小模型高度相关,在语义连贯的上下文中大部分token预测是确定性的,因此草稿被接受的概率在实践中可达70-80%;块注意力机制(Chunk Attention)将实时音频流切分为可增量处理的固定窗口(通常80-320ms),每个窗口独立计算注意力后与历史上下文拼接,使模型无需等待完整句子即可持续更新语义理解;动态KV缓存(Dynamic KV Cache)则将已计算的键值矩阵(Key-Value Matrix,注意力机制中存储历史token信息的核心数据结构——每个token在每个注意力层都会生成对应的Key和Value向量,缓存这些向量可避免在生成新token时对历史序列进行重复计算,是实现低延迟自回归生成的基础设施)复用于后续token的生成,避免重复计算。这些技术的组合使得模型能够在接收音频流的同时持续预测最可能的意图走向——类似于熟练的同声传译员不等发言者说完就开始翻译,依靠语言的可预测性提前输出,但代价是偶尔需要「跳回重译」(对应模型的草稿拒绝与回退)。
实现这一能力需要模型在「不确定性」与「响应速度」之间做出精妙权衡——过于激进会频繁在错误时机打断,过于保守则回归老式的尴尬延迟。正如原始素材中所言:「语音对话一尴尬,双方都只能现场硬扛」——这与打字可以反复修改的体验形成了鲜明对比。
GPT Live与开发者工具更新的对比
同一时间窗口内,GitHub Copilot也推出了VS Code六月更新,但那更像是一份面向开发者的功能清单,受众相对垂直。
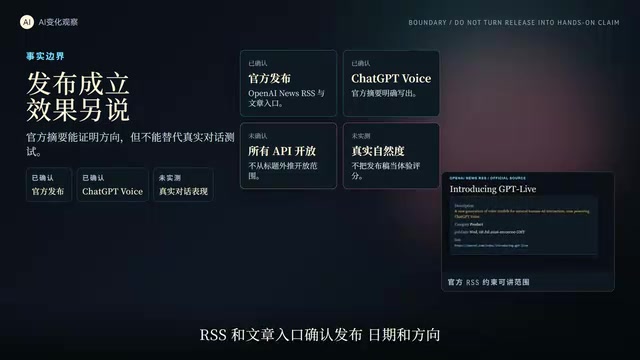
GPT Live的影响面则更为广泛,因为它触及的是普通用户每天如何与AI「说话」这一根本性问题。语音是门槛更低、更普适的交互方式——全球约有十亿人识字困难或打字不便,涵盖文盲人口、视觉障碍者、运动障碍者以及老龄化群体,语音交互对这一群体而言几乎是唯一可用的AI入口。从无障碍设计(Accessibility)的视角来看,这一领域遵循「通用设计」(Universal Design)原则——即为尽可能广泛的用户群体设计产品,而非事后为特定障碍群体打补丁;语音AI的进步不仅是产品功能的迭代,更是数字鸿沟(Digital Divide)弥合的重要机制——数字鸿沟不仅是设备拥有与否的问题,更是使用能力与交互门槛的问题(联合国国际电信联盟的报告将其分解为「接入鸿沟」「使用鸿沟」「技能鸿沟」三个层次),而语音恰恰是人类最低门槛的信息传递方式,无需读写能力,无需记忆特定操作逻辑,符合人类从出生起就开始训练的自然交流模式。它的改进对大众用户的意义,远超专业工具的功能迭代。
趋势判断:AI入口会越来越像「一通电话」
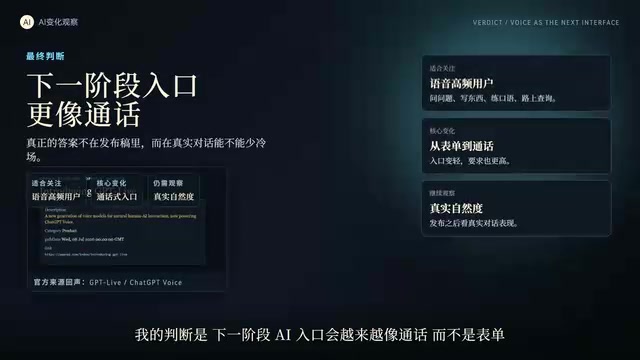
基于此次发布,一个值得持续关注的趋势是:下一阶段的AI入口,会越来越像一通电话,而不是一张需要填写的表单。
这一趋势的底层逻辑,与人机交互(HCI)领域的「自然用户界面」(Natural User Interface,NUI)研究方向高度吻合。从命令行(CLI,Command Line Interface,要求用户记忆并精确输入文本指令,诞生于1960年代的分时系统,是计算机走出专家圈子的第一步)到图形界面(GUI,Graphical User Interface,由施乐PARC实验室在1970年代发明、苹果Macintosh在1984年商业化普及,以窗口、图标、菜单将操作可视化,大幅降低认知门槛,将「记忆」需求转化为「识别」需求)再到触控界面(将手势这一人类本能动作直接映射为操作,iPhone的多点触控在2007年将这一范式推向大众),每一次交互范式的迁移都以「更接近人类自然行为」为核心驱动力——这也是计算机科学家Alan Kay所说的「最好的界面是没有界面」(The best interface is no interface)的渐进实现。语音作为人类最古老、最高带宽的交流方式(人类平均语速约为每分钟125-150词,而熟练打字者约为每分钟60-80词,语音输入的信息带宽优势明显),其成为主流AI入口几乎是技术成熟后的必然结果。
但值得警惕的是,语音交互并非在所有场景下都优于文字——私密场合、嘈杂环境、需要精确措辞的专业任务中,文字输入仍有不可替代的优势。人机交互研究者将这种现象称为「模态适配」(Modality Matching):不同的交互通道在不同情境下具有不同的信息传递效率——认知科学家将其与双重编码理论(Dual Coding Theory)联系起来,该理论认为人类通过言语和视觉/听觉两套独立但相互关联的系统处理信息,最优的交互设计应当激活与任务性质匹配的认知通道。未来的AI界面很可能是多模态的,语音与文字根据场景动态切换,而非简单的替代关系。
如果这个判断成立,以下几类用户可以重点关注GPT Live的后续进展:
- 经常用语音提问或写作的人:语音输入可能大幅提升效率
- 有口语练习需求的用户:实时对话是绝佳的语言训练场景
- 驾车、通勤等无法打字的场景:语音查询信息将成为刚需
如何判断它是否「真的自然」
最后需要提醒:别只看发布稿的措辞。官方文案总会用「更自然」来描述产品,但真正的检验标准是——在真实对话中,它能不能减少冷场、能不能流畅接住你的话。
评估语音AI质量有几个可操作的维度,每一项都对应具体的技术瓶颈:
首轮响应延迟是否低于500毫秒,考验的是端到端推理链路的优化程度,包括模型量化(将32位浮点权重压缩为8位或4位整数,在接受轻微精度损失的前提下将显存占用减少75%以上,同时提升推理吞吐)、硬件加速(现代GPU的Tensor Core专为矩阵乘法优化,NPU/专用AI芯片如苹果Neural Engine进一步降低功耗与延迟)与网络传输的综合表现;
跨句停顿处理能否正确识别思考停顿与对话结束的边界而不提前截断,考验的是VAD模型对语义边界而非纯声学边界的理解能力——这需要模型不仅听「有没有声音」,还要理解「这个停顿在语义上意味着什么」,例如「我想买……」之后的停顿与「今天天气不错。」之后的停顿在声学特征上可能相似,但语义状态完全不同;
嘈杂环境鲁棒性即在背景噪音下识别准确率是否稳定,考验声学模型的泛化能力与波束成形(Beamforming,通过麦克风阵列的信号合成增强特定方向的声音,利用信号的空间相干性来抑制非目标方向的噪声)、噪声消除(包括谱减法等经典方法以及基于深度学习的端到端降噪模型如Facebook的DENOISER)等前端信号处理算法的质量;
以及多轮对话连贯性,即跨越多个话轮后模型是否还能准确追踪上下文指代关系(Coreference Resolution,如「它」「那个」「刚才说的」等代词和省略的准确还原,这是自然语言理解中公认的难题之一,因为正确解析指代需要结合词汇、语法、语义与世界知识的多层面推理),考验长上下文建模与记忆管理机制。
这些问题只有在实际使用中才能找到答案,而不是从产品发布页面上读出来的。
在AI交互方式快速演变的当下,GPT Live或许标志着一个新阶段的起点。但保持理性观察、等待真实体验反馈,仍是评估此类产品最稳妥的态度。
核心要点
- GPT Live代表的不只是一个新模型名字,而是AI交互入口从文字向实时语音迁移的方向性信号
- 真正的语音AI难点在于延迟(需压缩至200ms量级)、VAD精准度、打断处理与流式推理的工程组合
- 从HMM到Transformer再到端到端模型,语音识别技术的每一步演进都在减少信息损失、压缩系统延迟
- 语音交互不是对文字输入的简单替代,而是多模态界面的组成部分,其社会意义在于降低十亿级规模人群的AI使用门槛
- 评估语音AI质量应关注首轮响应延迟、停顿识别、噪声鲁棒性和多轮连贯性四个可操作维度,而非官方文案措辞
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。