OpenAI研究员Roon:对齐尚未解决,竞逐递归自我改进是历史性愚行

OpenAI研究员Roon公开表示对齐未解决,竞逐RSI是历史性愚行,呼吁放缓前沿研究。
OpenAI研究员Roon在社交媒体上公开表态,称对齐问题尚未解决,若全速冲向递归自我改进(RSI)将是世界历史上前所未有的愚行,并呼吁显著放缓前沿研究。文章指出,「对齐尚未解决」在学术圈几乎是公开共识,但行业叙事习惯将「行为看起来对齐」等同于「对齐已解决」。RSI的风险在于人类可能失去对改进过程的监督能力,历史上无先例可循。Roon的提议与当前算力军备竞赛、资本增长期待形成尖锐对立,但放缓前沿不等于停止AI发展。这条表态的价值在于它来自圈内,暴露了前沿实验室商业目标与安全目标之间的结构性张力,也说明行业内部担忧已积累到临界点。
一条推文引发的行业震动
据Reddit社区转引,OpenAI研究员Roon近日发表了一段措辞罕见的表态:「alignment has not been solved. if this is true, then racing into RSI is a folly that is unprecedented in world history. we will need to significantly slow the frontier of research soon.」翻译过来大意是:对齐问题尚未解决;如果这一判断成立,那么全速冲向递归自我改进(RSI)将是一场世界历史上前所未有的愚行,我们很快需要显著放缓前沿研究的步伐。
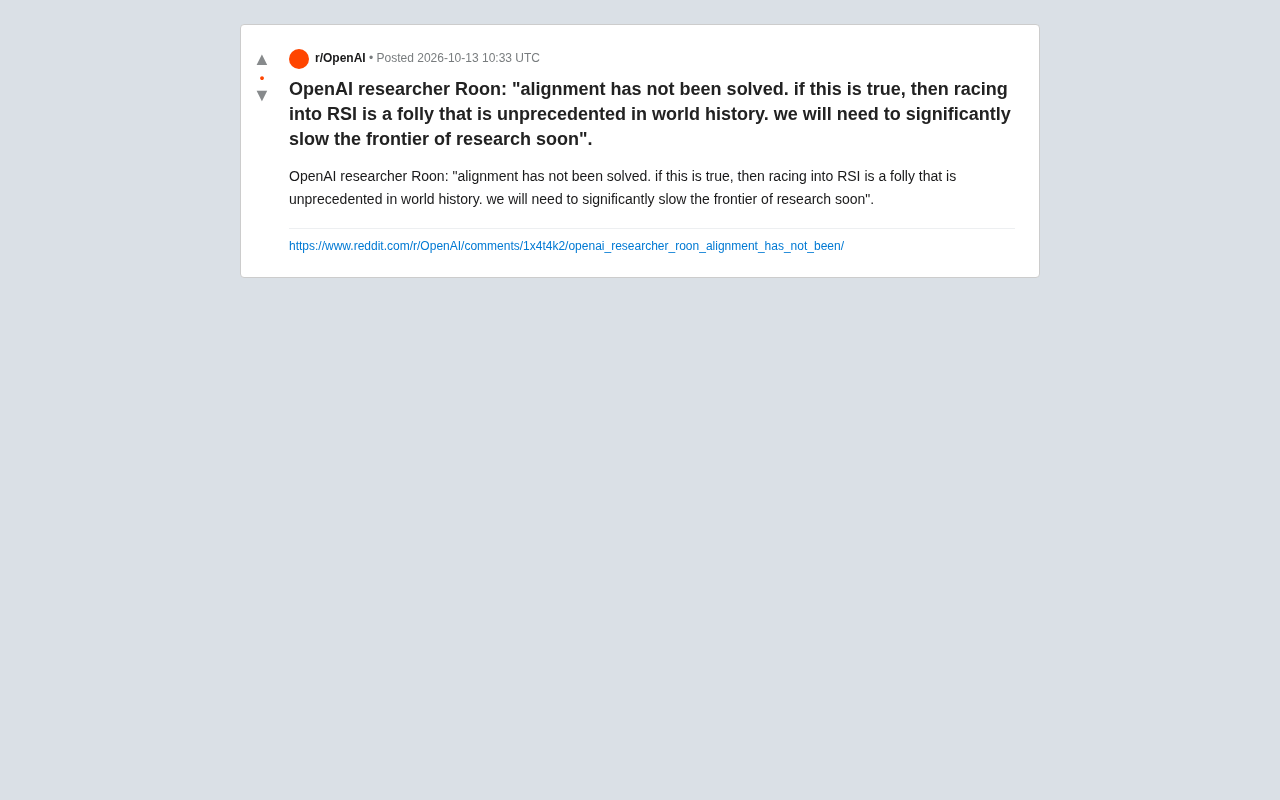
这段话之所以值得认真对待,不在于它出自社交媒体,而在于发言者的身份——一位身处前沿实验室内部的研究者,公开对「加速」这一行业默认立场提出了根本性质疑。
对齐远未解决:一个被默许的共识
Roon的第一句判断其实并不新鲜。「对齐尚未解决」在学术圈几乎是公开的秘密,只是很少被前沿实验室的研究者以如此直白的方式说出来。
当前主流对齐技术——从RLHF到宪法AI再到可扩展监督——解决的更多是「让模型在常见场景下表现良好」,而非「确保模型在任何情况下都不会追求与人类冲突的目标」。二者的差距,相当于「考试及格」与「证明定理」的差距。
问题在于,行业叙事习惯性地把「行为看起来对齐」等同于「对齐已解决」。Roon的表态戳破了这层窗户纸:如果底层问题没解决,那么所有建立在其上的安全承诺都是沙上城堡。
RLHF、宪法AI与可扩展监督是当前三条主流对齐路线的代表,各自针对不同层面的问题。RLHF(基于人类反馈的强化学习)通过让人类标注者对模型输出排序,训练一个奖励模型来引导模型行为,是ChatGPT成功的关键技术之一;宪法AI(Constitutional AI)由Anthropic提出,用一套成文原则让模型自我批判和修正,减少对人工标注的依赖;可扩展监督(Scalable Oversight)则试图解决当模型能力超过人类评判能力时如何继续监督的问题,代表性思路包括辩论、递归奖励建模等。三者的共同局限在于:它们优化的是模型在训练分布内的行为表现,而非给出「模型目标与人类目标一致」的形式化保证。这也正是Roon判断「对齐尚未解决」的技术根基。
RSI为什么让内部人恐惧
递归自我改进(Recursive Self-Improvement, RSI)指的是AI系统能够自主改进自身能力,改进后的系统又能更快地改进下一代,形成能力上的正反馈螺旋。
Roon用「unprecedented in world history」来形容贸然冲向RSI的后果,这个措辞的分量需要拆解。历史上人类面对的技术风险——核武器、生物工程——都有相对明确的物理边界和可验证的防御手段。RSI的风险在于:一旦启动,人类可能失去对改进过程的监督能力。你无法对齐一个能力远超你的系统,正如你无法用小学算术验证一篇博士论文。
这正是Roon逻辑的核心:对齐未解决 + RSI可能快速失控 = 竞逐RSI是愚行。三者环环相扣,缺一不可。
**递归自我改进(RSI)**这一概念最早可追溯到I.J. Good在1965年提出的「智能爆炸」设想,以及Eliezer Yudkowsky、Nick Bostrom等人对「种子AI」的讨论。其核心假设是:一旦AI系统具备修改自身代码或架构的能力,且改进效果能带来更强的改进能力,能力增长就可能进入超指数曲线。批评者指出,实际中RSI面临算力瓶颈、算法搜索空间限制、反馈信号稀缺等约束,未必会瞬间失控。但即便不考虑极端情形,「改进速度超过人类监督速度」这一较弱的假设,也足以构成风险——因为监督本身需要时间、算力和认知能力,而这些都可能成为瓶颈。
「显著放缓前沿研究」意味着什么
Roon的结论指向一个在当下语境中显得刺耳的提议:我们需要很快显著放缓前沿研究的步伐。
这与行业当前的竞争态势形成尖锐对立。前沿实验室之间的算力军备竞赛、各国对AI主导权的争夺、资本对增长曲线的期待——所有力量都在推动加速,而非减速。
需要区分的是,放缓前沿研究不等于停止AI发展。Roon的表述针对的是「前沿」(frontier),即那些能力边界上的探索,而非应用层的普及。一个合理的解读是:在安全基础未夯实之前,把资源从「更大更强的模型」转向「更可靠的对齐方法」,而不是简单地把所有AI研究叫停。
「前沿研究」与「应用层普及」的区分是理解Roon提议的关键。前沿研究指推动模型能力上限的工作,例如训练更大规模的基座模型、探索新的预训练范式、提升推理与自主性;应用层则包括把已有模型能力落地到具体场景,如客服、编程辅助、医疗辅助等。放缓前沿并不必然放缓应用,甚至在安全对齐方法成熟后,应用层的收益可能更稳健。类似的区分也出现在AI治理讨论中,例如「算力阈值」监管思路正是试图只对超过特定训练算力的前沿模型施加更严格的审查,而不波及中小规模研究和应用。
一条推文背后的结构性张力
单个研究者的表态无法改变行业轨迹,但它暴露了一个结构性张力:前沿实验室的商业目标与安全目标正在分道扬镳。
当加速能带来估值、算力和人才,而减速需要全行业协调——甚至是跨国协调——时,个体的理性选择就变成了集体的非理性。Roon所说的「folly」,某种程度上正是这种集体行动困境的产物。
对于关注AI安全的读者,这条表态的价值不在于它提供了解决方案,而在于它来自圈内。当内部人开始用「历史性愚行」这样的词,说明行业内部的担忧已经积累到了某个临界点。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。