OpenAI自研AI芯片深度解析:软件栈、架构与英伟达威胁
OpenAI自研AI芯片的软硬件技术细节曝光,从Codex自动化内核开发到Gluon编程语言、机架级2048 XPU集群,全面挑战英伟达CUDA护城河。
OpenAI自研AI芯片(以辣椒系列命名)的技术细节近期浮出水面,覆盖软件栈、编程语言和硬件架构三个层面。软件层面,AI编程助手Codex已能在无需人工干预的情况下自动生成数千行高质量芯片内核代码;编程语言层面,OpenAI基于Triton自研了Gluon语言,其核心创新是将张量元素到硬件寄存器的映射代数化,实现可证明正确的布局转换。硬件层面,单个扩展网络可连接2048颗XPU,基于博通Tomahawk 6以太网交换芯片构建本地与全局两级互联,双机架系统功耗约160千瓦。在架构取舍上,OpenAI明确放弃了预填充与解码分离(PD分离)方案,认为生产流量的动态性使统一架构在全局利用率上更优。颇具戏剧性的是,OpenAI当前仍在用英伟达GPU训练模型,而这些模型正被用于设计这款意图颠覆CUDA生态的芯片。
OpenAI自研AI芯片项目(内部代号涉及Jalapeño、Habanero等辣椒命名体系)的技术细节近期被曝光,从软件工具链到机架级硬件架构逐渐清晰。据B站UP主对相关技术文章的解读,这套系统在软件开发效率、内核编程语言以及扩展网络设计上都展现出与英伟达Blackwell正面竞争的野心。本文梳理其核心技术路径,并分析它对英伟达护城河的潜在冲击。
软件栈:Codex驱动的内核开发流水线
OpenAI用编写Chrome级别代码的精度来打磨芯片内核,每个内核都经过手工调优,部分内核代码长达约3000行,并配备正确性验证和自定义的Sanitizer工具。早期内核开发采用人工介入方式,但随着内部版本Codex规模化升级,这一流程逐步转向更自动化的模式。
值得关注的是软件流水线的实战表现:在通过基准测试对DeepSeek广告进行对标之前,OpenAI内部并未实现某类关键内核,而Codex能够在无需内核工程团队干预的情况下快速生成功能完备且高效的内核代码。这一点充分说明其AI辅助编程能力已经能承担芯片底层软件的重活。OpenAI还计划把内部版本的Codex能力向企业客户推广,形成对外输出的产品线。
Gluon与线性布局:自研内核编程语言
OpenAI使用名为Gluon的语言对芯片进行编程,这是其自研的内核编程语言,基于Triton构建,保留了Triton的SPMD(单程序多数据)编程模型,同时暴露了更底层的编程抽象。针对英伟达GPU,它提供了可映射到PTX指令的API,包括MMA指令、TMA指令、M-Barrier机制等。
Gluon最独特的抽象是Layout(布局)。Layout定义了硬件资源(如第9个warp的第5个累加器)与张量元素(如第6行第7列)之间的映射关系。Gluon的Layout抽象基于线性布局——这是OpenAI发明的一种布局代数类型,从数学上形式化了布局概念,并提供了操作Layout的工具,使得可证明正确的Layout转换和最优的内核内存访问成为可能。
在编程模型上,每个Gluon程序都映射到一个持久化线程,这表明该芯片适合持久化内核编程模式:每个程序在多个计算单元上执行,由程序员而非硬件调度器来分配工作。此外,芯片还提供数据预取和乱序执行单元,用户可以编程等待预取数据,数据通过信号量进行锁定。
Triton是OpenAI此前开源的GPU编程语言,旨在让研究人员无需深入掌握CUDA即可编写高性能内核。它采用SPMD(Single Program Multiple Data,单程序多数据)模型,程序员以块(block)为粒度描述计算,由编译器自动处理线程级并行细节。Gluon在Triton的基础上向下延伸,直接暴露PTX(NVIDIA并行线程执行指令集)级别的原语——MMA(矩阵乘累加)指令用于Tensor Core计算,TMA(张量内存加速器)指令用于异步数据搬运,M-Barrier则是CUDA 12引入的轻量级同步原语。这些底层接口使Gluon能够精确控制数据流水线和计算重叠,达到接近手写汇编的性能上限,同时又保有比纯PTX更高的可读性和可组合性。线性布局(Linear Layout)作为其核心代数工具,将张量元素到硬件寄存器的映射形式化为线性函数,从而使布局合法性可静态验证,消除了传统内核开发中大量运行时调试的布局对齐错误。
开发速度惊人:模拟器加持下的快速迭代
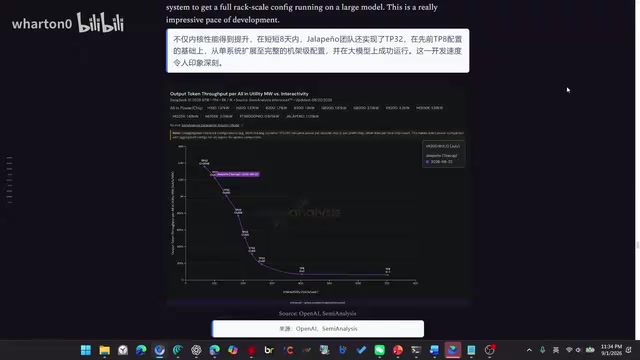
跨时间对比显示,该芯片的开发进展相当迅猛。不到两周时间内,其在某些交互场景下的吞吐量提升超过两倍;短短八天之内,团队还将并行配置从TP8扩展到TP32,从单系统扩展到完整的机架级配置,并在大模型上重复运行验证。
为在投入实际硬件前验证性能,OpenAI开发了一款模拟器,精度控制在实测硬件的5%以内。团队还演示了在Codex Command环境中运行内部模型(代号5.3 Codex Spark)的场景,每次输出token耗时约1.2毫秒。更有意思的是,他们展示了直接在芯片上运行的演示程序——包括以36FPS运行的《毁灭战士》、单精度浮点流体力学模拟以及可视化拖拽效果等,用来直观展示芯片的通用计算能力。
PD分离的取舍:为什么不做预填充与解码分离
一个令人意外的设计选择是:OpenAI并没有在这些芯片上采用预填充(Prefill)与解码(Decode)分离的PD架构。要知道,英伟达和AMD的GPU在PD分离架构上都有显著的性能提升,即便在同构硬件环境下也是如此。
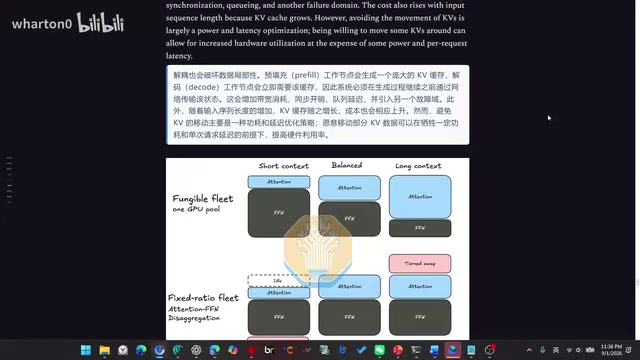
OpenAI的考量在于生产环境的动态性。在负载固定的场景下,PD分离确实很有吸引力——两个阶段对硬件资源的压力不同,分配到专门优化的独立资源池能提升效率。但生产环境的流量并不会保持固定比例:输入输出序列长度、并发量、缓存命中率、投机解码接收率、延迟目标都在动态变化。一旦硬件被划分为固定的资源池,预填充需求过多会导致解码芯片闲置,反之亦然,运营方必须持续预测并平衡一个理想比例始终变动的系统。
在统一架构中,某些资源在特定阶段可能未被充分利用,但每个设备仍可响应下一个请求;而在分离系统中,芯片可能仅因属于错误的资源池而处于闲置状态——本地利用率看起来更高,全局利用率反而更差。此外,PD分离会破坏数据局部性:预填充节点生成的大量KV缓存需要通过网络传输给解码节点,随着输入序列变长,KV缓存增大,带宽消耗、同步开销和延迟都会上升,还引入新的故障域。同样的约束也适用于投机解码——草稿模型与验证器分离会把紧凑的解码循环变成分布式协议,额外的通信开销可能抵消草稿机制节省的延迟。
当然这个选择也不是没有代价。在需求足够庞大、稳定且可预测的场景下,模块化的PD分离架构仍可能胜出。
预填充(Prefill)阶段负责将输入prompt的所有token一次性处理,计算密集度极高,属于典型的计算瓶颈场景;解码(Decode)阶段则逐token自回归生成,每步只处理一个新token但需要反复读取全量KV缓存,属于内存带宽瓶颈场景。两个阶段对算力与带宽的需求比例差异巨大,因此业界产生了将二者分配到异构或独立资源池的PD分离思路——预填充节点可配备更多计算单元,解码节点可优先配备高带宽内存(HBM)。谷歌TPU的"disaggregated serving"、英伟达的Dynamo推理框架均在探索这一方向。OpenAI放弃PD分离并非否认其理论收益,而是判断在其生产流量高度动态的场景下,静态资源划分带来的调度刚性和KV缓存跨节点传输开销会抵消甚至逆转收益——这一取舍与其强调全局利用率优于局部利用率的运营哲学一脉相承。
机架级架构:辣椒命名的硬件矩阵
整个系统采用了从日式到印度式、温和到辛辣的杂烩辣椒命名体系。机架单元级别由CPU主机机架和ASIC机架组成。主机机架内装有16颗主机CPU托盘,每个托盘对应一个ASIC托盘。每个主机配置两颗CPU、1.5TB内存、两个M.2 SSD,并配备400G(两路200G)前端网络接口,通过8根外部PCIe DAC线缆与ASIC托盘相连。
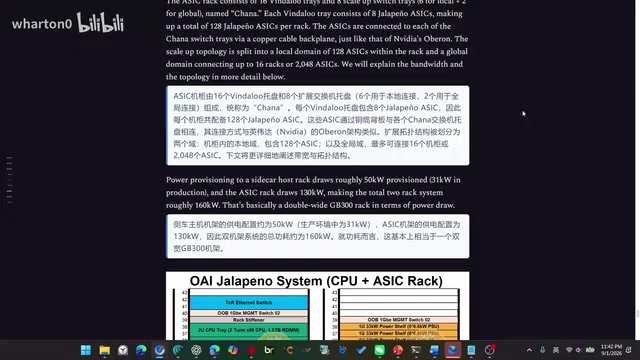
ASIC机架由16个ASIC托盘和8个扩展交换机托盘组成,每个ASIC托盘包含8颗XPU,因此每个机架共配备128颗XPU。其连接方式与英伟达的机架扩展架构较为类似。系统被划分为两个域:机架内的本地域包含128颗ASIC,全局域最多可连接16个机架、共2048颗ASIC。
功耗方面,Sidecar主机机架供电约50千瓦(生产环境31千瓦),ASIC机架供电130千瓦,双机架系统总功耗约160千瓦——这基本相当于一个双框GB300机架的功耗水平。
扩展网络:Tomahawk 6加持的2048 XPU集群
OpenAI可在单个扩展网络中连接多达2048颗XPU。网络由两个域组成:本地域通过背板在机架内连接全部128颗XPU;全局域通过铜缆和光互联混合方案在16个机架间连接2048颗XPU。
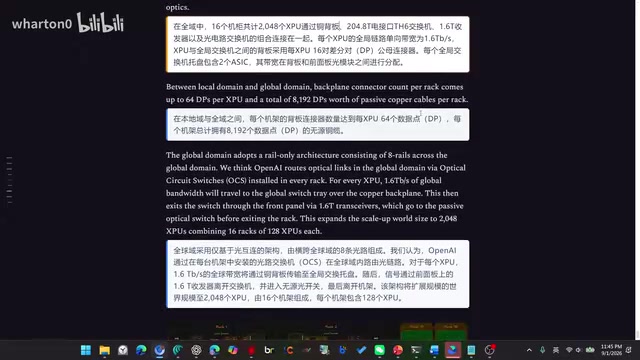
每个机架包含8个交换模块托盘,中间6个用于本地域,每个配备一颗102.4T的Tomahawk 6交换芯片;上下两个用于全局域,每个由两颗Tomahawk 6组成,单托盘交换能力高达204.8T。本地域每颗XPU拥有4.8TB/s单向带宽,全互联连接6颗Tomahawk 6,每颗XPU需要48对差分对连接,每个机架总共包含6144对无源铜缆差分对。
全局域采用仅基于光互联的架构,通过在每台机架安装光路交换机来路由关联路径。每颗XPU的全局单向带宽约1.6TB/s,信号经背板传输到全局交换托盘,通过前面板1.6T收发器进入光交换机后离开机架。由于扩展网络仅占系统总成本的10%,这种灵活性为未来支持10万亿至20万亿参数、或200万到400万token上下文窗口的超大模型提供了宝贵空间。
Tomahawk 6是博通(Broadcom)面向超大规模数据中心推出的以太网交换芯片,单芯片交换容量达102.4Tbps,支持800G及以上速率端口,是目前商用交换芯片中带宽密度最高的产品之一。OpenAI选择基于以太网的Tomahawk 6而非InfiniBand(英伟达旗下Mellanox的主力互联技术),意味着其扩展网络在协议层与英伟达的NVLink/InfiniBand生态完全解耦。以太网方案的优势在于生态开放、设备来源多元、成本可控,并天然支持与外部IP网络互通;代价是需要在软件层实现可靠传输和拥塞控制(类似RoCEv2),以弥补原生以太网在时延抖动和丢包敏感型负载上的不足。本地域使用背板无源铜缆(DAC)连接以降低时延和功耗,全局域切换为光互联以跨越更长距离,这种分层混合设计在超算领域已有先例,兼顾了成本与性能。
命运弄人:英伟达GPU助力自己的对手
一个颇具戏剧性的事实是:OpenAI的GPT系列模型目前仍运行在英伟达GPU上,却被用来设计一款真正威胁英伟达CUDA护城河的芯片。换句话说,英伟达自己的GPU正在实时助力其潜在继承者的诞生。
从近期动向看,黄仁勋对此已有所动作。他此前也公开表示过OpenAI完全没有必要自研芯片——这番话已经算相当克制,但潜在威胁是显而易见的。在部署方面,OpenAI正与新兴云厂商合作,收集可靠性数据并优化从码头到机柜的部署时间,其首个生产token即将推出,下一阶段目标是达到100兆瓦规模。
AI发展速度极快,资本永远流向有利可图的地方。OpenAI自研芯片的进展,某种程度上正是这一逻辑的最新注脚:当软件工具链、编程语言和硬件架构逐步闭环,英伟达面对的将不再是单一维度的竞争,而是一套完整的软硬件体系挑战。
相关推荐
Fable 5.2灰度测试曝光:Anthropic或将超越GPT-6 Astra
Anthropic疑似灰度测试Fable 5.2和Opus 5.2,社区测试者称其推理能力超越GPT-6 Astra,但代价是更慢的生成速度与更高成本。本文梳理泄露细节、IPO商业博弈与AI安全叙事争议,并提醒相关信息未获官方证实。
免费调用 GPT-6 Astra:配合 Cline 实测生成 4 款 3D 游戏
详解如何免费试用 GPT-6 Astra 模型:通过 Zenslab 关联 Telegram 领取积分,配合 VS Code 的 Cline 扩展接入 API,实测生成烹饪游戏、战术射击及 Dust2 地图等 4 款 3D 游戏,并分析免费额度的实际能力与限制。
警惕第三方ChatGPT充值陷阱:三种方式的风险辨析
针对社交平台流行的第三方ChatGPT充值教程,本文客观辨析代充网站、境外信用卡直充、移动端内购三种方式的流程与风险,重点提示所谓"不给密码就安全"的误导性及封号隐患。