OpenAI自研芯片Jalapeño:每瓦性能达现有芯片1.8-4倍
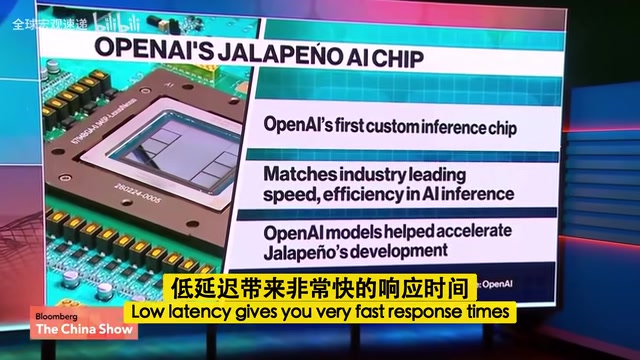
OpenAI发布自研推理芯片Jalapeño,每瓦性能达现有芯片1.8至4倍,剑指降低token成本。
OpenAI首次公开展示自研推理芯片Jalapeño,芯片负责人Richard Ho称其每瓦性能比现有芯片高出1.8至4倍,并在行业内首次同时实现了高吞吐与低延迟。Jalapeño定位纯推理芯片,不会取代英伟达在训练侧的地位,而是作为OpenAI多芯片"舰队"的一员,与英伟达、Cerebras等共同承担差异化工作负载。基准测试采用开源工具InferenceX以示公正,但第三方验证仍需等待量产落地。若性能数据在生产环境中成立,面向开发者的API调用价格有望进一步下降,进一步强化OpenAI在规模化AI服务中的成本竞争力。
OpenAI首次向外界展示了它的自研推理芯片Jalapeño,芯片负责人Richard Ho在采访中透露,这款芯片在效率与响应速度的关键测试中表现超越了英伟达当前的旗舰处理器。其核心诉求只有一个:以更低的成本向用户交付更多智能。
Jalapeño是什么:一颗为推理而生的芯片
Jalapeño是一款推理(inference)芯片,而非训练芯片。这个定位选择本身就透露了OpenAI的战略考量。Richard Ho解释说,OpenAI对算力的需求正处于爆炸式增长阶段,而增长的主要来源恰恰在推理侧——随着周活跃用户快速攀升,模型服务端的算力压力远大于训练端。
在训练方面,OpenAI选择继续依赖英伟达这一强力合作伙伴,认为其提供了出色的训练芯片;而在推理这块增长最快的战场,OpenAI决定自己下场,补齐算力缺口。
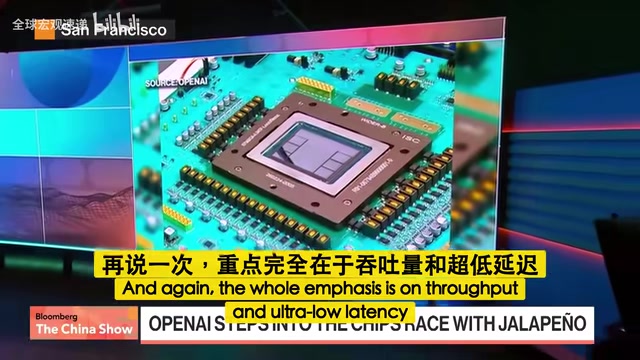
值得一提的是,Jalapeño并不会取代现有供应商,而是作为OpenAI芯片"舰队"(fleet)的一部分,与英伟达、Cerebras等厂商的芯片共同承担不同的工作负载。
训练(training)与推理(inference)是AI芯片需求的两个截然不同的阶段。训练阶段需要对海量数据进行反复迭代计算,要求极高的浮点运算吞吐量,通常一次训练任务持续数周乃至数月,芯片利用率相对稳定可预测。而推理阶段则是将训练好的模型部署上线、实时响应用户请求的过程——每一次对话、每一次代码补全都会触发一次推理调用。随着ChatGPT等产品用户规模扩大,推理请求量可以在极短时间内激增数倍,对芯片的并发处理能力和响应延迟提出完全不同的要求。正因为推理负载具有爆发性、实时性强、成本直接传导至用户定价等特点,主流AI公司普遍将推理侧的自研芯片视为控制边际成本的核心抓手。
高吞吐与低延迟兼得:行业首次?
Richard Ho对Jalapeño最引以为傲的一点,是它在同一颗芯片上同时实现了高吞吐(high throughput)和低延迟(low latency),他称这在行业内尚属首次。
这两个指标各有价值:
- 高吞吐意味着能以更低的成本为大量客户提供海量token服务;
- 低延迟则带来极快的响应速度,让AI智能体(agents)反应更迅速,编程等交互场景体验更流畅。
过去这两者往往需要在硬件设计上做取舍,Jalapeño声称能"鱼与熊掌兼得",对OpenAI的产品体验是实打实的加成。
吞吐量与延迟之间的矛盾,根源在于硬件资源的分配逻辑。高吞吐通常通过批处理(batching)实现——将多个用户的请求合并成一批同时计算,大幅提升单位时间内处理的token总量,但单个请求必须等待凑批才能开始执行,首字节延迟(Time to First Token,TTFT)随之上升。低延迟则要求请求一到立即处理,批次小甚至不批处理,硬件利用率因此下降,每token的边际成本升高。传统做法是针对不同业务场景部署不同型号的芯片,或在同一芯片上通过软件策略在两种模式间切换。Jalapeño声称在芯片架构层面解决了这一矛盾,若属实,对需要同时支持高并发API服务与低延迟交互产品的OpenAI而言,可以显著简化基础设施规划。
每瓦性能1.8至4倍:token价格有望下降
采访中最受关注的数据,是Jalapeño的每瓦性能(performance per watt)比现有芯片高出1.8到4倍。Richard Ho特别指出,每瓦性能是衡量单个token成本的良好代理指标——性能越高,意味着单位token的成本越低。
为了保证测试的公平性,OpenAI使用了一个名为InferenceX的开源基准测试工具,Richard Ho强调选择开源方案是为了做到中立、公正的对比。
他直言不讳地表示:"这是一颗非常好的芯片,它应该会让成本大幅下降。"当Jalapeño正式投入生产后,面向客户的token价格有望随之下调。降低推理成本、压缩基础设施开销,一直是OpenAI长期以来推动的核心目标。
多芯片策略:如何分配工作负载?
面对英伟达、Cerebras以及自研Jalapeño等多种选择,OpenAI如何决定哪种工作负载跑在哪颗芯片上?
Richard Ho把这称为公司正在创造的"可选性"(optionality)。OpenAI会自行规划——哪一款产品、哪一个SKU、哪一颗芯片最适合哪一个模型,从而为用户提供一系列在成本与延迟能力上各具特色的模型组合。
这种精细化的算力调度背后,是OpenAI一以贯之的战略:用最合适的硬件,以最低的推理与基础设施成本,向用户交付更多智能。
观察与思考
OpenAI自研推理芯片,是继谷歌TPU、亚马逊Trainium/Inferentia之后,又一家头部AI公司走向自研硅片的信号。这背后反映出行业的一个共识:在模型能力逐渐拉平之后,谁能把推理成本压得更低,谁就能在规模化服务中占据优势。
需要保持审慎的是,1.8至4倍的每瓦性能提升来自OpenAI自身的基准测试,虽然采用了开源工具,但真实生产环境中的表现仍需等待芯片正式量产落地后的第三方验证。对于普通用户而言,最直接的期待,或许就是未来API调用价格的进一步下探。
谷歌的TPU(Tensor Processing Unit)自2016年起投入内部使用,目前已迭代至第六代,是业界自研AI芯片最成熟的先例;亚马逊的Trainium专注于训练、Inferentia专注于推理,均已通过AWS对外提供服务。这些案例表明,自研芯片从流片到大规模生产落地通常需要数年周期,中间面临良品率、供应链、软件生态适配等多重挑战。OpenAI目前尚未披露Jalapeño的代工厂商、制程节点及量产时间表,这些信息将直接决定其成本优势能否兑现为用户可感知的价格变化。与此同时,自研芯片还需要配套的编译器、调度框架和算子库,软件栈的成熟度往往比硬件本身更决定最终的实际性能表现。
相关推荐
GPT-6 Astra实测Blender:3D设计将迎变革还是虚火?
GPT-6 Astra发布后引爆Blender,UP主肥虫实测AI一句话生成3D资产的真实能力:远看惊艳近看崩塌,AI真正降维打击的是重复劳动。附3D设计师转型方向与Blender被引爆的深层原因分析。
警惕第三方ChatGPT代充陷阱:账号安全风险深度解析
第三方ChatGPT代充服务宣称无需境外信用卡即可开通Plus、Pro会员,但要求交出账号登录凭证存在严重安全风险。本文深度解析代充运作模式与隐患,并提供合规订阅替代方案。
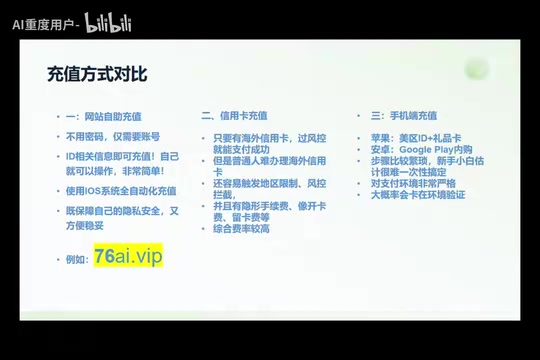
GPT Plus/Pro国内充值方式对比与选择指南
国内如何订阅ChatGPT Plus/Pro会员?本文对比第三方网站代充、海外信用卡、手机应用内充值三种方式的门槛、成本与风险,并提供账号安全提示,帮助用户理性选择合适的充值渠道。