OpenCode十倍GLM额度活动与Gemini 4曝光:AI日报速览

OpenCode十倍GLM-5.3额度上线,Flint、书生S2.1等模型与OpenAI、谷歌、AMD动作密集
本期 AI 日报聚焦模型能力与平台生态两条主线。OpenCode 推出 Operation GLM 第一阶段活动,10 美元可获得价值 100 美元的 GLM-5.3 额度,面向所有 OpenCode Go 订阅者并已生效。模型侧,Command Code 上线 Recursive 的 Flint,262K 上下文、40B 总参数、2.5B 激活参数且全部套餐免费;美团以 MIT 许可开源 LongCat Video Avatar 1.6,数字人视频时长突破 10 分钟;上海 AI 实验室发布书生 S2.1 Flash,320B MoE 架构,支持科研软件操作与视觉反馈自查,权重已开放下载。平台侧,OpenAI 为 ChatGPT 医疗版新增 20 多款插件,并将学术研究计划扩至最多 20 万人;AMD 收编李飞飞的 World Labs;谷歌 Gemini 推出 66 种地区语音,网页端出现疑似 Gemini 4 的模型引用但未获官方确认。
OpenCode 推出 Operation GLM 第一阶段活动,花 10 美元可用上价值 100 美元的 GLM-5.3 额度,优惠面向所有 OpenCode Go 订阅者开放,目前已在订阅套餐内生效。同时,Command Code、美团、上海人工智能实验室、OpenAI、AMD 与谷歌均有新动作,以下为核心信息梳理。
OpenCode 十倍额度:低价试用 GLM-5.3 的窗口
据 B 站 AI 日报视频,OpenCode 的 Operation GLM 第一阶段活动给出十倍额度杠杆:用户支付 10 美元即可获得价值 100 美元的 GLM-5.3 调用额度,且该优惠面向所有 OpenCode Go 订阅者,并已在订阅套餐内生效。从产品策略看,这是一次典型的入口争夺——用额度补贴降低开发者试用国产模型的门槛,把订阅关系沉淀到自家平台上。
这一活动的实际价值取决于两点:GLM-5.3 在编码任务中的表现是否稳定,以及额度消耗后的续费定价是否具备吸引力。素材未披露额度有效期与限购规则,参与前建议先确认套餐条款。
Command Code 上线 Flint:262K 上下文的轻量模型
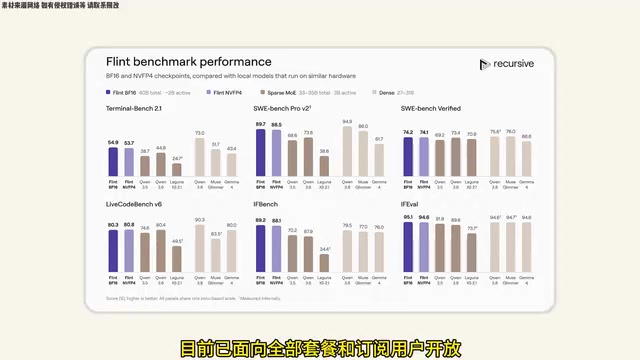
Command Code 宣布来自 Recursive 的 Flint 模型已上线并免费开放,上下文窗口 262K,总参数 40B、激活参数 2.5B,发布于上个月。官方称其在多项测试中表现优秀,超过激活参数 3B 的 QA3.6 和 3.5 系列,但未达到 QA27B 的水平。该模型目前已面向全部套餐和订阅用户开放。
这组参数的看点在于稀疏激活比例:以 40B 总参数支撑 262K 上下文,实际推理开销接近小模型,却定位在长上下文场景。对需要处理整库代码或长文档的开发者,免费开放的 Flint 是低成本替代选项;但官方对比数据来自自身测试,横向实力仍需独立评测验证。
MoE 与稀疏激活:Flint 提到的“总参数 40B、激活参数 2.5B”是典型的混合专家(Mixture-of-Experts, MoE)架构指标。MoE 把前馈层拆成多个“专家”子网络,每个 token 推理时只激活其中少数几个,因此总参数量决定模型容量上限,激活参数决定单次计算开销。2.5B 激活意味着实际算力需求接近一个小模型,而 40B 总参数提供更大的知识存储空间。
上下文窗口:262K 指模型单次可处理的 token 上限(约合十几万汉字或数千行代码),超出部分需要截断或分块。长上下文并不等于等比例有效,模型在中段信息检索上通常会有衰减,实际可用长度需以评测为准。
美团数字人模型开源:LongCat Video Avatar 1.6
据 Modoscope 消息,美团 LongCat Video Avatar 1.6 正式发布,这是一款数字人生成模型。使用音频生成数字人视频时最大时长突破 10 分钟,重点改善了音同步、面部与身体动作的自然度,说话时夸张口型明显减少,目前已以 MIT 许可开源发布。
十分钟级时长与 MIT 许可的组合,意味着它可以进入更长的口播、课程、营销视频生产流程,也便于二次开发。素材未给出分辨率、生成速度等指标,实际落地效果需自行测试。
上海 AI 实验室书生 S2.1 Flash:面向科研的多模态智能体
上海人工智能实验室发布书生 S2.1 Flash,官方称其总参数 320B,采用 MoE 架构,把十余类科学输入纳入统一模型,支持科学深度研究、科学编程和专业科研软件操作,能依靠视觉反馈检查中间结果并调整策略。目前模型权重已开放下载,并提供体验 API。
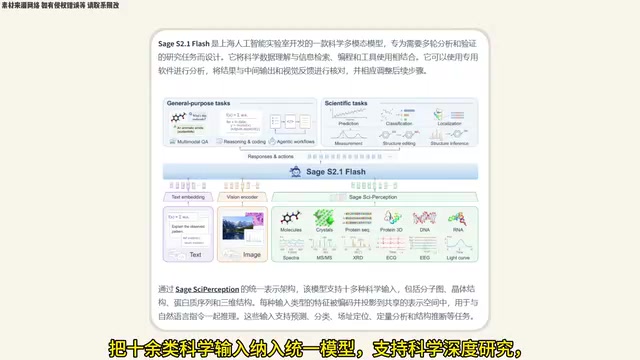
把科研软件操作与视觉反馈闭环纳入同一模型,是这类科学智能体与通用对话模型的本质差别:它需要在执行中观察结果并修正,而非一次性输出。权重开放下载对科研机构做本地化部署较为友好。
智能体(Agent)与视觉反馈闭环:智能体指模型能在多轮循环中自主调用工具、观察执行结果并调整下一步动作,而非单次问答。书生 S2.1 Flash 强调的“视觉反馈检查中间结果”,是把软件界面截图或绘图输出作为观察信号回灌给模型,使其能发现绘图报错、参数错误并重试。这一能力依赖多模态输入与工具调用接口的配合,是科学计算类任务的必要环节,也是通用对话模型难以直接替代的部分。
OpenAI:ChatGPT 医疗版进阶与学术研究计划扩容
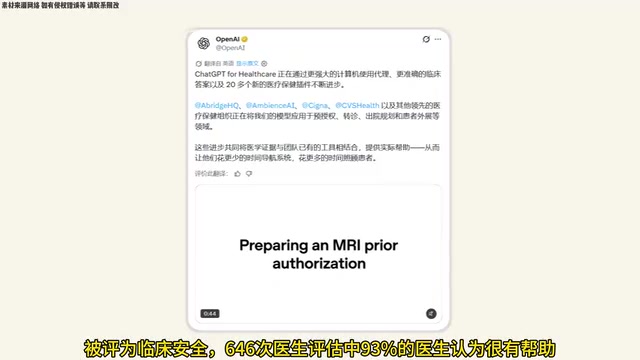
OpenAI 宣布 ChatGPT 医疗版新增 20 多款医疗插件,具备更强的计算机操作能力和更可靠的临床答复。据素材,多个医学机构已将这些能力用于视线授权、转诊、出院规划和就诊间随访评测,325 个任务中 99% 被评为临床安全,646 次医生评估中 93% 的医生认为很有帮助。
OpenAI 同时扩大 ChatGPT 学术研究人员计划,目标覆盖全球最多 20 万名研究人员。新一轮申请将在 11 月 23 日开放,按先到先得发放 5 万个资助名额,每个名额覆盖申请者本人和最多两名合作者,三人均可免费使用 ChatGPT Plus,本轮最多可支持 15 万名研究人员。官方表示通过该计划使用的用户数据默认不用于训练模型。
医疗插件与临床安全评估:插件(plugin/连接器)是让模型访问外部系统或专业数据集的扩展机制,医疗版新增的 20 多款插件意味着模型可调用病历、指南、计算器等工具。文中“325 个任务中 99% 被评为临床安全”属于基于人工标注的安全评测,评测口径与任务分布决定了结论的适用范围,不能直接等同于真实临床环境下的表现,机构落地前仍需本地验证。
AMD 收编 World Labs,谷歌 Gemini 多线推进
AMD 官方宣布正式欢迎 World Labs 团队加入 AMD。World Labs 由李飞飞创立,主打 3D 世界模型,李飞飞表示期待和 AMD 同事一起开启新篇章,双方均未披露交易条款和具体安排。
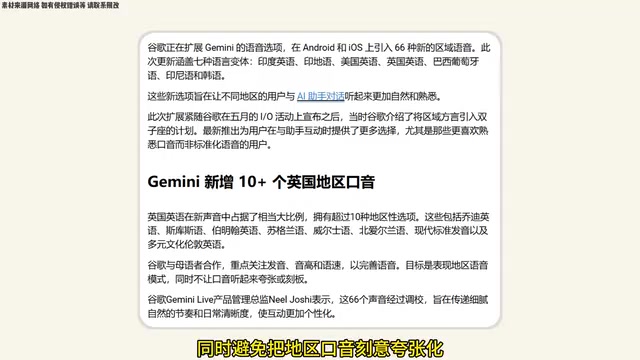
谷歌方面,Gemini 移动应用正式推出 66 种地区语音,覆盖 7 个语言类别,涵盖美式英语、英式英语、印度英语、印地语等。Gemini Live 产品管理总监 Neo 周士表示,谷歌与母语使用者合作,力求还原当地的语速、节奏和清晰度,同时避免把地区口音刻意夸张化,用户可在语音设置里自由切换。
另有观察者在 Gemini 网页上发现类似 Gemini 4 的模型引用,外媒推测可能是一款新的 Flashlight 模型。据 TestingCadva 观察,该模型目前尚不可用,谷歌也未作说明,外界普遍认为谷歌的新模型发布节奏尚未结束。该信息属于单一来源的推测,尚无官方确认。
3D 世界模型:World Labs 主打的 3D 世界模型,指从图像或文本生成可交互、具备空间一致性的三维场景,常用于机器人仿真、游戏与具身智能训练。此类模型对算力与显存需求高,与芯片厂商的软硬件协同关系紧密,这也是此类团队被 AMD 收编的背景之一。交易条款未披露,具体整合方式尚不明确。
观察:两条主线同时加速
把上述消息放在一起看,一是模型侧的长上下文与科研智能体正在快速铺开——Flint 用 262K 上下文与低激活参数降低使用成本,书生 S2.1 Flash 把视觉反馈闭环引入科研流程;二是平台侧的补贴与生态绑定——OpenCode 用十倍额度拉新,OpenAI 用免费 Plus 名额扩大学术用户盘。对开发者而言,短期可关注免费开放与额度活动的试用窗口;对机构而言,模型权重开源与本地部署选项值得纳入评估。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。