OpenDLSS:用Vulkan重构英伟达DLSS神经渲染网络

OpenDLSS 尝试用开放的Vulkan API重现英伟达封闭的DLSS神经渲染技术,探索AI图形能力的跨平台可能。
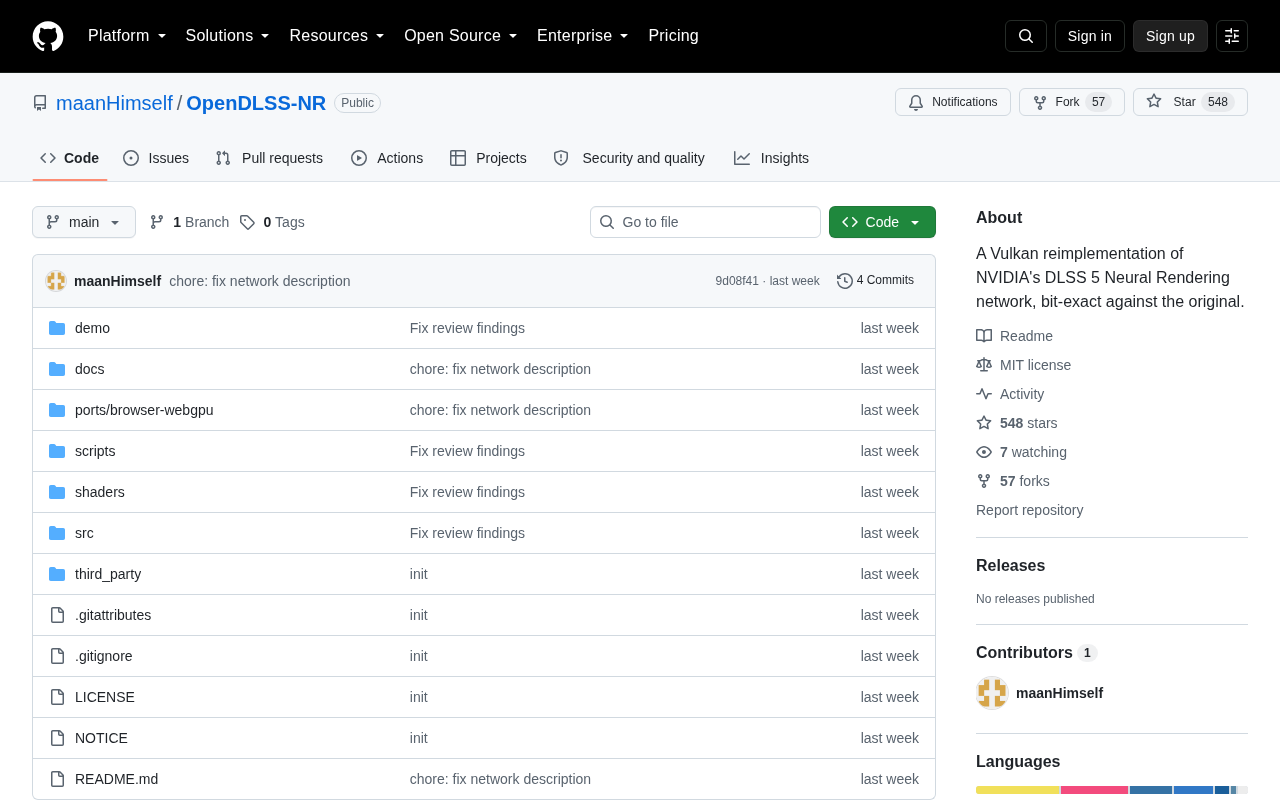
OpenDLSS 是一个用 Vulkan 重新实现英伟达 DLSS 5 神经渲染网络的开源项目,旨在将原本绑定 RTX 显卡专有硬件与驱动的超分技术移植到跨平台、跨厂商的通用图形 API 上。DLSS 的高门槛来自三个层面:需要海量数据训练的神经网络模型、依赖 Tensor Core 专用矩阵加速单元的推理性能,以及完全封闭的权重与底层实现。OpenDLSS 若能在 Vulkan 上跑通推理,理论上可使 AMD、Intel 等非英伟达硬件也能运行类 DLSS 技术,但缺少官方权重和专用加速单元,实际画质与帧率大概率与原版存在差距。此外,重实现专有神经网络还面临知识产权边界模糊的合规风险。项目的核心意义更在于探索:验证开放 API 上运行复杂神经渲染管线的可行性,以及提出一个更深层的行业问题——AI 驱动的图形能力,究竟该由单一厂商垄断还是走向开放生态。
一个开源项目的野心
在图形渲染领域,英伟达的DLSS(Deep Learning Super Sampling,深度学习超级采样)长期是封闭生态的代表。它依赖专有的硬件单元与驱动栈,普通开发者既无法窥探其内部实现,也难以在非英伟达硬件上复现其效果。而一个名为 OpenDLSS 的项目正试图打破这种局面——它用 Vulkan 对英伟达 DLSS 5 的神经渲染网络进行重新实现。
这一消息在 Hacker News 上引发了讨论(38 points、24 条评论)。虽然信息还相对有限,但「开源 + 跨平台图形 API + 神经渲染」这几个关键词的组合,足以说明它触碰到了行业的一个敏感点:AI 驱动的图形技术能否走出单一厂商的护城河。
DLSS 到底是什么,为什么难以复现
DLSS 的核心思路是用神经网络从低分辨率画面「推理」出高分辨率结果,从而在保证画质的同时大幅降低 GPU 的渲染负担。到了 DLSS 的较新版本,英伟达已经从早期的空间超分,演进到结合时序信息、运动矢量乃至帧生成的复杂神经渲染管线。
难点在于三个层面。其一是模型本身——训练这样一个超分网络需要海量高质量的游戏画面数据和巨大的算力。其二是硬件绑定——英伟达把推理过程交给 RTX 显卡上的 Tensor Core 执行,并通过专有驱动调度。其三是生态封闭——DLSS 的 SDK 虽然对游戏开发者开放集成接口,但底层权重和推理细节完全是黑盒。
正因如此,用 Vulkan 这样一个开放、跨平台、跨厂商的图形与计算 API 来「重实现」这套网络,技术上意味着要绕开英伟达的专有调度路径,把神经网络推理映射到通用的 compute shader 或 Vulkan 的机器学习扩展上。
Tensor Core 是英伟达从 Volta 架构(2017年)开始引入的专用矩阵运算单元,专为混合精度矩阵乘加运算(FP16/BF16/INT8)设计。相比通用 CUDA Core,Tensor Core 在执行神经网络推理时的吞吐量可高出数十倍。DLSS 的实时性依赖于此:一张 4K 帧的超分推理必须在 1-2 毫秒内完成,普通 shader 单元在算力密度上很难满足这一时延要求。这也是 OpenDLSS 选择用 Vulkan 的 compute shader 或机器学习扩展来替代专有调度时面临的核心性能瓶颈——通用计算路径在理论峰值算力上与专用矩阵加速器之间存在结构性差距,而非简单的软件优化问题。
用 Vulkan 重构意味着什么
Vulkan 的最大价值在于中立性。它不绑定任何单一 GPU 厂商,AMD、Intel 乃至移动端 GPU 都支持。如果 OpenDLSS 能把神经渲染网络的推理过程完整跑在 Vulkan 之上,理论上就打开了一扇门:让类 DLSS 的超分技术不再是 RTX 显卡的专属特性。
这与业界此前的一些尝试思路一致。AMD 的 FSR、Intel 的 XeSS 本身就是厂商为打破 DLSS 垄断而推出的方案,但它们各有各的实现路径。OpenDLSS 的差异点在于,它瞄准的是「重现英伟达的网络」,而非另起炉灶设计一套算法——这既可能带来更接近 DLSS 的画质表现,也必然伴随合规与知识产权层面的争议。
需要清醒看到的是,一个 Vulkan 实现能跑通推理,不代表它能复现英伟达同等的画质和性能。缺少官方训练权重、缺少 Tensor Core 级别的专用加速,开源项目在落地效果上大概率会与原版存在差距。
AMD 的 FSR(FidelityFX Super Resolution)与 Intel 的 XeSS(Xe Super Sampling)代表了两种不同的破局策略,值得放在这里对比。FSR 1.x/2.x 完全基于传统空间或时序算法,不依赖神经网络,因此可以在任意 GPU 上运行,但画质天花板相对有限。XeSS 则采用了类似 DLSS 的神经网络方案,在 Intel Arc 显卡上使用专用矩阵加速单元,在其他硬件上则退回到通用 DP4a 指令路径,以性能换兼容性。OpenDLSS 的思路与 XeSS 的「降级兼容」有些相似,但野心更大——它直接针对英伟达已调优的网络架构进行重现,而非设计一套新的网络。这意味着如果权重问题能被解决,它在 AMD 或 Intel 硬件上的画质潜力理论上比 FSR 更高,但工程难度与合规风险也随之倍增。
开源能否撬动封闭的图形生态
从更大的视角看,OpenDLSS 反映出一种趋势:AI 推理正在从「厂商独占的加速功能」逐步变成「开发者可以自主掌控的通用计算任务」。随着通用 GPU 算力和开放机器学习框架的成熟,越来越多原本封装在驱动里的黑盒能力,开始被社区尝试拆解和重建。
但挑战同样现实。神经渲染对延迟极度敏感,游戏场景要求每帧在毫秒级完成推理,开源实现若无法达到足够的帧率,实用价值就会大打折扣。此外,围绕「重实现专有网络」的法律边界模糊,也可能让项目的推广受限。
对关注图形技术与 AI 交叉领域的开发者来说,OpenDLSS 的意义更多在于探索性——它验证了在开放 API 上运行复杂神经渲染管线的可行性,为后续的跨平台超分方案积累工程经验。至于它能否真正成为 DLSS 的替代品,还需要观察项目的后续进展与社区投入。
「重实现」(reimplementation)在开源社区有悠久的先例,Wine 对 Windows API 的重实现、Mesa 对 OpenGL/Vulkan 驱动的开源实现都是典型案例。法律上,重实现本身通常被认为是合法的——只要没有直接复制受版权保护的代码或二进制权重,而是通过逆向工程或公开论文独立复现功能。DLSS 的麻烦在于,其神经网络权重属于英伟达的商业机密与版权资产,项目若直接提取或分发这些权重,将面临明确的法律风险。更现实的路径是:用公开的超分网络架构(如 ESRGAN 衍生结构)配合自行训练的权重,在接口层面与 DLSS 兼容,而非逐字节复原英伟达的模型——这也是观察 OpenDLSS 后续选择的关键看点。
小结
OpenDLSS 是一次值得关注的开源尝试,它把英伟达封闭的 DLSS 神经渲染网络搬到了跨平台的 Vulkan 之上。无论最终效果如何,它都在提出一个关键问题:当 AI 成为图形渲染的核心,这项能力应该被单一厂商掌控,还是向更开放的生态敞开?目前项目信息仍较为有限,建议读者结合其代码仓库与实测数据,理性看待其实际能力。
相关推荐
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。