OpenPA:免强制对齐的多粒度发音评估新框架

OpenPA利用Whisper交叉注意力机制,无需强制对齐即可统一处理受限与开放式发音评估任务。
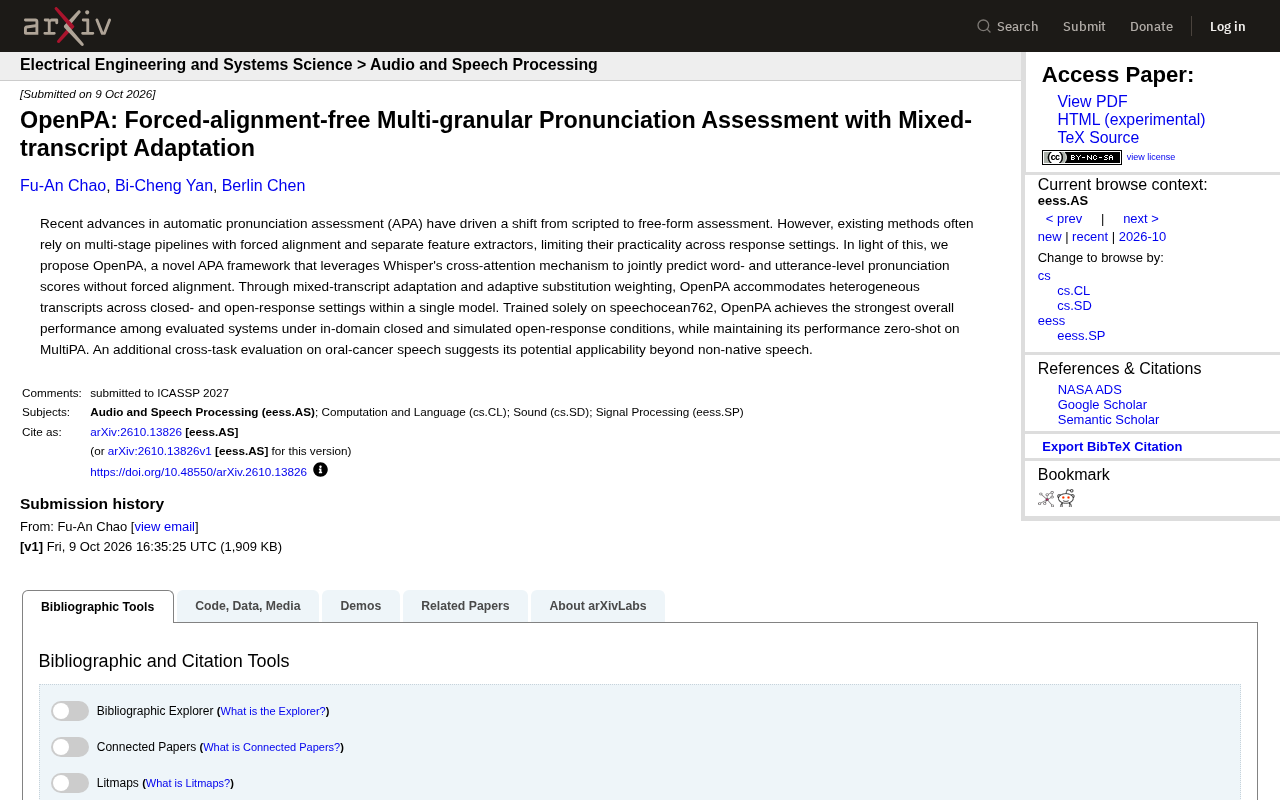
OpenPA是一个基于Whisper模型的多粒度自动发音评估框架,旨在解决传统流水线依赖强制对齐、难以兼容开放式自由作答场景的痛点。其核心创新包括:直接利用Whisper的交叉注意力机制实现音文软对齐、混合转录自适应让单一模型同时处理受限与开放两种作答设置,以及自适应替换加权对发音偏误进行动态评分。实验表明,OpenPA仅在speechocean762数据集上训练,便在域内受限、模拟开放及零样本跨数据集三种条件下均取得领先性能。此外,在口腔癌患者语音上的初步评估暗示该框架有望向病理语音等医疗场景延伸,代表了将大型预训练语音模型能力迁移至下游评估任务的有价值方向。
从脚本朗读到自由作答:发音评估的范式转变
自动发音评估(Automatic Pronunciation Assessment, APA)是语言学习与口语测评技术的核心环节。近年来,这一领域正经历一次重要的范式转变——从依赖固定脚本的受限作答(closed-response),逐步走向开放式的自由作答(open-response)评估。前者要求学习者朗读预先给定的文本,评估系统可以直接比对标准答案;后者则允许学习者自由表达,更贴近真实的语言使用场景。
这种转变带来了更高的实用价值,却也让传统评估方法捉襟见肘。现有系统大多采用多阶段流水线:先做强制对齐(forced alignment),再通过独立的特征提取器获取声学特征,最后输出评分。这种结构在面对不同作答设置时缺乏灵活性,难以在单一模型中兼顾受限与开放两种场景。
OpenPA 的核心思路
针对上述痛点,研究者提出了 OpenPA——一个无需强制对齐的多粒度发音评估框架。它的关键创新在于直接利用 Whisper 模型的交叉注意力(cross-attention)机制,联合预测词级(word-level)和句级(utterance-level)的发音得分。
免除强制对齐的意义
强制对齐是传统 APA 流水线中既耗时又容易出错的环节,它需要将音频帧与文本单元逐一对应。一旦对齐失败或存在误差,后续评分便会受到连锁影响。OpenPA 借助 Whisper 内部已有的注意力机制,让模型在编码过程中自动建立音频与文本之间的软性对应关系,从而绕开了显式的对齐步骤。这不仅简化了系统架构,也提升了对非标准发音、口音乃至语音异常的鲁棒性。
强制对齐的主流工具(如 Montreal Forced Aligner、Kaldi 等)通常依赖声学模型和发音词典,将连续语音流切割成与每个音素或词对应的时间区间。这一过程对母语者标准语音效果较好,但对外语学习者的偏误发音、方言口音或病理语音则常常产生严重的对齐漂移——系统可能将发错的音素强行映射到最相近的词边界,导致后续的发音评分基于错误的时间对应关系。Whisper 的交叉注意力矩阵天然编码了解码器文本 token 与编码器音频帧之间的软性关联权重,无需任何硬性切割即可反映"哪段音频对应哪个词"。OpenPA 直接读取这些注意力权重作为音文对齐的隐式依据,规避了显式对齐的脆弱性,同时也免去了维护额外发音词典的成本。
混合转录自适应与自适应替换加权
OpenPA 的另两项关键技术是混合转录自适应(mixed-transcript adaptation)和自适应替换加权(adaptive substitution weighting)。前者让同一个模型能够处理来自受限作答和开放作答两种设置的异构转录文本,意味着无需为不同场景训练独立模型;后者则在评分时对发音替换错误进行动态加权,使模型更精准地捕捉实际发音与目标发音之间的偏差。
这两项设计共同保证了 OpenPA 的通用性——它能够在一个统一框架内灵活适应多样的输入条件,而不是针对每种任务做定制化开发。
在受限作答场景中,参考文本(即学习者应朗读的内容)是已知的,模型可以直接利用标准转录;而在开放作答场景中,参考文本并不存在,系统只能使用 ASR 自动生成的转录,其中可能包含识别错误。混合转录自适应的核心思想是在训练阶段同时喂入两类转录来源,让模型学会在二者之间切换,而非对某一类型产生偏差依赖。自适应替换加权则针对发音评估中一个经典难题:当学习者将目标音素替换为另一个音素时(例如把 /θ/ 发成 /s/),不同替换对发音质量的影响程度差异很大,简单地将所有替换视为等权重错误会导致评分失真。该机制根据替换的语音距离或频率动态调整惩罚权重,从而使最终得分更贴近人类评分者的判断。
实验表现与泛化能力
OpenPA 仅在 speechocean762 数据集上进行训练,却在多个评估条件下展现出领先的综合性能。
- 域内受限作答:在与训练数据同分布的受限场景中,OpenPA 在所有参评系统中取得最强的整体表现。
- 模拟开放作答:在模拟的开放式作答条件下,OpenPA 同样保持优势,验证了混合转录自适应的有效性。
- 零样本迁移:在未见过的 MultiPA 数据集上,OpenPA 实现了零样本(zero-shot)性能保持,说明其学到的发音评估能力具有良好的跨数据集泛化性。
更具启发性的是,研究者还在口腔癌患者语音上进行了跨任务评估。初步结果表明,OpenPA 的适用范围可能超越非母语者语音,延伸至病理性语音评估等医疗相关场景。这为语音技术在临床康复、言语治疗等领域的应用打开了想象空间。
speechocean762 是目前发音评估领域最常用的公开基准数据集,包含约 5000 条英语母语者和非母语者的句子级录音,并配有音素、词、句三个粒度的人工评分标签,广泛用于衡量 APA 系统的词级准确度与句级流利度预测能力。MultiPA 则是一个覆盖多种语言和口音的多样化测评集,常被用于验证模型的跨分布泛化性。在 MultiPA 上实现"零样本性能保持"意味着 OpenPA 无需在该数据集上进行任何微调或标注,仅凭在 speechocean762 上学到的表征即可维持具有竞争力的评分能力,这一结果直接证明了模型所学特征的语言泛用性而非对单一数据集的过拟合。
技术价值与潜在应用
OpenPA 的意义不仅在于刷新了基准数据集上的指标,更在于它用一种更简洁、更统一的方式重构了发音评估的技术路径。免除强制对齐降低了部署门槛,混合转录机制提升了场景适应力,而跨任务的初步验证则暗示了其方法论的通用性。
对于语言学习应用而言,这意味着可以用单一模型支撑从课堂跟读到自由对话的全链路口语测评;对于医疗语音分析而言,它提供了一个无需大量标注即可迁移的潜在工具。当然,口腔癌语音上的结果目前仅为初步探索,距离实际临床落地仍需更多数据与验证。
整体来看,OpenPA 代表了将大规模预训练语音模型(如 Whisper)的内在能力,直接迁移到下游评估任务的一个有价值的方向。随着自由作答评估需求的增长,这类免对齐、强泛化的框架有望成为新的技术主流。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。