OpenRouter数据揭示:DeepSeek独占53%流量,开源模型占比超75%

OpenRouter单日27万亿token中DeepSeek占53%,开源模型合计超75%,揭示聚合平台流量转向。
OpenRouter 最新数据显示,单日 27 万亿 token 消耗中 DeepSeek 独占 53%,开源权重模型合计超过 75%,而 8 个月前 OpenAI 和 Anthropic 还是最大提供方。社区讨论认为,这一转向源于 DeepSeek 等模型以极低成本提供接近前沿的推理能力。用户选择 OpenRouter 而非官方 API 主要出于统一密钥管理、灵活切换、数据留存策略和按需付费。但体验上,DeepSeek 官方端点在 OpenRouter 上吞吐量仅为直连的几分之一,优先级明显偏低。这组数据表明开源模型竞争力已进入实际用量验证阶段,聚合平台的核心价值在于降低多模型试验的摩擦成本。
OpenRouter 最新数据在社区引发热议:单日 27 万亿 token 中,DeepSeek 一家占据 53%,开源权重模型整体流量占比突破 75%。这组数字背后,是 API 聚合平台使用习惯与模型竞争力的微妙博弈。
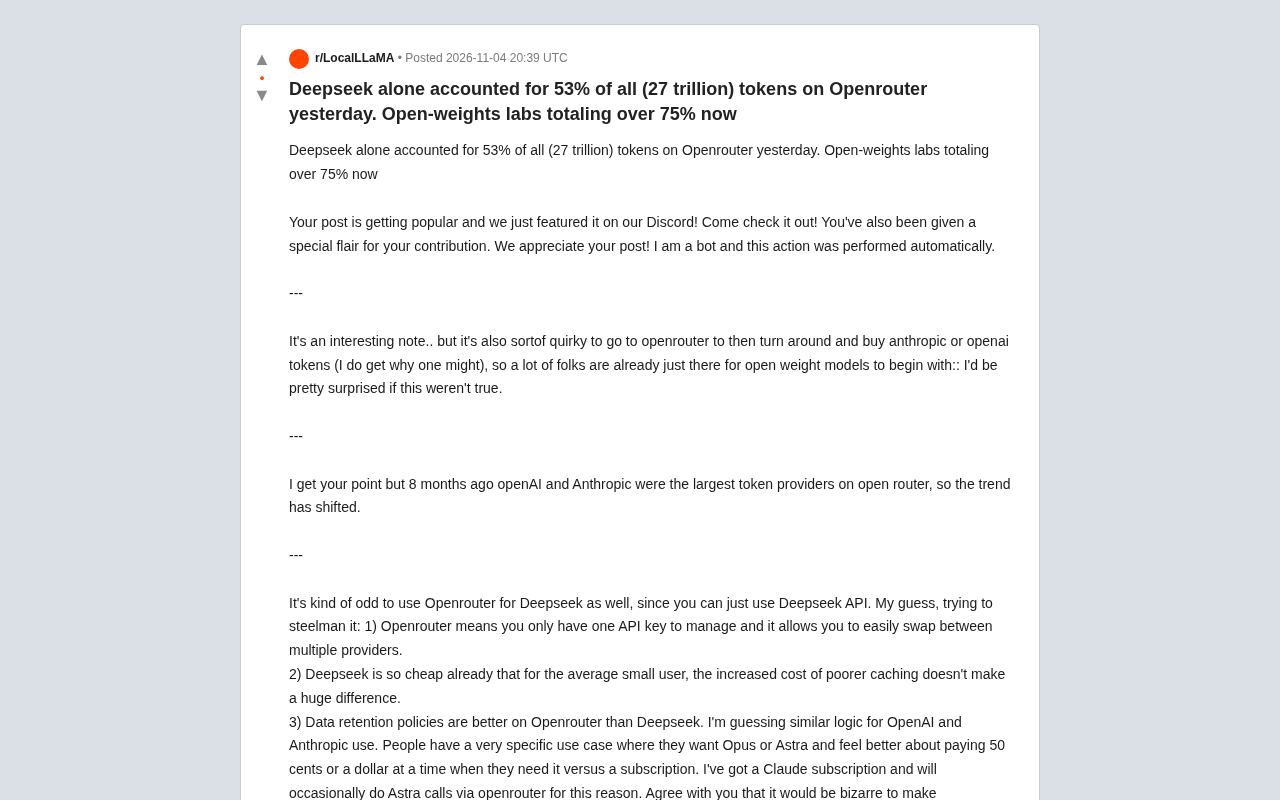
数据解读:开源模型正在主导聚合平台
据 Reddit 社区分享,OpenRouter 前一日总消耗 27 万亿 token,其中 DeepSeek广告 独占 53%,所有开源权重实验室合计超过 75%。这意味着在 OpenRouter 这个聚合入口上,闭源巨头 OpenAI 与 Anthropic 的流量份额已被开源阵营大幅挤压。
有评论指出,8 个月前 OpenAI 和 Anthropic 还是 OpenRouter 上最大的 token 提供方,如今趋势已明显转向。这一变化并非偶然——DeepSeek 等模型以极低成本提供了接近前沿水平的推理能力,对价格敏感的开发者和中小团队形成了强吸引力。
需要留意的是,OpenRouter 的用户构成本身偏向开源模型尝鲜者,因此 75% 的占比不能直接等同于全市场格局。但它至少说明:在“多模型切换”这一典型场景下,开源权重模型已成为默认选项。
OpenRouter 是一个 API 聚合平台,开发者通过单一接口即可调用 OpenAI、Anthropic、DeepSeek 等多家供应商的模型。平台按 token 用量计费,并支持自动路由、回退和成本优化。其流量数据常被用作观察模型实际使用趋势的窗口,但需注意其用户群体偏向技术尝鲜者和多模型开发者,并非全市场随机样本。
开源权重模型指模型参数公开可下载、允许自行部署或微调的模型,如 DeepSeek、Llama 系列。与完全闭源的 GPT-4、Claude 不同,开源权重模型可由第三方托管服务提供 API,OpenRouter 上的流量正是这类托管调用的集合。
为什么用户选择 OpenRouter 而非官方 API?
一个直接的问题:既然 DeepSeek 有自己的 API,为什么还要绕道 OpenRouter?社区讨论给出了几个务实理由。
统一密钥管理与灵活切换是首要因素。OpenRouter 让开发者只维护一个 API key,就能在多家供应商之间快速切换,省去逐个平台注册、充值、管理密钥的麻烦。
成本与缓存权衡。有用户指出,DeepSeek 本身价格极低,对普通小用户而言,OpenRouter 上缓存效率略差带来的额外成本几乎可以忽略。
数据留存策略。部分用户认为 OpenRouter 的数据保留政策比直接使用 DeepSeek 更友好,这成为选择聚合平台的实际考量。
此外,对于偶尔需要调用 Claude Opus 等高价模型的用户,按次付费比订阅更划算——有用户表示自己持有 Claude 订阅,但偶尔通过 OpenRouter 发起单次调用。
缓存效率在 API 聚合场景中指上游供应商对重复提示词前缀的缓存命中能力。直连官方 API 时,缓存策略由该供应商统一管理,命中率通常更高;而通过 OpenRouter 转发时,请求可能经过额外路由层,缓存收益可能被稀释。对于高频重复调用同一系统提示词的用户,缓存差异会直接影响实际成本,尽管 DeepSeek 本身单价极低,使这一影响在中小用量下并不显著。
体验落差:官方端点优先级更高
讨论中也出现了对 OpenRouter 上 DeepSeek 官方端点的质疑。有用户直言,DeepSeek 在 OpenRouter 上的官方端点属于“二等公民”:吞吐量仅为直连的几分之一,可用性也不稳定,明显在优先保障自家直连用户。
另一位用户分享了自己的迁移经历:几个月前在 OpenRouter 上试用 DeepSeek,随后转向直连,日常解码速度可达 250–350 t/s,且能第一时间用上新模型。他还提到此前获得的 50 美元服务额度,一个月后仍剩 26 美元,侧面印证了 DeepSeek 的定价之低。
不过也有用户补充,OpenRouter 允许将个人 API key 转发给上游服务,配置得当可以获得与直连相近的体验。
官方端点指模型厂商在聚合平台上直接提供的 API 接入点,与第三方托管商提供的同一模型端点相区分。厂商通常优先保障自有直连渠道的吞吐量和可用性,分配给聚合平台的资源相对有限,这解释了社区观察到的“二等公民”现象。用户可通过在 OpenRouter 配置个人 API key 转发,绕过平台共享池,从而获得接近直连的体验。
数据背后的信号
这组数字至少传递了两个信号。其一,开源权重模型的竞争力已从“参数追平”进入“实际用量验证”阶段,开发者用 token 投票的结果比 benchmark 更直接。其二,聚合平台的价值不在于替代官方 API,而在于降低多模型试验的摩擦成本——统一计费、灵活切换、按需付费,这些需求真实存在。
至于 75% 的开源占比能维持多久,取决于闭源模型能否在价格或能力上重新拉开差距。至少在当下,OpenRouter 的流量分布已经给出了一个清晰的答案。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。