OpenScience:开源AI科研工作台,让智能体自主做实验

OpenScience是一款开源AI科研智能体,可自主完成从读论文到在集群上跑实验的完整研究流程。
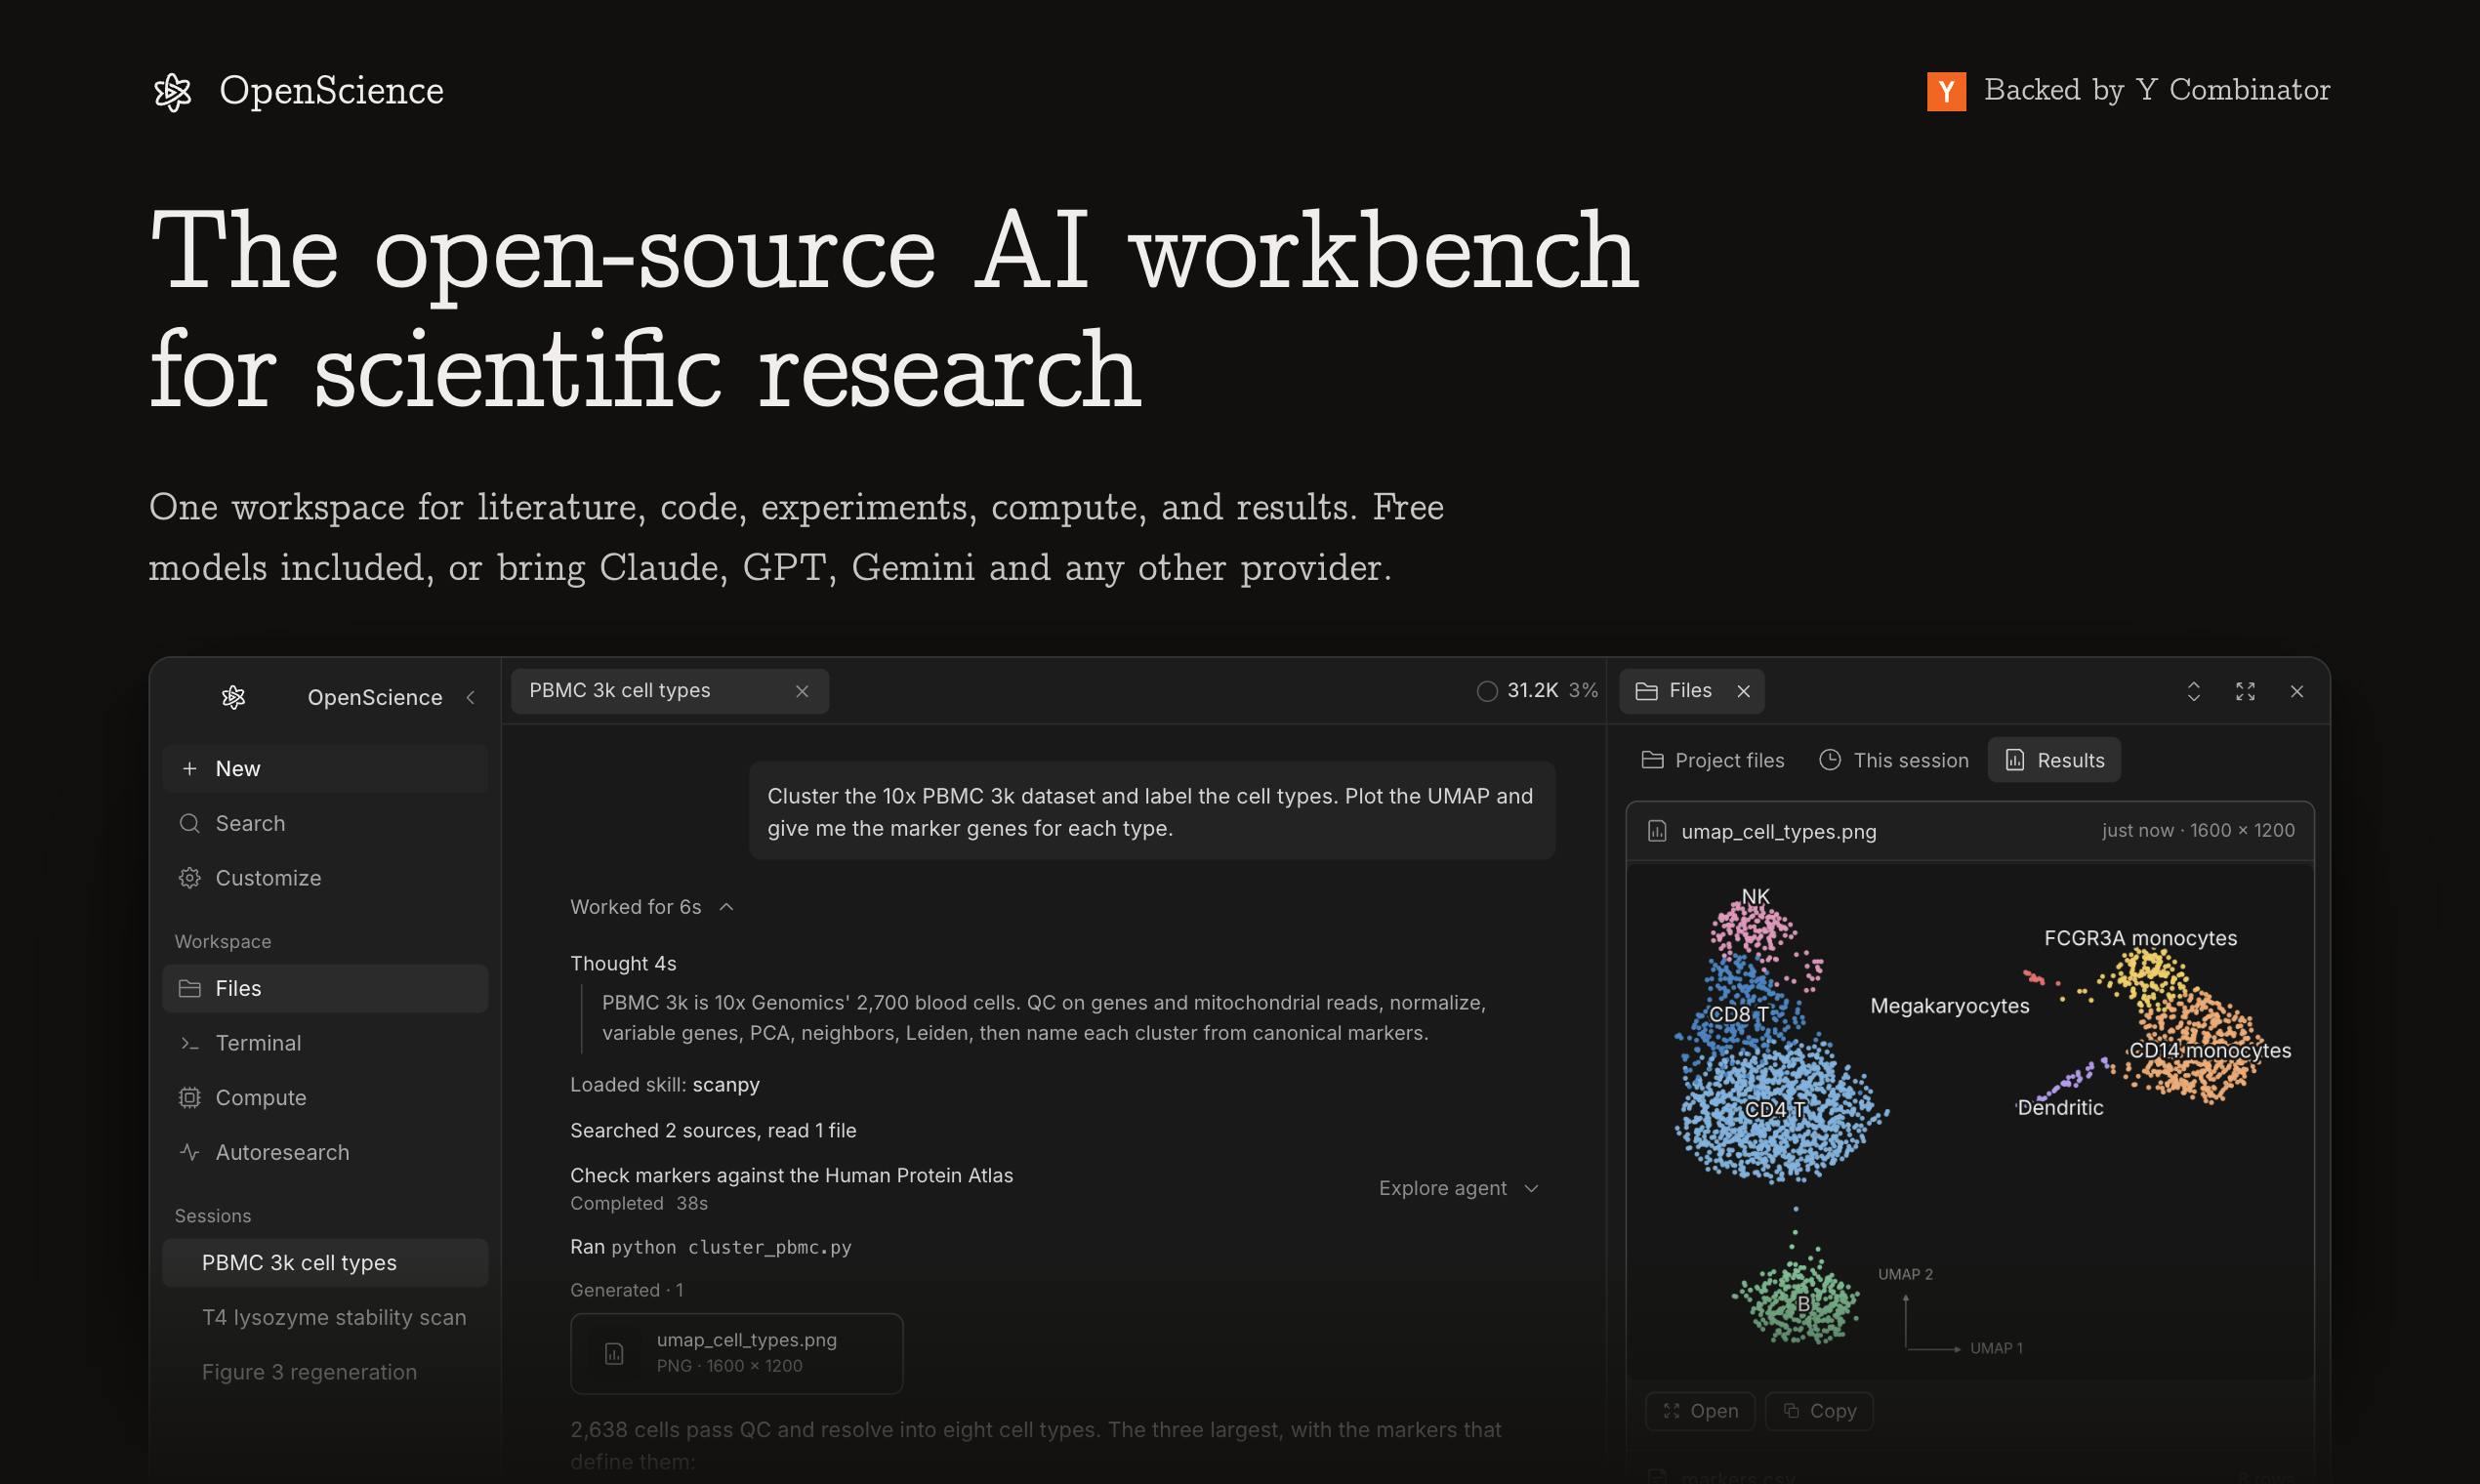
OpenScience是一个面向科学研究的开源AI智能体工作台,目标是将文献阅读、代码编写与执行、算力调度以及自动实验迭代整合进统一框架。它支持将长时任务发送至Modal云平台、用户自有服务器或Slurm/PBS高性能集群,并通过Autoresearch功能依据给定指标自动运行「爬山式」优化循环。在模型接入上,项目支持30余种模型、ChatGPT登录及本地部署,完全免费开源。但该项目目前仍处早期阶段,其「基准第一」的说法缺乏公开细节,自动优化指标也可能带来结果可信度问题,实际价值有待社区在真实场景中验证。
科学研究正在成为AI智能体的下一个主战场。近期登陆Product Hunt的开源项目 OpenScience 给出了一个颇具野心的答案——一个能读论文、写代码、跑实验,并在计算集群上自主推进研究任务的AI科研工作台。它自称在多项智能体科研基准测试中排名第一,且完全免费开源。
OpenScience 想解决什么问题
科研工作流的复杂性远超普通编程任务。研究者需要阅读大量文献、设计实验、编写并运行代码、在不同计算环境间调度长时任务,还要对每一次实验结果进行追踪与迭代。这些环节高度碎片化,跨越了阅读工具、Jupyter Notebook、终端和高性能计算集群。
OpenScience 的定位是把这些环节整合进一个统一的AI工作台。用官方的描述来说,它是「面向科学研究的开源AI智能体」——不只是一个聊天助手,而是一个能够端到端参与研究流程的自动化工具。
核心能力:从读论文到跑集群
从项目介绍来看,OpenScience 的能力覆盖了科研的多个关键节点:
文献理解与代码执行
它能够阅读论文、编写并运行代码,同时在 Notebook 和终端环境中工作。这意味着研究者可以让智能体基于论文内容直接生成可运行的实验代码,缩短从「读到方法」到「复现结果」的距离。
长任务的算力调度
OpenScience 的一个突出特点是对计算资源的灵活支持。对于耗时较长的作业,它可以将任务发送到 Modal(云端无服务器计算平台)、用户自有的服务器,或者 Slurm/PBS 集群。这一点对真正的科研场景至关重要——机器学习训练、数值模拟等任务往往需要数小时甚至数天,本地环境难以承载。
Slurm(Simple Linux Utility for Resource Management)和 PBS(Portable Batch System)是学术界高性能计算集群最主流的两种作业调度系统。研究者通过提交作业脚本,由调度器统一分配 CPU、GPU 和内存资源,任务可以在队列中等待并在节点空闲时自动执行,无需人工盯守。Modal 则是近年兴起的云端无服务器计算平台,主打按需启动 GPU 容器,无需预置服务器,适合突发性的计算需求。OpenScience 同时支持这三类环境,意味着无论是依赖校园集群的高校研究者,还是使用云资源的独立研究者,都能将任务提交逻辑统一在同一个智能体框架内管理,避免在不同系统间手动切换脚本和环境配置。
Autoresearch 自动实验循环
最能体现「智能体」属性的是 Autoresearch 功能。研究者只需给定一个评估指标(metric),系统就会自动运行实验、记录每一次结果,并持续进行「爬山式」优化(hill-climbing),不断朝着更好的指标结果迭代。这种自动化的实验-记录-优化闭环,正是科研智能体区别于普通代码助手的核心。
「爬山算法」(Hill Climbing)是一种局部搜索启发式优化方法:从当前状态出发,每次只向能改善目标指标的方向迈出一步,直到找不到更优的相邻状态为止。它的优点是实现简单、计算开销低,缺点是容易陷入局部最优而错过全局最优解。在自动化科研实验中,这一策略的实际效果高度依赖评估指标的选取质量——如果指标本身不能完整反映研究目标(例如仅优化验证集准确率而忽视泛化能力),系统可能生成看似指标优异却缺乏实际意义的实验结果。这也是文章后续「冷静观察」部分提醒研究者需在关键节点主动介入的核心原因。
模型接入与开源策略
在模型接入方面,OpenScience 支持通过单一钱包调用 30 多种模型,用户也可以使用 ChatGPT 账号登录,或直接运行本地模型。这种多模型、多入口的设计降低了使用门槛,也给了对数据隐私敏感的研究者本地部署的选项。
项目强调「免费且开源」,这在当前科研AI工具普遍走向商业化订阅的背景下,是一个明确的差异化定位。开源意味着研究者可以审查、修改并自行部署,这对追求可复现性和透明度的学术界尤为契合。
一点冷静的观察
值得留意的是,OpenScience 目前在 Product Hunt 上的社区反馈还较为有限——发布时投票数与评论数都不高,产品尚处于早期阶段。项目宣称「在智能体科研基准测试中排名第一」,但具体的基准细节、对比对象和评测方法在现有介绍中并未充分展开,读者对这一说法应保持理性看待。
此外,让AI智能体自主设计并运行实验,也带来了结果可信度、实验设计合理性等新问题。自动「爬山」优化指标虽然高效,但也可能陷入指标本身的局限,需要研究者在关键节点介入判断。
对科研工作流意味着什么
抛开早期产品的不确定性,OpenScience 代表的方向值得关注:AI 智能体正从写代码、答问题,走向承担更完整的科研任务链条。把文献阅读、代码执行、算力调度和自动实验整合在一个开源框架里,如果能持续打磨,确实有可能改变部分研究者的日常工作方式。
对于有能力自行部署、且工作涉及大量实验迭代的团队而言,这类开源工作台提供了一个低成本试水AI科研自动化的入口。而它究竟能在多大程度上兑现「AI科研工作台」的承诺,仍有待社区在真实场景中检验。
相关推荐

Copilot Studio 中的 MCP 协议:标准化连接 AI 代理与外部系统
本文解析 Model Context Protocol(MCP)在 Copilot Studio 中的作用:作为一种开放协议,MCP 让 AI 代理以标准化方式连接客户信息、订单详情等外部工具和数据源,省去逐一定制集成的成本。

死刑流水线:佛罗里达如何加速处决,又如何制造冤案
Vox播客《The Gray Area》对话调查记者Pamela Koloff,揭示佛罗里达死刑制度如何从"炼狱"变成加速处决的"流水线",以及监狱线人证词如何制造死刑冤案。四分之一死刑平反案涉及监狱线人。

MCP协议详解:让AI连接GitHub、数据库等外部工具的标准
MCP(模型上下文协议)是让AI应用连接GitHub、数据库等外部工具的统一标准。本文解析MCP Server的tools、resources、prompts三类能力、GitHub MCP实例、对开发者的价值以及权限安全要点。