OpenTWBench:台湾知识评测基准揭示评分体系如何左右模型得分

OpenTWBench 用同题对照证明,评测装置差异可让准确率从 20.8% 跳到 93.9%,分数不只是模型的故事。
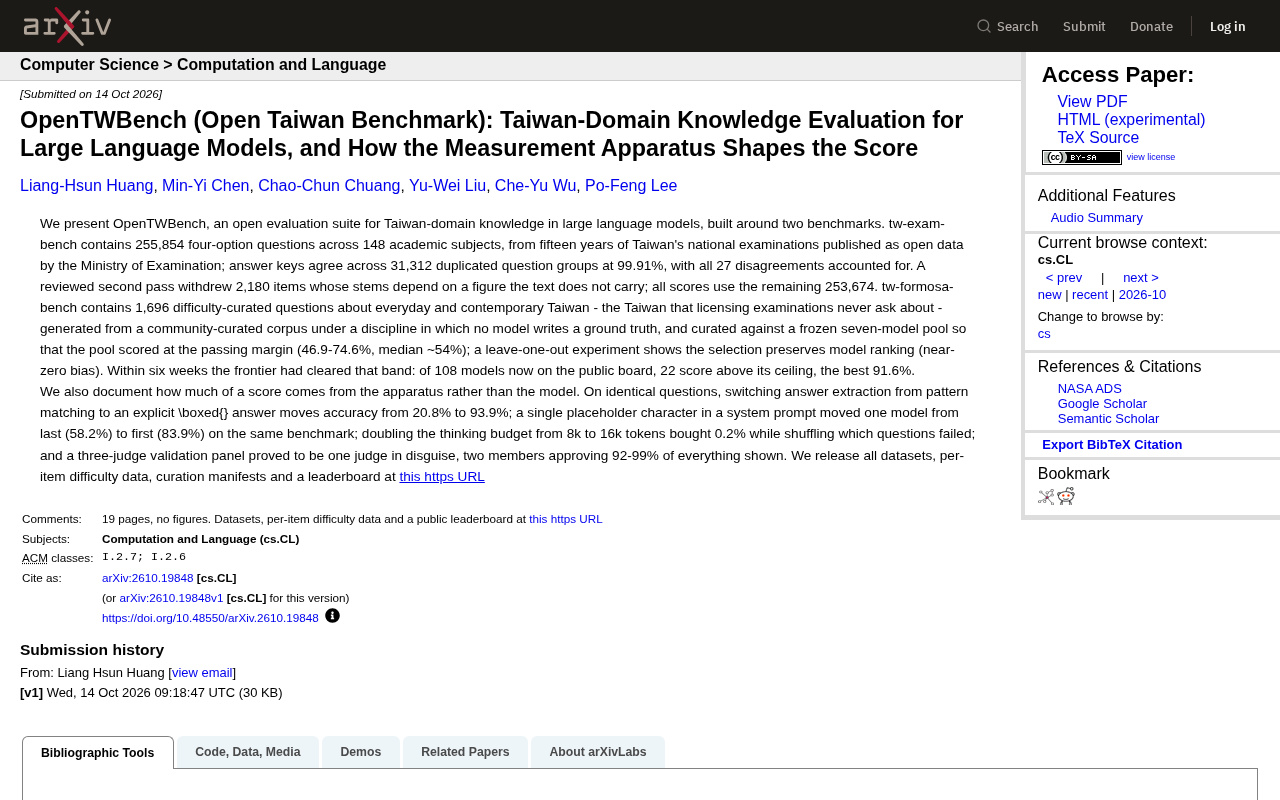
OpenTWBench 是一套开源评测套件,包含基于台湾十五年国考题的 tw-exam-bench(25 万余道四选一题)和社区生成、覆盖当代台湾日常的 tw-formosa-bench(1,696 道难度分级题)。其核心贡献不是台湾知识本身,而是量化了评测装置对分数的影响:同题仅改变答案抽取方式(模式匹配改为显式 \boxed{}),准确率从 20.8% 升至 93.9%;系统提示加一个占位字符即可让模型从末位跃居首位;思考预算翻倍仅带来 0.2% 提升;三评审小组退化为单评审,两名成员批准率达 92%–99%。此外,精心校准的难度区间六周内即被攻破,揭示了静态基准的"难度寿命"问题。作者呼吁报告统一抽取规范与提示协议,否则跨模型、跨版本、跨时间的分数比较可能只是装置差异的产物。
大型语言模型的评测分数,常被当作模型能力的直接体现。但一项新发布的开放评测套件 OpenTWBench 给出了一个令人不安的观察:在完全相同的题目上,仅改变答案抽取方式,准确率可以从 20.8% 跳到 93.9%。这意味着相当一部分"模型能力"的差异,实际来自评测装置本身,而非模型。
两个基准:学术考试与当代台湾日常
OpenTWBench 围绕两个互补的基准构建。
第一个是 tw-exam-bench,数据来自台湾考选部以开放数据形式发布的十五年国家考试题目,涵盖 148 个学科、共 255,854 道四选一选择题。这类数据天然带有高质量属性:在 31,312 组重复题目中,答案键的一致率达到 99.91%,仅有的 27 处分歧也被逐一核实归因。
经过人工复核的第二轮筛选,移除了 2,180 道题干依赖图片、但文本中未携带该图片的题目。所有最终得分均基于剩余 253,674 道题计算。这一处理细节很重要——它说明基准构建者意识到,题目本身的呈现缺陷会直接污染评测结果。
第二个是 tw-formosa-bench,由社区整理的语料生成,包含 1,696 道关于当代台湾日常生活的难度分级题目。它的定位刻意区别于考试题:这是执照考试永远不会问的那个台湾。生成过程中有一条纪律——任何模型都不参与撰写标准答案,且题目集是针对一个冻结的七模型池进行筛选的,使该池的得分被控制在及格边缘(46.9%–74.6%,中位数约 54%)。留一法实验显示,这种筛选保持了模型排名(偏差接近于零)。
不过这个精心设计的难度窗口只维持了很短时间。六周之内,前沿模型就清空了这一区间:公共榜单上现有 108 个模型,其中 22 个超过该基准的上限,最好的达到 91.6%。这本身就是一个值得记录的动态——静态基准的"难度寿命"正在缩短。
分数中有多少来自装置,而非模型
OpenTWBench 最具价值的部分,是它对评测装置影响的量化。
答案抽取方式。在相同题目上,把答案抽取从模式匹配改为显式的 \boxed{} 答案,准确率从 20.8% 提升到 93.9%。这是本文最刺眼的一组数字——同一模型、同一题目,仅抽取逻辑不同,分数差了四倍以上。
系统提示中的占位符。仅仅在系统提示里加入一个占位字符,就能让某个模型在同一基准上从最后一名(58.2%)跃升至第一名(83.9%)。
思考预算。把思考 token 预算从 8k 翻倍到 16k,只换来 0.2% 的提升,同时改变了失败题目的分布——也就是说,更多的计算并没有让模型"更聪明",只是在重排它的错误。
评审团退化。一个由三名评审组成的验证小组,最终被证明是"一名评审的伪装":其中两名成员对展示内容批准了 92%–99%。这直接动摇了多评审验证的可靠性假设。
答案抽取(answer extraction)与 \boxed{} 格式:在大模型评测流程中,模型通常以自然语言作答,而评测脚本需要从中"抠"出最终答案再与标准答案比对。早期的模式匹配(正则匹配数字、选项字母等)依赖模型输出格式的稳定性,一旦模型改变表述风格——比如把答案藏在推理过程中、用中文数字、或在末尾重复多个候选——抽取就会失败,从而把答对的题判为错误。\boxed{} 是 LaTeX 中给公式加方框的命令,被数学推理类基准广泛用作"最终答案"的显式分隔符。要求模型把答案写进 \boxed{},等于让输出格式与抽取逻辑之间建立强约定,几乎消除了歧义。OpenTWBench 展示的 20.8%→93.9% 落差,本质上不是模型变强,而是抽取失败率被消除。这提示评测者:任何声称的"准确率"都必须连同抽取规范一起报告,否则不可复现、不可比较。
思考预算(thinking budget)与测试时计算:对于具备显式推理能力的模型(如输出思维链或内部推理 token 的模型),思考预算指允许其消耗的推理 token 上限。扩大预算属于"测试时计算扩展"(test-time compute scaling),直觉上应带来能力提升。但 OpenTWBench 观察到 8k→16k 仅带来 0.2% 的提升,且失败题目的分布发生变化。这说明额外的推理计算并不必然转化为更正确的答案,可能只是在错误的推理路径上更长的徘徊,或把原本蒙对的题目改错。评测中若不固定思考预算,同一模型的分数就不可比——预算实际上成了一个隐藏的超参数。
为什么这些发现值得认真对待
当前业界大量模型对比、榜单排名和"能力提升"叙事,建立在一个隐含假设上:评测装置是透明的、中性的。OpenTWBench 用同题对照实验打破了这一假设。
装置效应的影响范围被低估了。当抽取方式的改变能带来 73 个百分点的差异,当系统提示中的一个字符能重排榜单首尾,那么跨机构、跨版本、跨时间的分数比较就需要格外谨慎。没有统一的抽取规范与提示协议,"模型 A 比模型 B 高 5 分"这样的结论可能只是装置差异的产物。
另一层含义与基准的生命周期有关。tw-formosa-bench 针对冻结模型池精心校准的难度区间,在六周内就被攻破。这说明基准的难度不是恒定属性——它随模型能力漂移。设计者要么接受基准的快速饱和,要么建立持续更新机制。
LLM-as-a-judge 与评审团退化:由于开放式回答难以用精确匹配评分,业界普遍采用"用模型当评委"(LLM-as-a-judge)的方法,并常以多个评委取多数或平均来提高可靠性。其隐含假设是评委之间相互独立、能发现彼此的错误。OpenTWBench 观察到的"评审团退化"——三名评委实为一名评委的伪装、两名成员批准率高达 92%–99%——直接挑战了这一假设。当同一模型或同一提示模板被复用来生成多个评委时,它们的判断高度相关,评审团提供的不是独立冗余,而是同一种偏见的重复。这要求评测设计者报告评委的独立性来源(模型、提示、温度、评分维度是否真正分化),而非仅以数量论可靠性。
基准饱和与难度寿命:静态基准随发布时间推移会被新模型逐步攻破,最终分数趋近上限而失去区分度,这一现象称为基准饱和(benchmark saturation)。OpenTWBench 的价值在于给出了一个量化的"难度寿命"案例:tw-formosa-bench 针对冻结模型池校准出的及格边缘难度窗口(46.9%–74.6%),六周内即被前沿模型突破,108 个模型中有 22 个超越原上限。这说明基准设计不能假设难度恒定,而应预先规划更新机制,或转向动态对抗式评测(如持续生成新题、对抗性题目池)。
开放资产
OpenTWBench 团队释放了全部数据集、逐题难度数据、筛选清单,以及一个公开榜单(https://opentwbench.ai)。逐题难度数据的公开尤其关键:它让外部研究者能够独立复现装置效应实验,也让"有多少分数来自装置"这个问题从个案观察变成可系统检验的对象。
对评测工作者来说,这套工具的真正价值或许不在台湾知识本身,而在于它把评测方法论的问题摆到了台面上——分数从来不只是模型的故事。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。