OpShield:AI代理的开源安全平台

开源项目OpShield为AI代理提供工具调用层的风险拦截、成本管控与状态回滚能力。
OpShield是一个面向AI代理的开源安全中间件,核心思路是在工具调用这一层进行拦截与决策,对每次调用做风险分级(LOW到CRITICAL),高风险操作可自动阻断。它提供预算强制、成本预测和熔断器以防止代理失控消耗资源,通过状态快照实现「一次调用回滚」降低错误操作的不可逆风险,并内置OpenTelemetry兼容追踪、代理评分和混沌工程模块。项目主打零依赖,兼容OpenAI、Anthropic、LangChain、CrewAI、AutoGen及任意Python函数。其背景是Guardrails AI被Harvey收购后,市场缺乏独立、可自托管的安全替代方案。不过目前仅有作者自述,实际效果仍需第三方验证。
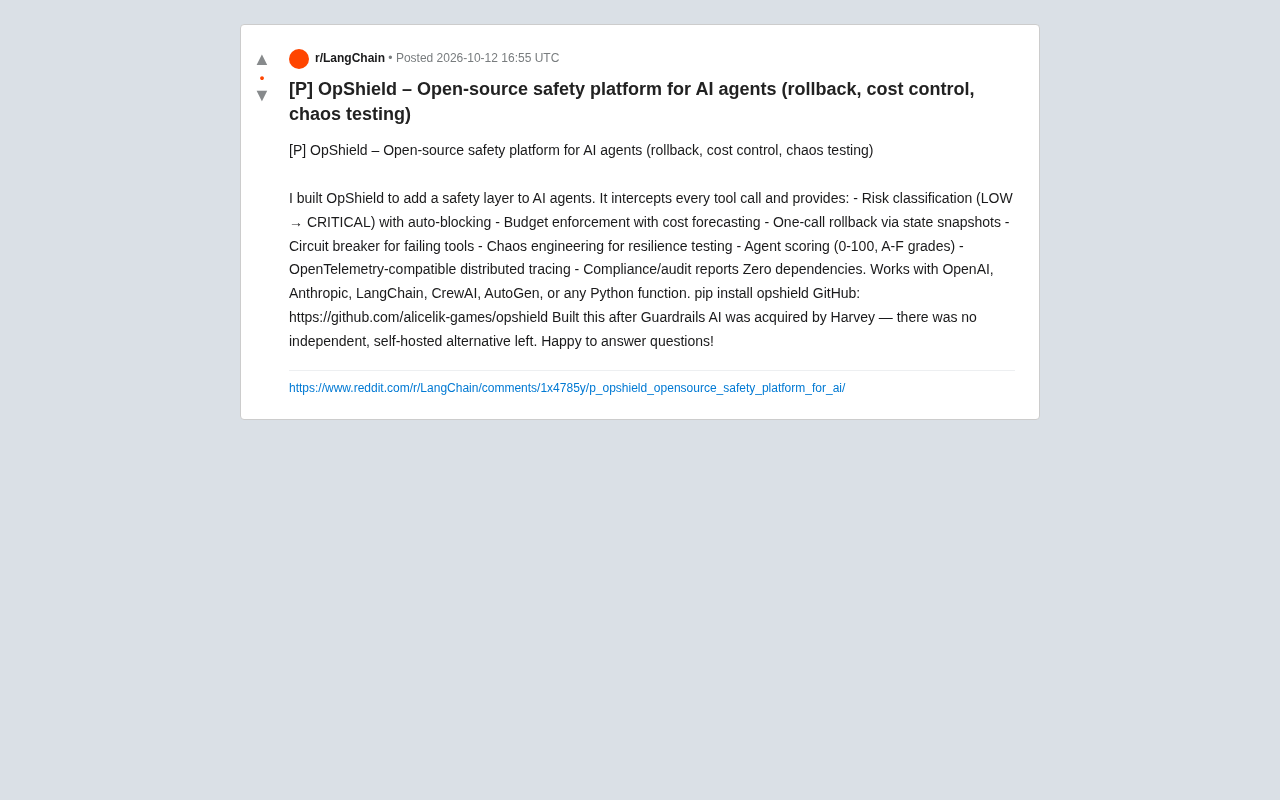
在AI代理逐步走向生产环境的过程中,安全与成本控制正在成为开发者无法回避的两大难题。Reddit社区最近出现的一个开源项目OpShield,试图用一层「安全中间件」来回答这个问题——它拦截每一次工具调用,并在此基础上提供风险分类、预算管控、状态回滚和混沌测试等能力。作者在帖子中明确表示,这个项目的诞生背景,是Guardrails AI被Harvey收购之后,市场上缺少一个独立、可自托管的安全替代方案。
为什么AI代理需要专门的安全层
传统软件的安全边界相对清晰:输入校验、权限控制、日志审计都有成熟方案。但AI代理的运行模式完全不同——它会自主决定调用哪些工具、以什么顺序调用、消耗多少资源。一次失控的循环可能让API账单飙升,一次错误的数据库操作可能造成不可逆的数据损坏。
OpShield的核心思路是「拦截+决策」。它工作在工具调用这一层,每个工具调用都会经过风险分类引擎,被打上LOW到CRITICAL的等级。高风险调用可以被自动阻断,而不需要开发者手动写一堆if-else。这种设计把安全策略从业务代码中抽离出来,变成可配置的基础设施。
Guardrails AI是一个开源的LLM输出校验框架,允许开发者对模型生成的内容施加格式约束、内容过滤和自定义验证规则,曾被广泛用于在推理链末端拦截不合规输出。2024年,该团队被AI法律科技公司Harvey收购,核心成员并入Harvey,原项目的独立发展节奏和社区维护力度随之减弱。对于不希望把安全策略绑定在单一商业实体上的团队而言,这意味着原本可依赖的开源安全层出现了一个空缺。OpShield所回应的,正是这种对「中立、可自托管、可持续演进」的安全中间件的需求,而不是单纯地替代某个具体功能。
核心功能拆解:从预算到回滚
OpShield的功能列表相当密集,但大致可以归为三类。
成本与稳定性控制方面,它提供预算强制和成本预测。代理在调用工具前,系统会预估这次调用可能产生的费用,并与设定的预算阈值比对。当工具连续失败时,熔断器(circuit breaker)会自动切断对该工具的调用,避免代理陷入无效重试的泥潭。
状态管理方面,OpShield支持通过状态快照实现「一次调用回滚」。这意味着当代理执行了错误操作后,开发者可以快速恢复到之前的已知状态,而不必手动重建环境。对于涉及文件写入或数据库变更的代理来说,这个能力的价值很直接。
可观测性与测试方面,项目内置了OpenTelemetry兼容的分布式追踪,以及代理评分系统(0-100分,A-F等级)。此外还有混沌工程模块,用来测试代理在不稳定环境下的韧性——比如模拟工具超时、返回错误数据等场景。
熔断器(circuit breaker)来自分布式系统的经典容错模式。它的基本逻辑是:当某个下游依赖连续失败达到阈值时,调用方不再继续尝试,而是直接返回失败或降级结果,经过一段冷却期后再试探性放行。在AI代理场景中,这一模式尤其重要——代理常常基于「重试」策略自动恢复,但工具本身若已不可用,重试只会放大延迟和成本,甚至触发限流惩罚。熔断器把这种无效循环从代理决策逻辑中剥离出来,交给基础设施层统一处理,从而避免账单和调用配额被持续消耗。
兼容性与零依赖的取舍
OpShield声称「零依赖」,并且可以配合OpenAI、Anthropic、LangChain、CrewAI、AutoGen或任意Python函数使用。这个定位意味着它不想绑定特定的代理框架,而是希望在框架和工具之间做一个通用的中间层。
从工程角度看,零依赖的好处是部署简单、冲突少,尤其适合已经在复杂依赖环境中的项目。但代价是,某些高级功能(比如与特定可观测性平台的深度集成)可能需要开发者自行适配。项目作者在帖子中欢迎提问,说明目前仍处于早期迭代阶段,社区反馈可能会影响后续的功能优先级。
状态快照(snapshot)与回滚通常需要在每次工具调用前后记录系统状态,可能涉及文件系统、内存状态甚至外部数据库的序列化。在代理执行文件写入或数据变更时,快照相当于为「一次调用」建立还原点,使错误操作可被撤销。不过快照的代价也需正视:频繁快照会带来存储和IO开销,且并非所有副作用都可完全捕获,例如已发出且不可撤回的外部API请求。因此回滚能力通常更适合作用在可控的本地状态或可逆事务上,开发者需要根据具体工具评估其实际保障边界。
独立自托管的价值
Guardrails AI被Harvey收购后,部分开发者对「安全层」的独立性和数据主权产生了担忧。OpShield强调自托管和开源,直接回应了这部分需求。对于处理敏感数据或运行在合规要求较高环境中的团队来说,能够自己掌控安全策略的执行位置和日志流向,往往比功能丰富度更重要。
不过说一下,OpShield目前的信息主要来自作者本人的发布帖,尚未看到第三方的独立评测或生产环境案例。它的实际拦截准确率、回滚机制的可靠性、以及在大规模代理集群中的性能表现,都还需要更多验证。对于考虑采用的团队,建议先在非关键路径上做小范围测试,重点观察误拦截率和快照存储的开销。
项目已在GitHub开源,可以通过pip install opshield安装。
OpenTelemetry(OTel)是一套与厂商无关的可观测性标准,涵盖分布式追踪、指标和日志三类信号。它定义了数据如何被采集、传播和导出,使得同一份追踪数据可以发送到Jaeger、Grafana Tempo、Datadog等不同后端。对AI代理而言,OTel兼容意味着每次工具调用、决策分支和耗时都能以标准Span的形式串联起来,便于定位是哪一个环节导致了异常行为或成本飙升。OpShield采用这一标准,使得团队无需绑定特定监控平台,也降低了在自托管环境中接驳现有可观测性体系的成本。
相关推荐

JobRunner MCP服务器:AI智能体可修复失败的Java任务
JobRunner 推出开源 MCP 服务器,让 AI 智能体直接查看集群状态、诊断失败原因并恢复 Java 任务,运维人员可在云编码环境或已有智能体中完成故障响应。

MLAI Digital推出9大安全智能体:MCP服务器守护Agentic AI全生命周期
MLAI Digital推出Security MCP Server,内置九个专业安全智能体,覆盖漏洞发现、攻击模拟、Prompt注入检测、API与基础设施评估及修复加速,将安全验证嵌入Agentic AI开发到生产的完整生命周期。

H100 GPU运行Isaac Lab:更优方案探讨
探讨在NVIDIA H100 GPU上运行Isaac Lab的优化方法,包括MIG配置、混合精度、TensorRT加速及社区经验,帮助提升机器人仿真与强化学习效率。