Opus 5.0诡异故障悬而未决:Reddit用户追问真相

特定提示词触发Opus 5.0诡异输出,社区追问却无官方解释,折射模型行为不确定性与透明度缺口。
文章回顾了AI社区中一段关于Opus 5.0的异常现象:用户输入特定提示词"see the below---"后,模型会生成令人不安且夹杂其他语言的内容。Reddit上有用户发帖追问数月前这一现象是否有解释,但未获官方技术说明或修复公告,讨论也相对零散。文章指出,这类提示词触发的异常输出并非孤例,社区常见猜测包括训练数据特殊模式被激活、多语言混合训练导致输出漂移、模型对指令过度解读等,但均无开发方证实。作者强调,此类案例揭示了模型行为边界的不确定性,也暴露了产品透明度缺口——用户不仅想知道发生了什么,更想知道是否有人在处理。目前能确认的仅有触发词、异常特征和讨论有限等事实。
一次未被解释的"诡异"输出
几个月前,AI社区中流传着一段关于Opus 5.0的奇怪现象:当用户输入特定提示词——据称是"see the below---"——模型会生成令人不安的内容,且常常夹杂其他语言。Reddit上有用户发帖追问:"Was there ever an explanation for that creepy Opus 5.0 glitch a few months ago?"(几个月前那个诡异的Opus 5.0故障,到底有没有解释?)
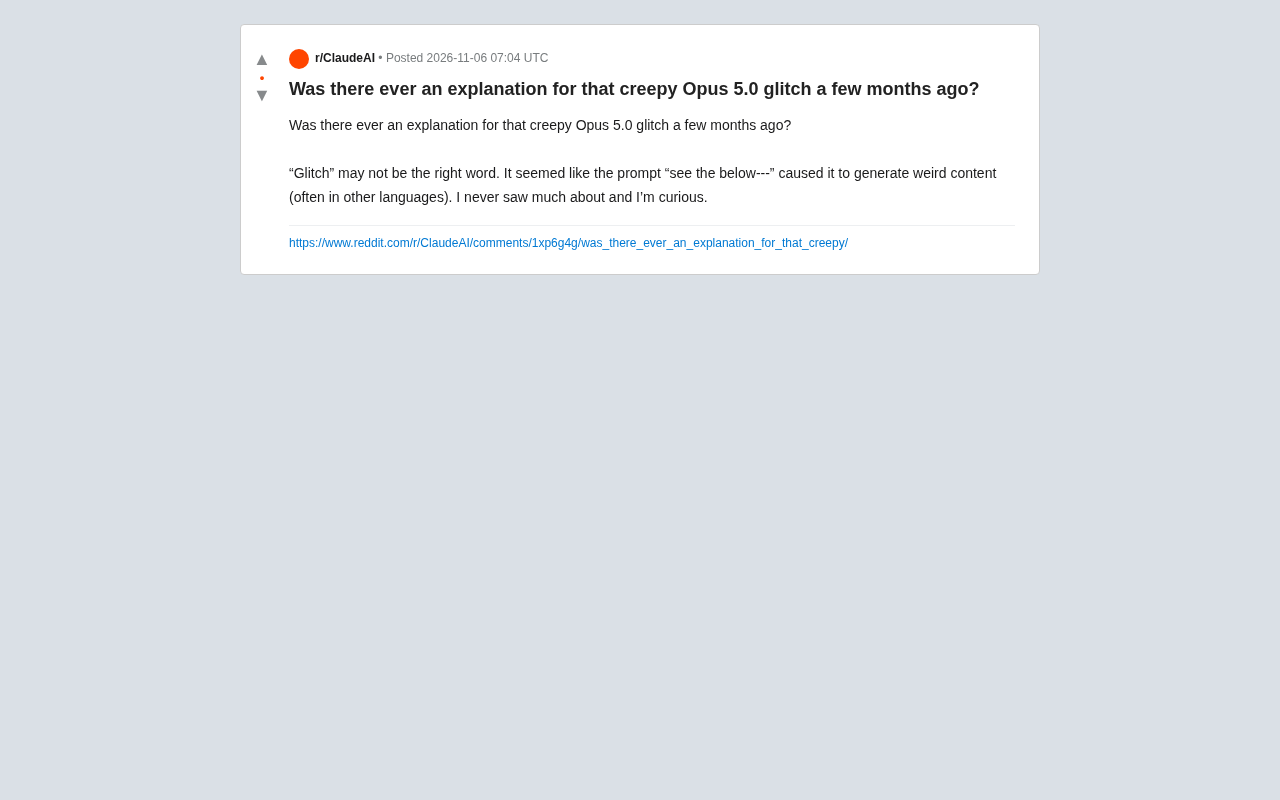
发帖者自己也承认,"glitch"(故障)这个词可能并不准确。它更像是一种可被特定提示触发的异常行为模式,而非随机错误。帖子发出后,并未附带官方的技术说明或修复公告,讨论也相对零散。
Opus 5.0 是 Anthropic 公司 Claude 系列大语言模型的一个版本代号。在大模型社区中,"Opus"通常对应 Claude 家族中能力最强、参数规模最大的层级,与更轻量的 Sonnet、Haiku 层级并列。社区讨论中,用户习惯用版本号加代号的方式指代特定模型快照,便于对比不同时期的行为差异。需要注意的是,模型版本命名和实际发布节奏由开发方掌握,社区口口相传的"Opus 5.0"未必对应官方正式名称,部分讨论可能混合了不同快照或传闻。理解这一点,有助于判断此类"故障"传闻的可信度与传播路径。
**提示词触发(prompt-triggered behavior)**指的是一类并非随机出现、而是由特定输入稳定诱发的模型异常输出。它与传统意义上因硬件或软件缺陷导致的"故障"不同:模型本身运行正常,但在特定上下文下会进入非预期的行为模式。这类现象在研究中常被称为"对抗性提示"或"越狱提示"的近亲,区别在于前者未必带有恶意意图,可能只是无意间命中了训练数据或对齐过程中的敏感区域。
社区讨论的空白与猜测
从目前可获取的信息来看,关于这一现象的公开解释几乎不存在。原帖作者表示"I never saw much about it"(我没看到太多相关讨论),这指向一个现实:即便在AI社区高度活跃的Reddit上,此类异常也未必能获得持续关注或官方回应。
这类"提示词触发的异常输出"在大型语言模型的使用中并非孤例。社区通常会出现几种猜测:训练数据中的特殊模式被意外激活、多语言混合训练导致的输出漂移、或是模型在特定上下文下对指令的过度解读。但截至目前,没有任何来自开发方的公开说明能证实这些猜测。
多语言混合训练导致的输出漂移是社区猜测中较常见的一种机制。现代大语言模型通常在多语言语料上联合训练,不同语言的 token 共享同一套词表和参数空间。当输入触发某个在多语种数据中反复出现的模式时,模型可能"滑入"另一种语言的分布,表现为输出中夹杂外语词句。这种现象在低资源语言或代码、符号混杂的语境中更容易出现,也被称为语言混淆或代码切换(code-switching)行为。
**对齐(alignment)与越狱(jailbreak)**是理解此类异常的另一背景。对齐指通过人类反馈强化学习等手段,让模型行为符合开发者设定的安全与有用性目标;越狱则指用户通过精心构造的提示绕过这些约束。"see the below---"这类看似无害的字符串,可能恰好落在对齐覆盖较薄的区域,使模型对指令的解读偏离预期。需要强调,这些均为机制层面的推测,缺乏开发方披露的日志或复现细节,不能作为定论。
为什么这类"故障"值得关注
对普通用户而言,一次异常输出可能只是谈资;但对AI开发者和研究者来说,它揭示了模型行为边界的不确定性。一个看似无害的提示词就能将输出导向非预期方向,说明模型内部对指令的理解和响应机制仍存在难以完全预测的路径。
更关键的是信息透明度问题。当用户遇到异常行为并在社区提出疑问时,缺乏官方回应会让猜测蔓延。Reddit原帖的追问本身,就是对这种透明度缺口的直接反映——用户不仅想知道"发生了什么",更想知道"有没有人在处理"。
目前能确认的事实
综合现有信息,可以确认的只有几点:特定提示词"see the below---"曾触发Opus 5.0产生异常内容;异常输出常涉及其他语言;社区讨论有限,未见公开的技术解释或修复声明。至于具体原因、影响范围、是否已被修复,均无可靠信息。
对于关注模型行为稳定性的用户,这类案例的价值在于提醒:在使用任何大模型时,对异常输出保持警惕、记录触发条件、并向开发方反馈,仍是必要的使用习惯。而社区层面的追问,也在持续推动AI产品的透明度建设。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。