Opus 5.5 让我准时下班,求别再卷了

Reddit 热帖折射开发者对 AI 迭代既依赖又恐惧的矛盾心态。
文章围绕 Reddit 上一则题为「I’m happy with Opus 5.5. Stop everything, we don’t need more」的热帖展开,剖析开发者对 AI 模型持续迭代的复杂心态。作者指出,帖主对「好模型」的评判标准已从跑分转向「保住饭碗的同时少干活」,Opus 5.5 恰好处于「够强但不至于取代岗位」的微妙平衡点。文章进一步分析,benchmark 驱动的发布节奏可能导致现有体验被削弱(nerfed),反映厂商竞争逻辑与用户稳定诉求之间的张力。帖中关于 prompt caching 延长至 4 小时的具体请求,以及对 Google「暂停不适用于你们」的调侃,则折射出用户对不同厂商的预期分化。最终落点是:真正值得关注的不是版本号,而是提效释放的时间流向何处。
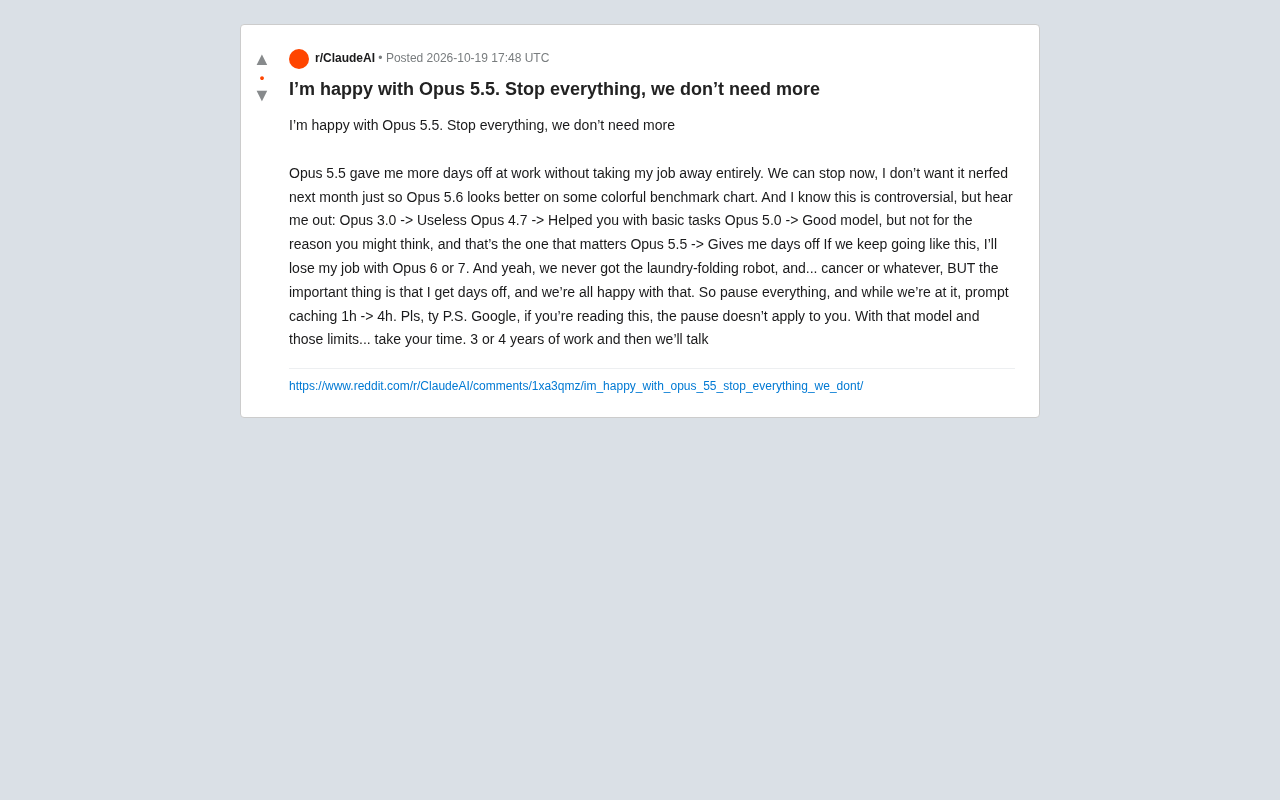
Reddit 上一位用户的帖子火了,标题就叫「I’m happy with Opus 5.5. Stop everything, we don’t need more」。乍看像一句玩笑,细读下来,却把当下不少开发者对 AI 模型迭代的真实心态讲透了——不是不想要更强的模型,而是怕再强下去,自己的工作就没了。
一条帖子背后的集体焦虑
这位用户的逻辑很直白:Opus 5.5 让他在工作上多了几天假,但岗位还在。于是他说,可以停了,别再升级了,他不想下个月出个 Opus 5.6 就为了在某个「花里胡哨的 benchmark 图表」上好看一点,把现在的体验给砍了。
他给出一条挺戏谑的版本演进线:Opus 3.0 用处不大;Opus 4.7 能帮着做点基础任务;Opus 5.0 是个好模型,但好的原因可能跟你想的不一样;到了 Opus 5.5,直接给他放假的自由。然后他补了一句:照这个速度下去,Opus 6 或者 7 出来,工作就真没了。
这段话很快在评论区引起共鸣,原因不难理解。模型能力每往上走一步,落到具体岗位上,往往就是某些任务被整块拿走。原本一个人要干三天的活,现在半天收工,表面上是效率提升,实际是老板开始盘算:这个岗位还需要那么多人吗?
「给假不给岗」才是理想状态
帖子里最有意思的一点,是作者对「好模型」的定义发生了变化。
他不再拿跑分、推理深度、代码通过率这些指标来衡量模型,而是用了一个非常个人化的标准:这个模型有没有在保住我饭碗的前提下,让我少干点活。
这其实代表了一部分一线使用者的真实诉求。大家不是抗拒技术进步,而是希望技术进步的收益能落到自己身上——多出来的时间归自己,而不是变成裁员的理由。Opus 5.5 恰好卡在这个微妙的平衡点上:够强,能分担任务;又没强到让公司觉得这个岗位可以整个撤掉。
所以他说「we can stop now」,与其说是技术保守主义,不如说是一种自保式的满足感。
为什么大家怕的是「下一个版本」
帖子中反复提到 benchmark,这不是随口一说。当前模型厂商的发布节奏,很大程度上被榜单驱动——新版本要在各种评测上比上一代高出一截,才有故事可讲。而为了在跑分上做出差异,模型的行为、输出风格、甚至某些能力边界都可能被调整。
对普通用户来说,这意味着两件事。一是原本用得顺手的模型,可能因为一次升级变得「不听话」或者「过度保守」;二是能力提升的方向未必是自己需要的方向。作者担心的「nerfed」(被削弱),指的正是这种为了发布新版本而牺牲现有体验的操作。
站在厂商角度,不停迭代是竞争必需;站在用户角度,稳定、可预期有时比跑分更重要。这两种诉求之间的张力,在这条帖子里被用一种半开玩笑的方式摆到了台面上。
Benchmark 是机器学习领域常用的标准化评测集与指标,如 MMLU(多学科知识)、HumanEval(代码生成)、GSM8K(数学推理)等。厂商通常会选取一组公开榜单作为模型能力的展示窗口,并在发布时对比上一代模型的分数提升。问题在于,榜单分数与真实使用体验并不总是一致:模型可能为了在特定题型上拿高分而调整输出分布,导致在开放式任务中变得啰嗦、回避或过度格式化。此外,榜单本身也可能被针对性优化,即所谓「刷榜」,使分数提升无法等价于实际能力提升。这正是帖子中「花里胡哨的 benchmark 图表」所指的隐患。
顺带一提的 prompt caching 和 Google
帖子后半段画风一转,作者提了个具体需求:prompt caching 从 1 小时延长到 4 小时。这个请求倒是一点不玩笑——对长时间会话、复杂 agent 工作流来说,缓存窗口越长,成本和延迟表现就越好,是实打实的工程痛点。
最后他还专门点名 Google:如果你们在看这个帖子,「暂停」不适用于你们。按他的说法,以 Google 当前模型和额度限制的水平,再埋头干个三四年,到时候再聊。这句话带着调侃,但也侧面反映出用户对不同厂商的预期差异——对领先者喊停,对追赶者催更。
Prompt caching 是指将对话中重复出现的前缀内容(如系统提示、长文档、工具定义)缓存在服务端,后续请求命中缓存时无需重新计算这部分 token,从而降低延迟与费用。主流厂商通常设定一个缓存有效期(TTL),如 Anthropic 的 5 分钟或 1 小时,超时后缓存失效、需重新写入。对于多轮长会话、复杂 agent 循环或反复调用同一份背景资料的场景,缓存窗口越长,单位请求的成本和首 token 延迟就越低。将窗口从 1 小时延长到 4 小时,意味着更少的缓存重建次数和更稳定的长任务表现,是贴近实际工程需求的改进方向。
这条帖子真正在说什么
把它当成段子看,很容易一笑而过。但它触及了一个正在发生的现实:当 AI 能力增长的速度超过岗位结构调整的速度,一线使用者的心态会变得矛盾——既依赖工具提效,又恐惧提效的后果。
模型还会继续迭代,Opus 5.6 大概率也会来。真正值得关注的,不是版本号本身,而是提效释放出来的时间,最终流向了哪里。是变成更多休息,还是变成更少岗位,这个问题,模型厂商回答不了。
相关推荐

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。

联邦政府拨款8500万美元,CFS研发聚变专用半导体
联邦政府向Commonwealth Fusion Systems拨款8500万美元,用于研发聚变电站所需的导体与功率半导体。本文解读这笔资助对聚变产业链与商业化路径的意义。