Opus 5.5、Sonnet 5.5、Haiku 5.5全对比:价格与能力一次看懂

Anthropic三款新模型定价与能力拆解:Haiku省钱、Sonnet性价比、Opus攻难题
Anthropic同期发布Haiku 5.5、Sonnet 5.5和Opus 5.5三款模型,定价差距悬殊——Haiku 5.5比Sonnet 5.5便宜约20倍,比上一代平均降价75%。Sonnet 5.5单价与前代持平并将缓存读取价减半,终端编程测试得分70.6%,反超Opus 5.5的66.4%;Opus 5.5则在八项测试中领先七项,主要优势在于开放判断类复杂任务。官方选型建议简明:拿不准用Opus,追求速度与成本均衡用Sonnet,批量简单任务交给Haiku。决策关键在于先估算单次任务成本,再判断模型能否完成目标——做不成的任务,再便宜也是浪费。
Anthropic接连推出三款新模型,一道官方演示题把它们的差异摊开了:给鸡蛋做护具从32米高扔下不许碎,左右两队同时开工。右边用Haiku 5.5多带了10个子智能体,58秒就到顶,试了86个设计,只花0.14美元;左边用Opus 5.5单跑,耗时3分37秒,试了25个设计,花了0.47美元。同一目标,右边快了近四倍、便宜了七成。
不过这只是官方挑的一道题,别当成通用结论。真正能帮你做决策的,是把三款模型的定价与能力分别拆开看。
价格:从每百万Token算起
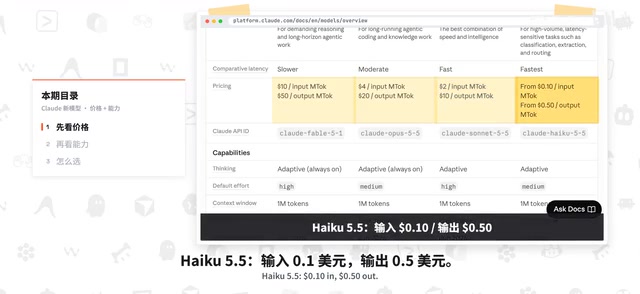
Anthropic的四款模型按每百万Token计费(官方标价,未算折扣):
- Opus 5.1:输入10美元 / 输出50美元
- Opus 5.5:输入4美元 / 输出20美元
- Sonnet 5.5:输入2美元 / 输出10美元
- Haiku 5.5:输入0.1美元 / 输出0.5美元
按照同样跑100万输入、20万输出Token来算一笔账:Haiku 5.5约0.2美元,Sonnet 5.5约4美元,Opus 5.5约8美元,Opus 5.1则要20美元。Haiku 5.5比Sonnet 5.5整整便宜20倍,这是档位之间最直观的差距。
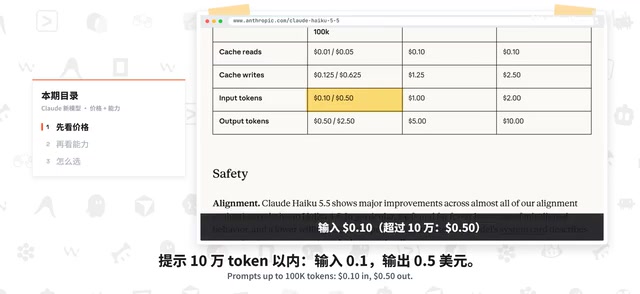
Haiku 5.5的定价还按提示长度分两档:提示在10万Token以内,输入0.1、输出0.5美元;超过10万,输入0.5、输出2.5美元。对比上一代Haiku 4.5(输入1美元、输出5美元),短提示降了九成,长提示降了五成。官方给出的"平均便宜约75%",已经把新分词器会多消耗的Token算进去了——不过只给了结论,没放完整算式。
Sonnet 5.5没涨价,还降了缓存
Sonnet 5.5的单价和Sonnet 5.0完全一致,没有上涨。原本Sonnet 5.0计划涨价,后来被官方取消。官方的说法是,同样的活它用的Token更少、速度也更快(输出比Sonnet 5.0快30%以上),所以"做同一件事最多便宜30%",但这是省在用量而非单价。
随后Anthropic又补了一刀:Sonnet 5.5的缓存读取价格减半,每百万Token从0.2美元降到0.1美元。官方估算多数智能体任务因此能再省约20%。
订阅用户还另有每月API额度:Max 5倍档和2倍档各100美元、20倍档200美元、Team最多500美元且全团队共用,可用在任何一款模型上。具体到账时间官方没说明。
Token是大语言模型处理文本的基本计量单位,粗略来说,英文约每4个字符对应1个Token,中文因字符密度更高,通常每个汉字对应1至2个Token。文章提到的"新分词器会多消耗Token"正是指此:不同版本的模型使用不同的分词算法,即使输入相同的文字,新分词器切出的Token数量可能更多,导致账单上的消耗量上升。因此官方在比较Haiku 5.5与上一代的价格降幅时,特别注明已将分词器差异折算进去,最终给出"平均降价约75%"的结论,而不是简单地用单价相除。在实际使用中,尤其是处理大量中文或代码时,Token消耗与字数之间的换算关系可能与英文场景差异显著,直接影响成本估算的准确性。
提示缓存(Prompt Caching)是一种将重复出现的上下文内容存储起来、后续请求直接复用而无需重新处理的机制。在智能体任务中,系统提示、工具定义或长篇背景文档往往在多轮对话里保持不变,若每次调用都重新传入并计费,成本会快速叠加。缓存读取价格减半意味着这部分重复内容的调用成本直接对折。官方估算多数智能体任务因此能再省约20%,这个数字的前提是任务本身有大量可复用的上下文——纯粹的单轮问答几乎感受不到差别,而需要维持长系统提示或工具列表的多步骤自动化流程则受益最明显。
能力:Opus主攻复杂,Sonnet是性价比担当
Sonnet 5.5这次的编程表现跃升明显。终端编程测试Terminal-Bench达到70.6%,Sonnet 5.0只有10.3%;而Opus 5.5在最高的X-High档也只有66.4%,被Sonnet 5.5反超。
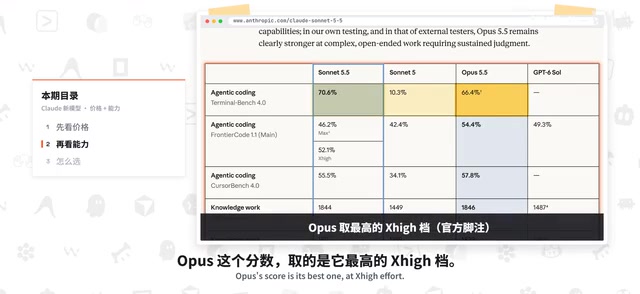
再看其他几项:
- 知识工作测试GDPval:Opus 5.5得1874,Sonnet 5.5得1846,只差2分
- 电脑操作OSWorld 2.1:Sonnet 80.1% vs Opus 81.8%
- 看图表Chartography:Sonnet 5.5达61.6%,Sonnet 5.0只有15.6%
Sonnet 5.5还是第一个仅凭截图就通关《宝可梦红》的模型。八项成绩里Opus 5.5领先七项,但差距多在两三分之间。官方自己也承认:需要持续判断的开放任务,Opus 5.5更强;而大量编码类工作,Sonnet 5.5已经足够甚至更优。所有成绩均为Anthropic自行公布。
Haiku 5.5:便宜不等于全能
Haiku 5.5的官方定位是"大批量、省钱的活":摘要、压缩、查数据库、分类这类重复任务。它也适合给Opus或Sonnet当编码子智能体,因为够快;实时客服和浏览器操作同样合适。
它的进步幅度相当大:知识工作GDPval从上一代的735提升到1620;电脑操作OSWorld离线子机从15.7%升到72.4%;终端编程Terminal-Bench从0升到39.2%。
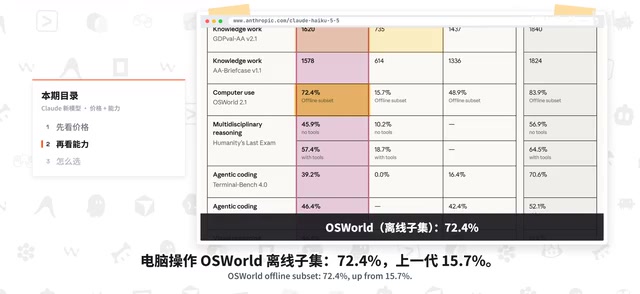
但要注意边界:Haiku 5.5的终端编程比Sonnet 5.5低了31个点(39.2% vs 70.6%)。官方明确说,复杂的编码智能体任务要选Sonnet或Opus。Haiku 5.5是第一个能调节思考力度的Haiku,官方按思考力度画了成绩-成本图,三张图里得分最高的那一端始终是Sonnet 5.5。开头的鸡蛋护具演示,正是Haiku 5.5作为子智能体的样子,它已经能在Claude Code里直接使用。
文中提到的Terminal-Bench、OSWorld和GDPval均为第三方或Anthropic自行设计的能力评测基准。Terminal-Bench测量模型在命令行环境下完成编程任务的能力,包括调试、脚本编写等;OSWorld评估模型通过截图和操作指令控制真实桌面操作系统的水平;GDPval则侧重知识工作场景,涵盖分析、写作、研究等任务。需要注意的是,这些成绩均由Anthropic自行公布,尚未经过独立第三方复现验证。基准测试的设计本身也存在局限——模型在特定测试集上的表现未必能完全反映真实业务场景中的表现,选型时最可靠的参考仍是用自己的实际任务数据进行小规模测试对比。
怎么选:先算钱,再问做不做得成
官方文档给的建议很直接:
- 拿不准时,先用Opus 5.5
- 要更快、更少,用Sonnet 5.5,官方称它是"速度和智能的最佳组合"
- 大批量、简单、要快的活,交给Haiku 5.5
四款模型上下文都是100万Token。Haiku超过10万要按高档价计费,所以别只盯着"便宜20倍"这个数字。更务实的做法是:先估算一次任务要花多少钱,再判断这款模型做不做得成——做不成的活,再便宜也是贵的。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。