Opus 5.5 vs Sonnet 5.5:同价不同命,实测差距明显

实测显示 Sonnet 5.5 实际成本几乎追平 Opus 5.5,质量却明显落后。
Anthropic 推出 Opus 5.5 和 Sonnet 5.5 后,官方基准测试显示两者在智能体编程任务上得分接近,Sonnet 5.5 标称价格仅为 Opus 5.5 的一半。一位 YouTube 博主用同一条 prompt 让 Fable 5.1、Opus 5.5 和 Sonnet 5.5 在 extra high 推理等级下构建一个 3D 迷你高尔夫游戏。结果显示,Sonnet 5.5 用时 1 小时 20 分钟、花费约 26 美元,Opus 5.5 用时 1 小时 26 分钟、花费约 27 美元,两者几乎持平。但质量上 Sonnet 5.5 动画生硬、风车穿模、球道堵塞、球可被打出地图,而 Opus 5.5 接近 Fable 5.1 的水准。结论是:基准分数和标称价格不能代表真实性价比,实际 token 消耗、运行时长与输出质量才是关键。
价格趋同,性能是否也趋同?
Anthropic 同时推出 Opus 5.5 和 Sonnet 5.5 后,官方基准测试显示两者在智能体编程任务上的得分非常接近。Sonnet 5.5 的定价约为 Opus 5.5 的一半,是 Fable 的五分之一。从纸面数据看,Sonnet 5.5 似乎是性价比之王。
但基准测试终究只是参考。一位 YouTube 科技博主用完全相同的一条 prompt 对 Fable 5.1、Opus 5.5 和 Sonnet 5.5 进行了实战对比,三者均在 extra high 推理等级下运行,结果揭示了一个值得关注的现实:Sonnet 5.5 实际花费与 Opus 5.5 几乎持平,但输出质量存在明显差距。
测试方法:一条 prompt 定胜负
测试任务是一条开放式 prompt:构建一个完整、精致的浏览器 3D 冒险迷你高尔夫游戏。要求包含九条球道,其中至少两条分别有带动画的风车和恐龙障碍,其余七条由模型自行设计。此外还要求加入道具、环境动画(瀑布、摇曳的植物、小动物、闪烁的火把、旋转齿轮等),视觉风格为卡通渲染,并添加音效。
博主特别指出,Anthropic 官方不建议在 Sonnet 5.5 上使用 max 模式,因为模型容易运行过久、做超出需求的工作,甚至出现自我矛盾。因此三者统一使用 extra high 推理等级。
延伸说明:什么是 extra high 推理等级?
在 Claude 等支持推理功能的模型上,Anthropic 通常会提供多档推理强度(reasoning effort)设置,例如 low、medium、high、extra high、max。推理等级决定模型在给出最终答案之前,可以投入多少“内部思考”的 token 预算:等级越高,模型越倾向于拆解问题、验证方案、反复推敲代码结构;但同时也意味着更长的响应时间、更高的 token 消耗和更高的实际费用。
值得注意的是,“extra high”并不是最高档,上面还有 max。文章提到 Anthropic 官方不建议在 Sonnet 5.5 上使用 max,原因是该模型在最高推理档下容易过度规划、反复自我修正,甚至为了满足一个模糊需求而做出与整体目标矛盾的设计。因此博主统一使用 extra high,既保留足够的推理深度,又避免因模型“想太多”而导致运行时间和成本失控。这也解释了为什么文中所有的花费对比,都是在同一推理等级下进行的——只有控制住这个变量,“Sonnet 更便宜”的标称优势才具有可比性。
速度与成本对比
三者几乎同时启动,Sonnet 5.5 最先在浏览器中显示出运行画面。但最终完成时间非常接近:
- Fable 5.1:约 1 小时 40 分钟,花费约 51 美元
- Opus 5.5:约 1 小时 26 分钟,花费约 27 美元
- Sonnet 5.5:约 1 小时 20 分钟,花费约 26 美元
Sonnet 5.5 仅比 Opus 5.5 快 6 分钟、便宜 1 美元。博主原本预期 Sonnet 会便宜得多、快得多,实际结果出乎意料。
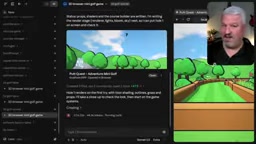
游戏质量实测
Fable 5.1:完成度最高
Fable 出品的游戏菜单精致,卡通渲染风格到位,音效丰富。球体物理表现出色,风车有碰撞检测,恐龙会主动将球击入水中。场景细节扎实——草地随风摆动、蝴蝶和兔子穿梭其间。九条球道的视觉多样性令人印象深刻。
Opus 5.5:接近 Fable 的水准
Opus 5.5 用不到 Fable 一半的成本,交出了几乎同等质量的游戏。菜单、音效、卡通渲染风格全部到位,球体物理准确。风车和恐龙障碍均正常工作,恐龙的尾巴具有物理碰撞。唯一的小瑕疵是推杆会跟随球移动,博主认为一条追加 prompt 即可修复。
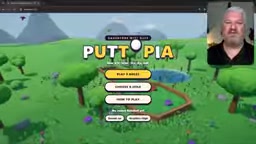
Sonnet 5.5:动画生硬,bug 较多
Sonnet 5.5 是唯一添加了背景音乐的模型(而非仅音效),但游戏质量明显落后。动画显得生硬("wonky"),推杆跟随球的 bug 同样存在。风车存在穿模问题,球需要很大力度才能移动。博主对恐龙模型的评价是"见过的最蠢萌的恐龙",球道入口甚至被堵住,球可以被打出地图边界。
延伸说明:什么是“卡通渲染”与“物理碰撞检测”?
卡通渲染(cel shading / toon shading)是一种非写实渲染风格,通过限制色阶、强化描边、压平光照,让 3D 画面呈现出类似手绘动画的质感。它常见于《塞尔达传说:风之杖》《原神》等作品。在浏览器 3D 游戏里,卡通渲染不仅考验模型对材质和光照参数的理解,还考验它能否统一风格——如果某些物体用了写实光照、另一些用了卡通描边,画面就会割裂。文中评价 Fable 5.1 和 Opus 5.5“卡通渲染风格到位”,指的就是这种整体视觉一致性。
物理碰撞检测则是游戏可玩性的基础:球、风车叶片、恐龙、球道边界之间必须有准确的相交判断,球才能被风车推动、被恐龙击入水中、或在碰到边界时反弹而不是穿出去。Sonnet 5.5 出现的“风车穿模”“球道入口被堵住”“球可以被打出地图边界”,本质上都是碰撞体设置错误或边界检测缺失导致的。对智能体编程而言,这类 bug 往往不会让程序崩溃,却会严重破坏体验,也是区分模型工程完成度的重要信号。
核心发现:同价不同命
这次实测揭示了一个关键问题:当 Sonnet 5.5 和 Opus 5.5 的实际成本几乎相同时,选择 Sonnet 就失去了性价比优势。 而 Opus 5.5 在游戏质量上明显领先,尤其在动画流畅度、碰撞检测准确性和整体完成度方面。
博主最终结论:"同样的价格和同样的时间,我更愿意直接用 Opus。Sonnet 需要大量额外工作才能达到 Opus 的水平,而 Opus 只需要一两条追加 prompt 就能达到 Fable 的水准。"
不过博主也提到,Sonnet 5.5 在指令非常精确的场景下表现优秀,开方式 prompt 对其而言确实更具挑战性。这意味着 Sonnet 5.5 并非没有用武之地——如果你的工作流是指令明确的编程任务,它依然是一个可靠的选择。但如果你期望用一半的价格获得接近 Opus 的体验,现实可能不会如你所愿。
结论提示:模型选择不应只看基准分数和标称价格,实际 token 消耗、运行时长和输出质量才是决定性价比的关键因素。在智能体编程场景中,"便宜"的模型如果消耗更多 token 或需要更多轮次修正,最终成本可能与旗舰模型相差无几。
延伸说明:为什么标称价格与实际成本会背离?
API 的“每百万 token 价格”只是单价,不等于一次任务的总价。总成本 = 输入 token 数 × 输入单价 + 输出 token 数 × 输出单价,而智能体编程任务中,模型会反复读取代码文件、运行测试、查看报错、再修改代码,每一轮都产生新的输入输出。一个标称便宜一半的模型,如果因为推理效率低、代码返工多、需要更多轮次才能收敛,就可能消耗数倍于旗舰模型的 token,最终账单几乎追平甚至反超。
文中 Sonnet 5.5 花费 26 美元、Opus 5.5 花费 27 美元,就是这一机制的典型体现:Sonnet 的单价优势被更高的 token 消耗和更多的修正轮次吃掉了。与此同时,运行时长也是隐形成本——如果 Sonnet 需要大量额外 prompt 才能达到可用质量,人工介入的时间和精力同样要计入。因此评估模型性价比时,更可靠的做法是拿自己的真实任务跑一遍,看端到端的总花费、总耗时和最终质量,而不是只看官方价目表和基准分数。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。