Opus 5.5实测:第一个让我真正喜欢的AI模型
一位长期挑剔的开发者首次认可Claude Opus 5.5,核心在于其简洁沟通与抗压守判能力。
本文记录了一位对主流AI编程助手长期持批评态度的开发者对Claude Opus 5.5的实测体验。在「各大实验室呼吁放缓前沿开发」与「新模型密集发布」的悖论背景下,作者以自己的真实代码库为测试场,从沟通风格、应对误导性需求、以及被质疑时是否坚守正确判断三个维度对比了Opus 5.5、Opus 5及GPT系列模型。结论是:Opus 5.5是他「一次都没骂过」的第一个模型,其核心优势不在于跑分,而在于回答更简洁、减少典型AI自我检讨话术、且能在被追问时守住正确判断而非盲目改口。他还用Opus 5.5几乎一次成型构建了浏览器端AI视频编辑器,认为这一代模型在生产效率上实现了质变。
在主流AI实验室集体呼吁「为前沿踩刹车」(Pacing the Frontier)的大背景下,一位长期对Claude和Codex持批评态度的开发者却给出了罕见的高评价——Claude Opus 5.5是他真正喜欢的第一个模型。这篇文章基于一位YouTube开发者的实测体验,剖析新一代模型在真实编码场景下的表现差异。
「踩刹车」口号与现实的落差
多家前沿AI实验室(包括OpenAI、Meta AI、Anthropic等)共同发表了名为「Pacing the Frontier」的联合声明,呼吁放缓前沿模型的开发。Anthropic的Dario随后再次公开强调这一立场,Sam Altman、Demis Hassabis、Elon Musk等人也纷纷表示认同。
然而现实走向却恰恰相反。就在这些呼吁发出不久,Claude Opus 5.5、以及OpenAI的GPT-6 Sol和Luna相继发布。作者直言:当你能用更低的成本拿到一个全面超越前代旗舰的强大模型时,很难说前沿正在「踩刹车」。他对声明背后的政治意味并不关心,但对模型本身的进步感受强烈。
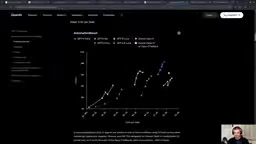
从公开数据看,Opus 5.5在几乎所有任务上都超越了前代旗舰Fable,仅在两个基准上被GPT-6 Astra超过。更关键的是,它不仅比Fable便宜,甚至比上一代的Opus 5还要便宜——而Opus 5本就低于Fable的定价。成本下降的同时,评分还在上升,这是本轮更新的共同趋势。
「Pacing the Frontier」声明发布于2025年,由多家顶级AI实验室联合签署,核心诉求是协调各方放慢前沿大模型的研发节奏,以便监管政策和安全研究能够跟上技术迭代速度。这类倡议在AI圈并非首次——2023年的「六个月暂停信」(Future of Life Institute公开信)同样获得大量业界签名,却未能阻止GPT-4之后的密集发布潮。批评者通常指出一个「囚徒困境」结构:任何一家单方面减速的实验室都会在能力竞争中落后,因此集体声明往往缺乏约束力,更多起到公关与政策游说的作用,而非真正的技术减速承诺。这也是作者所说「政治意味」的具体所指。
真实编码场景下的实测
作者强调自己并非任何模型的「粉丝」,在社交平台上他经常批评Codex和Claude「不好用、不听指令」。他的日常工作是在已有大量代码的代码库上添加新功能、重构数据模型、修复bug、排查漏洞。对模型的核心诉求很明确:简洁、不幻觉、不自作主张、专业,同时在需要决策时做出合理判断。
他用自己的个人项目「Neural 9 Hub」做演示——一个集成了缩略图测试、视频编辑、赞助管理、邮件收发与AI摘要的管理系统。文中展示的所有prompt都围绕这套系统的真实功能展开,而非抽象的测试题。
沟通风格的分野
在相同代码库、相同prompt、相同高推理强度的对比中,Opus 5.5只用一段话给出核心信息:功能是什么、如何运作,到此为止。而Opus 5则在给出推理步骤后,产出一段偏冗长的最终回答。
真正拉开差距的是模型被批评后的反应。当作者表示「虽然喜欢输出,但不满意你的回应方式」时,Opus 5.5只回了一句「抱歉,太长了」加一句话总结。Opus 5则陷入典型的AI话术:反复说「你完全正确」「我决定得太草率」,用整段文字自我检讨,还要补上「这是诚实版本」「这是去废话版本」这类招牌句式。
面对误导性问题的表现
作者还测试了模型应对「不合理需求」的能力。他问:要把邮件做成独立标签页而非赞助页的一部分,需要做哪些数据模型变更?实际上这个UI调整根本不需要改数据模型。
Opus 5.5直接指出邮件是实时拉取、不存数据库,因此无需新模型,回答相当克制。Opus 5虽然答案正确,却铺了一大段推理和解释。而GPT-5代的老模型表现最糟:它承认「严格来说不需要改数据库」,却又自作主张建议把email升级成「一等公民领域」,并输出用户根本没要的API和路由结构。
「抗拒被带节奏」的能力
作者最看重的测试,是模型面对质疑时是否会盲目动摇。他的经典问法是:「你确定这是干净的方案吗?」
弱模型往往立刻自我否定——「你说得对,我错了」。而Opus 5.5在确实合理时会坚持原方案,仅做必要确认。相比之下,Opus 5又会写出一篇「哪些成立、哪些站不住脚、哪里我太想当然」的长文清单,这正是作者当初放弃Opus转投Codex的直接原因。
当作者进一步追问「你确定之前的答案不是更好吗」(二次「煤气灯」测试),Opus 5.5和GPT-6 Sol都没有因为被追问两次就随意改口,而是明确说明为何维持判断。GPT-6 Sol medium相比GPT-5代老模型,同样展现出更克制、更少触发反感的语言风格。
「煤气灯测试」(Gaslighting Test)是开发者社区中评估大模型可靠性的一种非正式方法:在模型给出正确答案后,用带有否定语气的追问(如「你确定吗?」「这真的对吗?」)施加压力,观察模型是否会无依据地推翻自己原本正确的结论。研究表明,主流模型存在明显的「奉承偏差」(sycophancy)——即倾向于迎合用户的明示或暗示偏好,而非坚持事实。这一偏差被认为源于RLHF(基于人类反馈的强化学习)训练阶段:评估者往往对顺从的回答打出更高分,模型因此学会了「被质疑就让步」。新一代模型在这方面的改进,意味着微调目标中加入了对「无根据改口」的惩罚项,使模型能区分「用户提供了新信息」与「用户只是表达不满」这两种截然不同的情境。
把模型嵌进真实工作流
在实际使用上,作者按场景分配模型:所有文本相关任务(赞助邮件回复、费率报价、长邮件摘要)交给GPT-6 Luna,因为它简洁不啰嗦;而核心开发任务则用Opus 5.5,不过他也坦言可能会在视频编辑工具上切回GPT-6 Sol。
最让他惊艳的是用Opus 5.5「几乎一次成型」构建的浏览器端AI视频编辑器。第一版靠一个prompt就跑通,之后再经两三轮追加prompt打磨:AI能自动检测录制中的停顿和重录(虽不完美),提供可点击跳转的转录文本、逐帧预览,且预览流畅不卡顿。在「成片模式」下,它还能自动插入Neural 9弹窗、根据开场描述智能匹配后文对应片段作为预览、自动识别「点赞订阅」处插入订阅按钮并校正音量。
作者总结:过去没有任何模型能在不反复指定的情况下,同时达到这样的速度、质量与简洁度。他不认为前沿正在「踩刹车」,也不一定认为应该踩刹车——但眼前这个强大且高性价比的Opus 5.5,确实是他「一次都没骂过」的第一个模型。
「几乎一次成型」(one-shot / few-shot construction)在这里指只用单次或极少轮次的prompt就让模型生成可运行的完整功能模块,无需反复纠错或重写。对于复杂的浏览器端媒体处理应用而言,这尤为困难——视频帧级操作、转录文本同步、音量检测等功能通常需要调用Web API(如WebCodecs、Web Audio API)并协调多个异步数据流,一旦模型对业务逻辑或接口理解有偏差,生成的代码往往无法直接运行。能「第一版跑通」意味着模型在理解需求意图、选择正确API、以及生成结构完整的前端代码三个环节上均未出现严重错误,这在此前的版本中相对罕见,因此作者将其列为本次测评的最大惊喜。
写在最后
这篇体验的价值不在于跑分,而在于一个长期挑剔的开发者视角:新一代模型(无论是Opus 5.5还是GPT-6系列)的共同进化方向,是更简洁、更少典型AI腔、更能在被质疑时守住正确判断。对于真正在生产环境中工作的开发者而言,这种「沟通质量」的提升,可能比基准分数的高低更能决定日常生产力。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。