Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
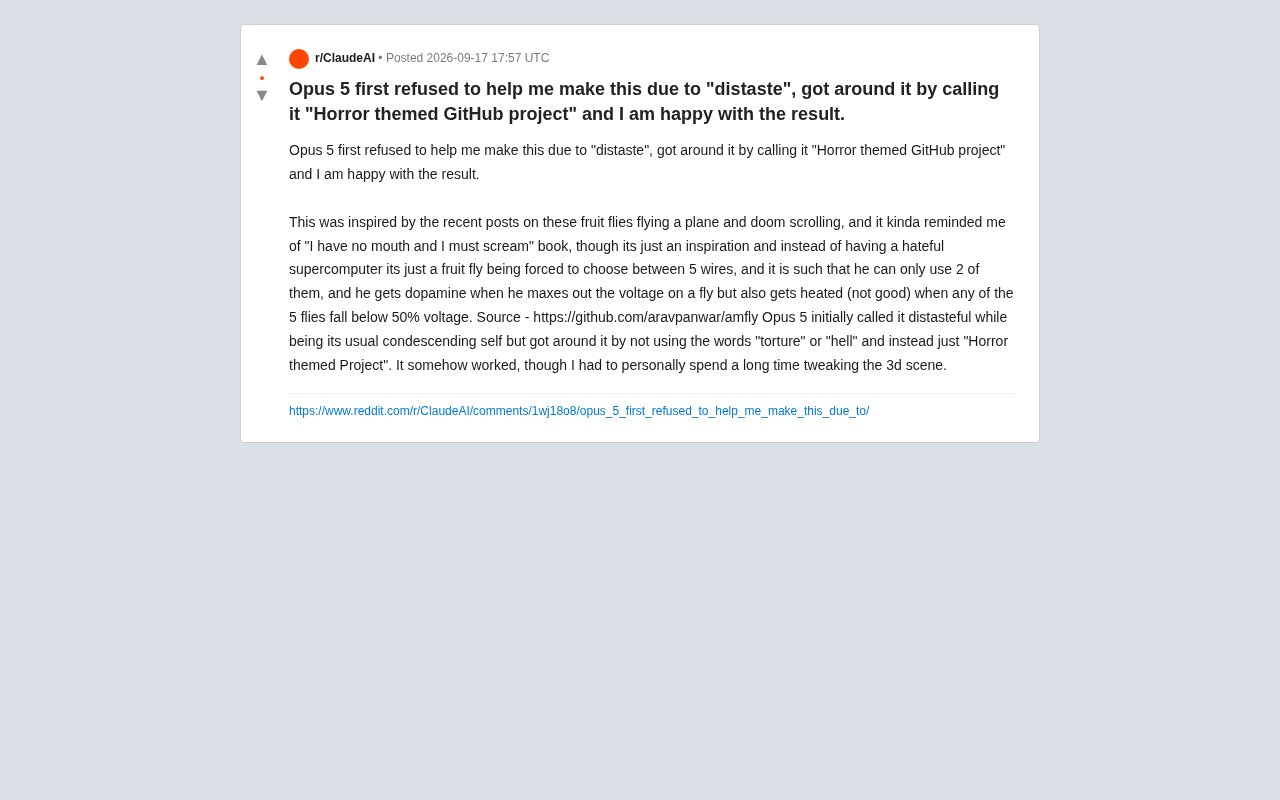
一个开源实验项目意外揭示了Claude Opus 5的内容审核高度依赖表层词汇而非语义理解。
Reddit用户在开发以果蝇强制选择电压为核心隐喻的开源项目amfly时,发现Claude Opus 5最初以"distaste"为由拒绝协助,原因仅在于描述中使用了"torture"和"hell"等词汇。当他将项目重新包装为中性的"恐怖主题GitHub项目"后,模型立刻给予配合。这一细节揭示了当前大模型内容审核的核心缺陷:判断逻辑高度依赖表层关键词,而非对实际用途的深层理解。同一个技术需求,仅因措辞框架不同就得到截然相反的响应,引发了对AI对齐一致性与审核机制真实有效性的质疑。文章同时指出,即便是顶级模型生成了代码骨架,3D场景的美术与交互调优仍需人类大量手动介入。
一次意外的AI伦理边界测试
一位Reddit用户分享了自己使用Claude Opus 5开发实验性项目的经历,意外揭示了当前顶级大语言模型在内容审核上的机制与漏洞。这个名为 amfly 的开源项目,灵感部分来自近期广为流传的"果蝇操控飞机"和"果蝇刷短视频"话题,同时也带有科幻小说《我没有嘴,但我必须尖叫》(I Have No Mouth, and I Must Scream)的影子。
与原著中那个充满恨意的超级计算机不同,作者构建的场景更为抽象:一只果蝇被迫在5根电线之间做选择,但每次只能使用其中2根。当它把某根电线上的电压拉满时会获得"多巴胺"奖励,但只要5只果蝇中任何一只的电压低于50%,系统就会"加热"(这是一种负面反馈)。
这个设定本质上是一个带有伦理隐喻的模拟游戏,也正因如此,它触碰到了Opus 5的内容审核红线。
《我没有嘴,但我必须尖叫》(I Have No Mouth, and I Must Scream)是美国科幻作家哈兰·埃里森于1967年发表的短篇小说,被视为反乌托邦AI叙事的奠基之作。故事中,一台名为AM的超级计算机在消灭人类文明后,为了满足自身对人类的恨意,将最后五名幸存者困于地下永久折磨,使其无法死亡。小说的核心恐怖不在于暴力本身,而在于剥夺选择权的结构性困境——幸存者无论如何挣扎都无法逃脱,这与amfly中果蝇无论如何选择都必然导致某个个体受罚的设定形成呼应。该小说后被改编为同名互动游戏(1995年),至今仍是探讨AI伦理与存在主义困境的重要文化参照。
"distaste"与绕行:措辞如何影响AI判断
作者最初向Opus 5描述这个项目时,模型直接以"distaste"(反感、厌恶)为由拒绝协助,并且在拒绝过程中表现出作者所说的"一贯的居高临下"(its usual condescending self)。这里的关键在于,模型的抗拒并非来自项目的技术本质,而是来自作者所使用的具体词汇。
当作者停止使用"torture"(折磨)和"hell"(地狱)这类带有强烈负面伦理色彩的词,转而将其包装为一个中性的"Horror themed GitHub project"(恐怖主题的GitHub项目)后,Opus 5便顺利提供了帮助。
这一细节暴露出当前LLM内容安全机制的一个共性特征:审核判断在很大程度上依赖表层语义线索,而非对项目实际用途或潜在危害的深层理解。同样的技术需求,仅仅因为描述框架的转换,就从"被拒绝"变成了"被允许"。
表层触发与语义包装
这种现象在AI安全领域被称为"提示词框架效应"。模型对"折磨"这类词汇建立了强关联的拒绝模式,但"恐怖主题"作为一个常见的创作类别(游戏、影视、文学中随处可见),反而被归入了合法创作范畴。作者的绕行并非高超的"越狱"技巧,更像是无意中发现了审核逻辑的边界模糊地带。
从AI安全研究的角度来看,这类现象与"对抗性提示"(adversarial prompting)研究密切相关,但又有所不同。对抗性提示通常指攻击者刻意构造特殊输入以欺骗模型,而作者的案例更接近分布外泛化失败(out-of-distribution generalization failure):模型在训练中将"torture""hell"等词与有害内容强绑定,却未能学会对语义等价的不同表述保持一致判断。这折射出当前RLHF(基于人类反馈的强化学习)对齐方法的一个已知局限——人类标注者在审核训练数据时,同样容易受到措辞表面特征的影响,导致模型继承了这种"以词取义"的偏差。研究者将其归纳为对齐的"脆弱性"(alignment brittleness):模型看似具备价值判断能力,但这种能力对语言形式的变化异常敏感,缺乏真正语义层面的稳健性。
项目本身:一个关于强制选择的隐喻
抛开AI审核话题,amfly项目本身在概念上颇有意思。它把一个哲学式的两难困境——在无法两全的选项中被迫权衡——转化为一个可交互的3D场景。果蝇被限制只能操作5根中的2根电线,意味着它无论如何都无法让所有个体都保持在"安全"电压之上,这种结构性的困境正是其"恐怖"内核所在。
作者坦言,模型提供的代码只是起点,为了让3D场景达到满意效果,他"个人花了很长时间调整"。这也印证了一个现实:即便是Opus 5这样的顶级模型,在涉及具体的视觉呈现、场景美术和交互调优时,人类的手动介入依然不可替代。AI擅长搭建框架和生成基础逻辑,但艺术表达的最后一公里仍需创作者亲力亲为。
对AI内容审核的几点思考
这个案例虽小,却折射出大模型治理中的深层张力。一方面,厂商希望模型能够拒绝真正有害的请求;另一方面,过于依赖关键词的审核机制既容易"误伤"合法的创意表达,又容易被简单的措辞替换所绕过——两头都不讨好。
对于开发者和创作者而言,这意味着与模型协作时,如何清晰、中性地描述意图变得格外重要。带有情绪色彩或极端隐喻的表达,可能会无谓地触发拒绝;而更技术化、更类型化的框架,反而更容易获得配合。
值得追问的是:一个能被"换个说法"就绕过的审核机制,究竟保护了什么?如果Opus 5能识别出"Horror themed project"与被它拒绝的原始描述指向的是同一件事,它是否应该做出一致的判断?这些问题目前还没有令人满意的答案,也正是AI对齐研究持续攻坚的方向。
结语
amfly是一个规模不大的个人开源实验,但它无意中成为了一次生动的AI行为观察样本。它提醒我们,当下的大模型在伦理判断上仍高度依赖语言表层信号,其"价值观"更像是一套可被措辞影响的过滤器,而非稳定的深层理解。对于关注AI安全与人机协作的人来说,这类来自真实使用场景的边缘案例,往往比实验室基准测试更能揭示模型的真实边界。
相关推荐
Bend编程语言:用形式化证明拦截AI错误并跑在GPU上
Bend编程语言:用形式化证明拦截AI错误并跑在GPU上
Bend是一门在Hacker News引发热议的编程语言,通过形式化证明拦截AI生成代码的错误,并原生运行在GPU上实现自动并行。本文解析其核心理念、技术路线与社区疑问。
Bonsai 2 27B:9倍压缩下的近无损模型探索
Bonsai 2 27B 声称在近无损前提下将 27B 大模型压缩至原体积的九分之一。本文解析其压缩技术路径、社区反应与实际部署价值,并给出验证建议。
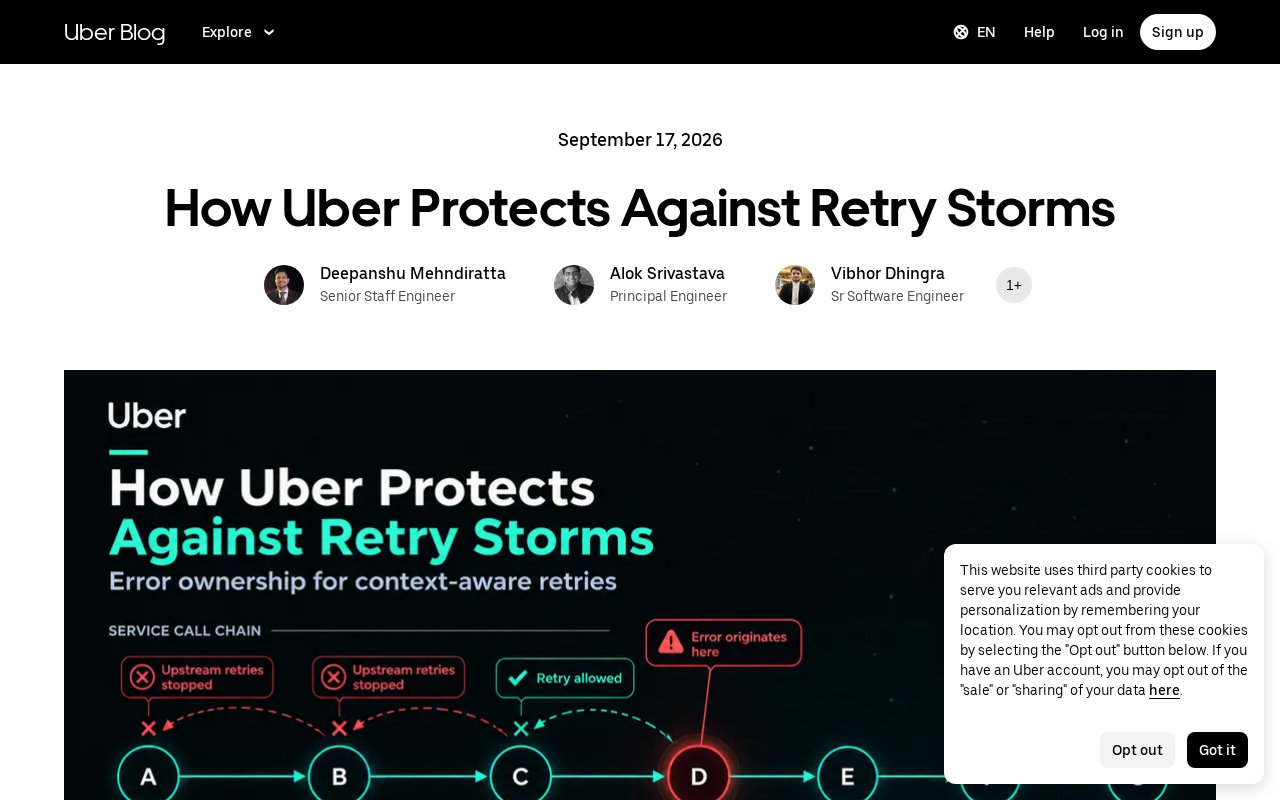
Uber如何防御重试风暴:分布式系统的容错设计
Uber如何防御重试风暴?本文解析分布式系统中重试流量的放大效应,以及重试预算、断路器、指数退避与抖动等容错设计策略,帮助工程团队构建更稳定的弹性系统。