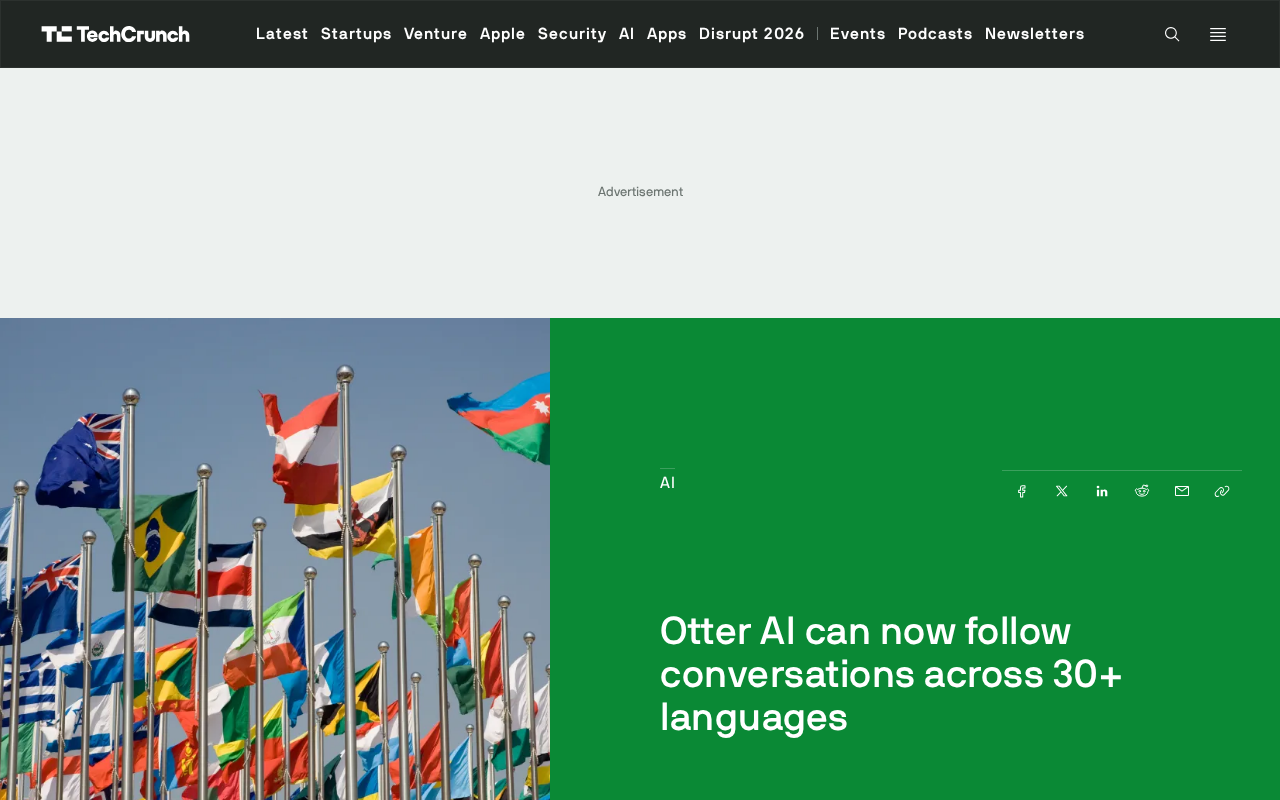
Otter AI 支持30+语言,跨语言对话追踪即将上线

Otter AI新增27种语言并预告跨语言跟随转写,多语言转写竞争转向场景覆盖。
Otter AI 宣布新增27种语言支持,总覆盖量超过30种,且并非界面本地化,而是底层语音识别模型直接支持多语言。更值得关注的是其预告的跨语言跟随功能:当说话者在对话中切换语言时,系统能继续跟踪并完成转写,直击语码转换这一真实痛点。文章指出,语音转写市场竞争正从准确率转向场景覆盖,Otter AI 采取广度优先策略快速扩大用户群,但小语种识别质量、跨语言功能的上线时间与技术实现仍待验证。多语言会议、教育研究及双语使用者是最直接受益群体,而新增语言的具体清单和非拉丁语系表现将决定实际可用性。
从英语到30+语言:Otter AI 的转写版图再扩张
Otter AI 最近新增了27种语言支持,使其总语言覆盖量达到30种以上。这意味着,更多非英语用户可以直接用母语进行会议记录、访谈整理或课堂笔记的实时转写。
作为一款以语音转写和会议纪要为核心的工具,Otter AI 此前主要面向英语场景。此次语言扩充并非简单的界面本地化,而是底层语音识别模型对多种语言的直接支持。对于跨国团队、多语种内容创作者以及需要处理外语素材的研究者来说,这一步意味着更少的手动切换和更连贯的工作流。
跨语言对话追踪:真正值得关注的功能
比语言数量更值得关注的是 Otter AI 同时透露的一项即将推出的功能:当对话中的说话者在不同语言之间切换时,系统能够继续跟随并完成转写。
这个能力切中了一个真实痛点。在跨国团队会议或双语家庭场景中,说话者经常在句子中间夹杂另一种语言——比如英语中嵌入西班牙语短语,或者中文对话里突然出现英文术语。传统转写工具通常需要预先指定单一语言,遇到语码转换时容易漏字或识别错误。如果 Otter AI 能实现跨语言跟随,它就从"多语言工具"进化成了"多语言对话理解工具"。
目前该功能尚未正式上线,Otter AI 也没有披露具体的技术实现方式或准确的发布时间。
语码转换(Code-Switching) 是社会语言学和语言技术中的核心概念,指说话者在同一段对话或句子中交替使用两种或更多语言的现象。它在双语社区、跨国团队和移民家庭中极为常见,例如“我今天有一个deadline要赶”这样中英混杂的表达。对语音识别系统而言,语码转换是公认的难点:传统模型通常要求输入语音属于单一语言,声学模型和语言模型都基于单语假设训练,一旦检测到语言切换就容易出现切分歧义、词汇漏识或错误翻译。学术界通常将语码转换分为句间转换(inter-sentential)和句内转换(intra-sentential),后者难度更高。解决这一问题需要多语言联合建模、语言边界检测以及动态语言模型切换等技术。Otter AI 宣称的跨语言跟随能力,本质上就是要在工程上处理句内语码转换。
多语言转写赛道的竞争逻辑
语音转写市场的竞争正在从"准确率"转向"场景覆盖"。英语转写的准确率已经普遍达到可用水平,差异化的空间转移到了小语种支持、口音适应和混合语言处理上。
Otter AI 一次性增加27种语言,走的是广度优先的路线。这种策略的优势在于快速覆盖更多用户群体,但每种语言的识别质量是否一致,尤其是资源较少的小语种,还需要实际使用来验证。跨语言跟随功能的推出节奏,也将决定它能否在混合语言场景中建立先发优势。
对用户而言,更实际的问题是:新增的27种语言具体包含哪些?对于非拉丁语系的语言,转写和标点处理的表现如何?这些细节将直接影响工具在真实工作场景中的可用性。
小语种语音识别的资源困境是理解多语言转写质量差异的关键背景。主流语音识别模型的训练依赖成百上千小时的标注语音数据,而英语、中文等大语种拥有充足的公开和商业语料,冰岛语、斯瓦希里语等资源较少语言的可获取标注数据往往只有几十小时甚至更少。数据稀缺直接导致声学模型覆盖不足、语言模型困惑度高,进而表现为识别准确率下降、标点恢复错误和专有名词识别困难。此外,非拉丁语系语言还面临分词、形态变化和书写系统差异等额外挑战。行业常用的缓解手段包括多语言联合训练、迁移学习、自监督预训练(如 wav2vec 2.0、Whisper 系列)以及数据增强。因此,“新增27种语言”并不等于27种语言都达到同等可用水平,小语种的实际表现需要独立评测。
谁会更受益
多语言会议是 Otter AI 此次更新最直接的目标场景。跨国公司的日常同步、与海外客户的沟通记录、多语种播客的内容整理,都可以减少后期人工校对的工作量。
教育和研究场景同样值得关注。留学生课堂录音、多语言田野调查访谈,过去往往需要借助额外的翻译工具或人工听写。如果转写工具能直接处理多语言内容,整理成本会显著下降。
跨语言跟随功能如果落地,最典型的受益者将是双语使用者本人——那些在对话中自然切换语言、却找不到合适工具记录的人。
从技术路线看,Otter AI 的多语言能力大概率建立在端到端语音识别架构之上,而非传统的“声学模型+发音词典+语言模型”拼接方案。端到端模型将语音直接映射为文本,便于通过多语言联合训练共享底层声学表征,这也是近年来 Whisper 等模型能够以单一模型覆盖近百种语言的原因。不过,端到端模型在小语种上的表现高度依赖预训练数据的分布,且在不同语言间可能出现“负迁移”——即增加语言种类反而稀释了单语言的识别精度。对用户而言,判断一次多语言更新是否实在,关键指标包括各语言的词错误率(WER)、标点与大小写恢复质量,以及混合语言场景下的实时跟随延迟。这些指标通常不会出现在产品宣传中,却决定了工具在真实会议中的可用性。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。