欧盟AI法案落地难:合规证据为何总在失效?

工作坊研究揭示欧盟AI法案合规面临指标翻译、人类监督与证据时效三重张力,合规应是持续过程。
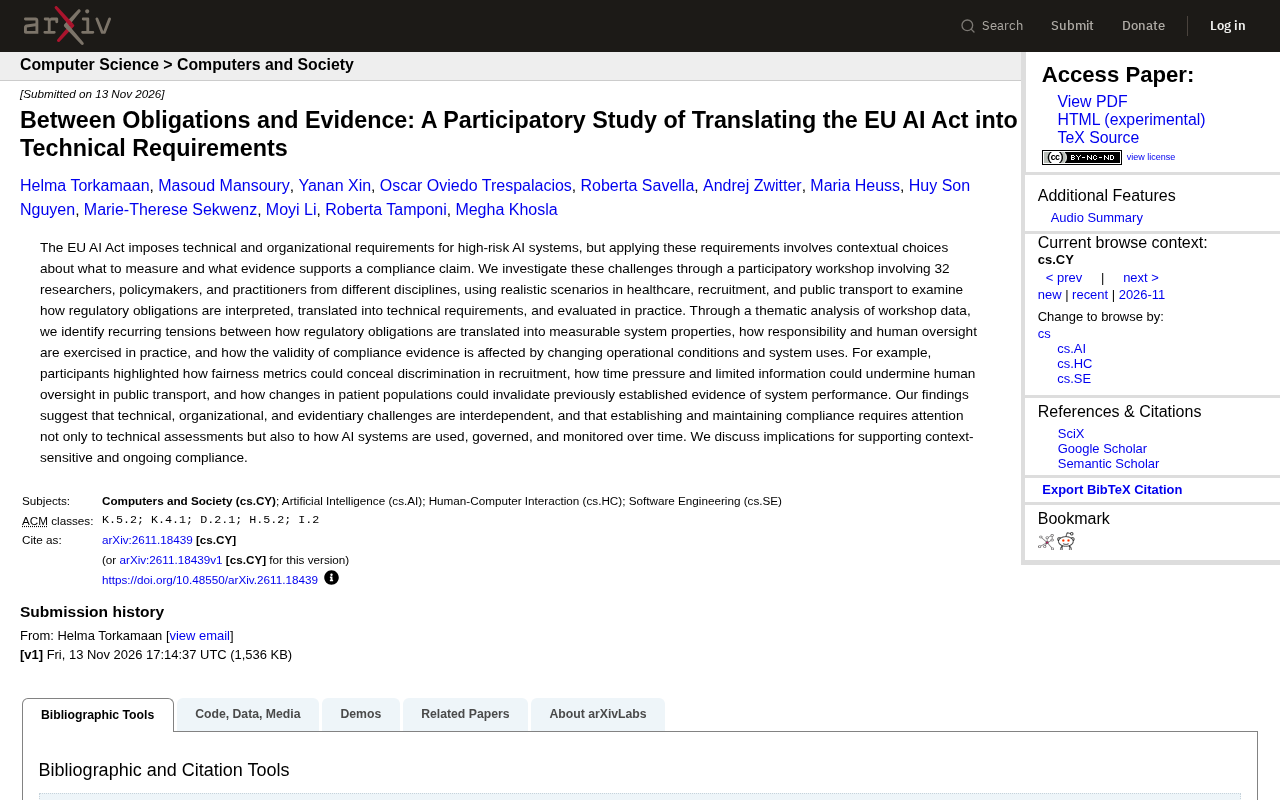
该研究通过邀请32位研究者、政策制定者和从业者参与参与式工作坊,覆盖医疗、招聘和公共交通三个现实场景,考察《欧盟人工智能法案》从法律条文转化为技术要求的实际困难。主题分析识别出三类反复出现的张力:一是指标翻译问题,公平性度量方式选择不当可能掩盖实质性歧视;二是人类监督在时间压力和信息不足下流于形式;三是合规证据会因人群结构、部署环境等条件变化而失效。研究结论指出,技术、组织与证据三方面挑战相互依赖,合规不应被视为一次性认证,而需建立情境敏感、持续维护的机制,并呼吁政策设计为情境化判断留出空间同时要求透明记录判断依据。
一项邀请32位研究者、政策制定者和从业者参与的参与式工作坊研究,揭示了《欧盟人工智能法案》从法律条文走向技术要求的真实困境:合规不是一次性的技术评估,而是需要持续维护的动态过程。
研究背景:当法规遇上工程实践
《欧盟人工智能法案》对高风险AI系统提出了技术与组织层面的要求,但在实际操作中,把这些要求转化为可测量的系统属性,需要大量情境化的判断——衡量什么、用什么证据支撑合规声明,都没有标准答案。
该研究采用参与式工作坊方法,覆盖医疗、招聘和公共交通三个现实场景,通过主题分析识别出反复出现的张力。研究者的核心判断是:技术、组织与证据三方面的挑战相互依赖,建立并维持合规,不能只看技术评估,还要关注AI系统如何被使用、治理和长期监测。
《欧盟人工智能法案》(EU AI Act)于2024年正式生效,是全球首部对AI系统进行风险分级监管的综合性立法。它将AI系统划分为不可接受风险、高风险、有限风险和最小风险四个等级,其中高风险系统(如用于医疗诊断、招聘筛选、关键基础设施管理的AI)须满足风险管理体系、数据治理、技术文档、透明度、人类监督等一系列合规义务。法案采取分阶段实施:禁止性条款已于2025年初适用,而高风险系统的核心义务则设定了更长的过渡期。这种“风险分级+分阶段”的架构,意味着合规不是单一时间点的验收,而是贯穿系统全生命周期的持续义务——这也是理解本研究为何强调“持续合规”的制度前提。
三大张力:翻译、责任与证据的裂缝
指标翻译:公平性度量可能掩盖歧视
将监管义务翻译成可测量的系统属性,是合规链条的第一环,也是最容易失真的环节。工作坊参与者指出,在招聘场景中,公平性指标本身可能反而掩盖歧视——当度量方式选择不当时,看似达标的数字会掩盖实质性的不公平。
这说明一个更深层的问题:监管条文描述的是价值目标(如公平),而技术指标只能捕捉价值的某个侧面。选择哪种度量、如何设定阈值,本身就是一种带有价值判断的决策,但这一决策过程在合规文档中往往不可见。
公平性度量本身是一个充满争议的技术领域。常见的统计均等(不同群体通过率相同)、机会均等(不同群体真阳性率相同)、预测均等(不同群体精确率相同)等指标在数学上互不兼容——满足其中一个往往意味着违反另一个。这意味着没有任何单一指标能完整刻画“公平”。在招聘等场景中,若仅以群体通过率作为达标依据,模型可能通过略微调整决策边界来“刷指标”,而实质性的分配不公依然存在。这被称为“公平性洗白”(fairness washing)。因此,度量选择实质上是价值排序问题,需要说明为何在特定场景下优先保障哪种公平,而非把指标达标等同于合规完成。
人类监督:在时间压力下形同虚设
法案强调人类监督,但工作坊揭示了实践中的落差。在公共交通场景中,时间压力和信息有限会削弱人类监督的有效性——监督者需要在极短时间内做出判断,却缺乏足够信息支撑。
这触及合规评估的一个盲区:制度设计假定监督者有能力、有信息、有时间做出理性判断,但现实操作条件往往不满足这些前提。仅检查“是否设置了人类监督环节”是不够的,还要追问监督在真实条件下是否真的有效。
“人类监督”(human oversight)在AI治理文献中通常区分为三种模式:人在回路中(human-in-the-loop,监督者须逐项确认系统输出)、人在回路上(human-on-the-loop,监督者监控系统运行并在异常时介入)、人在命令链中(human-in-command,监督者可随时中止系统)。欧盟AI法案要求高风险系统具备有效的人类监督能力,但并未规定具体模式。研究揭示的公共交通场景问题正属于“人在回路上”模式的典型困境:监督者名义上保有干预权,但当决策节奏快于人类反应速度、或界面呈现的信息不足以支撑判断时,干预权就沦为形式。有效监督因此不仅是制度安排问题,还涉及人机交互设计、信息呈现方式与操作时间预算的工程约束。
证据有效性:环境变化会让旧证据失效
合规证据的有效期问题在工作坊中被反复提及。医疗场景中,患者人群结构的变化可能使此前建立的系统性能证据失效——系统在原有数据分布下表现良好,不代表在新的人群构成下依然可靠。
这意味着合规证据不是静态资产,而是有保质期的动态结论。当系统的使用条件、部署环境或服务对象发生变化时,原有证据的效力需要重新审视。
在机器学习工程实践中,与“证据失效”直接对应的概念是数据漂移(data drift)与概念漂移(concept drift)。数据漂移指输入数据的分布发生变化(如患者人群构成改变),概念漂移指输入与输出之间的真实映射关系发生变化(如临床指南更新导致原有诊断标准不再适用)。两者都会使基于历史数据建立的性能评估失去外推效力。正因如此,欧盟AI法案要求高风险系统建立上市后监测(post-market monitoring)与风险管理体系,其核心逻辑正是承认合规证据具有时效性:部署方须持续采集运行数据、设定漂移监测阈值,并在触发条件满足时重新验证系统性能,而非以一次性测试报告作为永久合规凭据。
从一次性认证到持续合规
研究的一个重要结论是:技术、组织与证据挑战彼此交织,不能分开处理。一个公平性指标的选择(技术决策)会影响组织如何分配监督责任,也会决定什么样的证据足以支撑合规声明。
这指向一种情境敏感且持续的合规思路。合规不应被理解为交付一份文档或通过一次评估,而应包含对系统使用方式、治理结构和监测机制的持续关注。对开发者和部署方而言,这意味着需要建立能够追踪系统运行条件变化的机制,并在条件改变时重新评估证据的有效性。对政策制定者而言,则需要在规则设计中为情境化判断留出空间,同时要求对判断依据进行透明记录。
该研究的价值在于把合规问题从纸面条文拉回到真实工作场景中,呈现了翻译、监督与证据三个环节上的具体裂缝。这些裂缝不是靠更细的技术标准就能自动弥合的,它们需要技术、组织与治理层面的协同回应。
说明:本文基于单一来源的参与式工作坊研究,涉及的具体场景与结论均来自该研究的主题分析,尚未经过多源交叉验证。
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。