Ovren Live Preview:用自然语言实时预览产品改动

Ovren 用自然语言描述改动,在安全副本上生成代码并提供真实页面实时预览,确认后再合并 PR。
Ovren Live Preview 是一款在 Product Hunt 上获得 135 票、排名第 3 的 AI 编程协作工具。其核心流程是:用户用自然语言描述前端改动,Ovren 在项目安全副本上生成代码,并直接在真实页面上提供可交互的实时预览;用户确认效果后,再由团队合并 pull request。这一设计把预览环节提前到代码合并之前,缩短了反馈链路,并让产品经理、设计师等非技术成员也能直观参与改动验证。文章分析了其介于 AI 代码生成工具与低代码平台之间的定位,指出其优势在于不替代开发者、保留代码审查,同时讨论了复杂项目支持、代码质量、技术栈集成和团队信任等潜在挑战。
在AI编程工具层出不穷的今天,Ovren Live Preview 提出了一种更贴近团队协作的交互方式:用自然语言描述改动,直接在你的真实页面上看到效果,确认后再合并代码。这个产品在 Product Hunt 上获得了 135 票和 38 条评论,排名第 3,分类为开发者工具、人工智能和无代码。
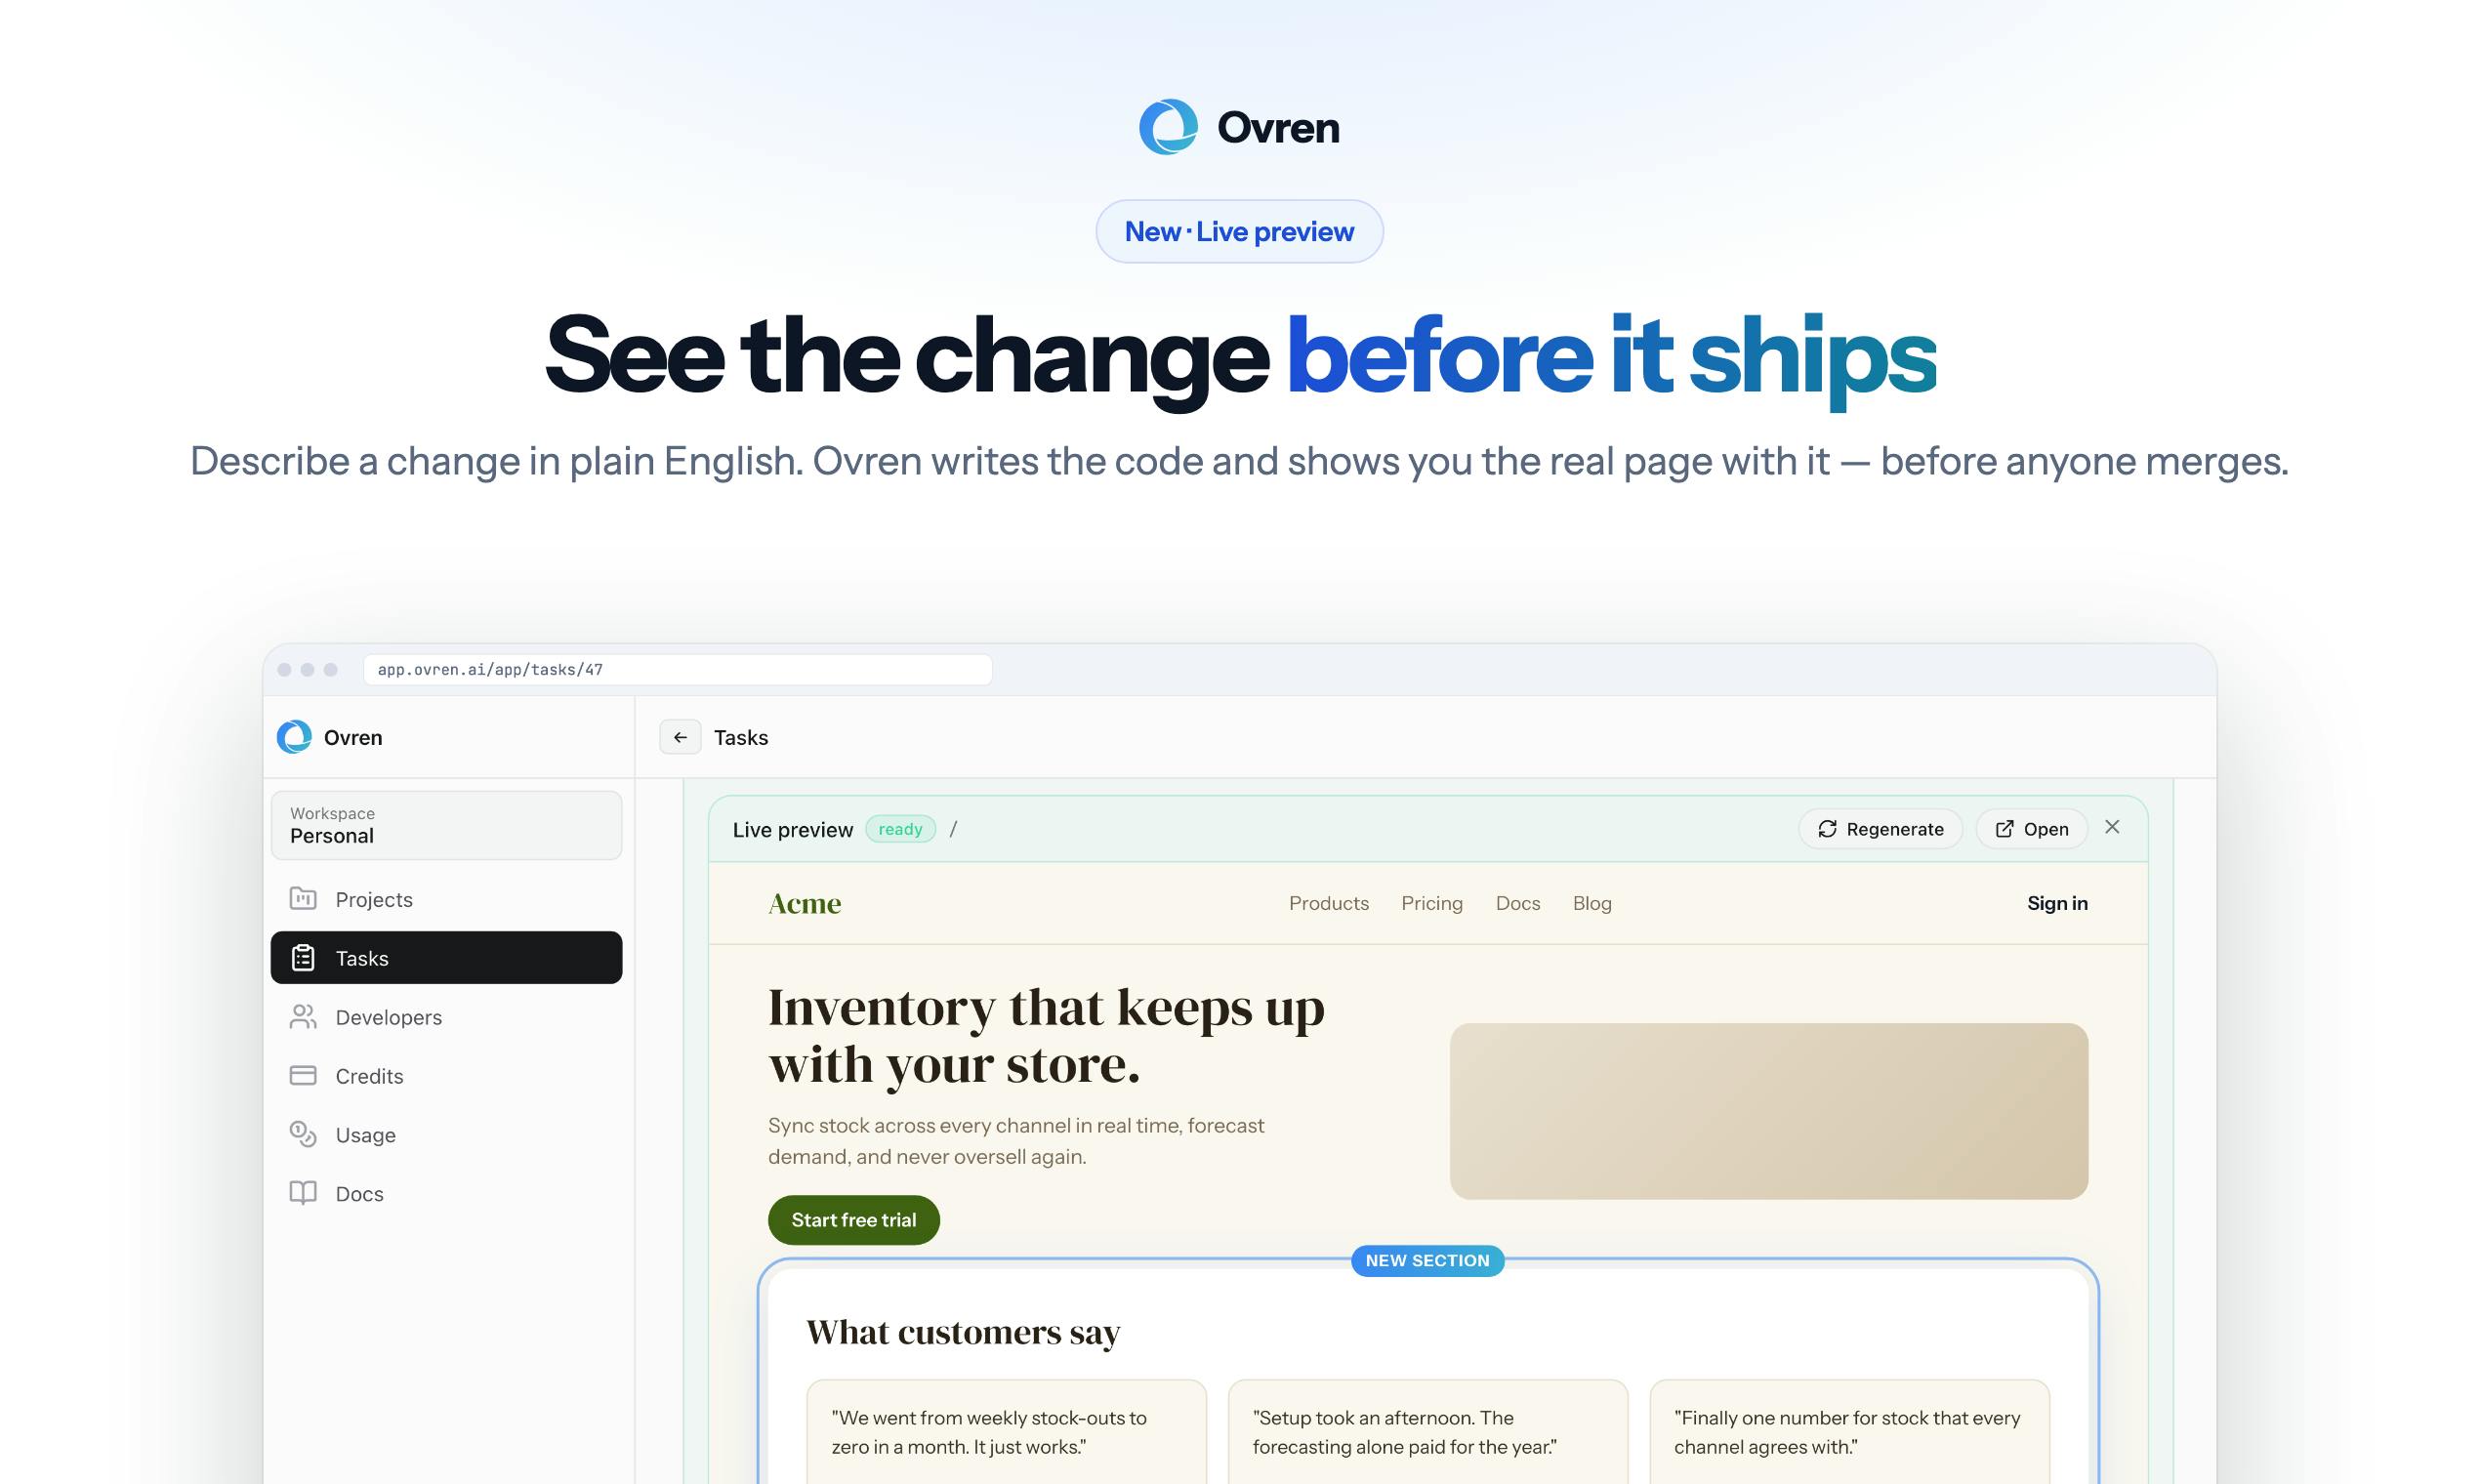
Ovren 是什么?
Ovren 的核心流程非常简洁:你描述一个改动,Ovren 会在项目的一个安全副本上编写代码,并为你提供每个前端改动的实时预览——你看到的是真实的页面,只不过上面应用了新的改动。你可以点击浏览、确认,然后由团队合并 pull request。
这解决了 AI 编程工具的一个常见痛点:生成的代码需要经过合并、部署才能看到效果,反馈链路长,而且容易在合并后才发现问题。Ovren 把预览提前到了代码合并之前,让非技术成员也能直观地参与决策。
核心功能拆解
自然语言驱动改动
你不需要写代码或操作复杂的界面,只需用平实的语言描述想要的变化。Ovren 负责将其转化为代码,并在隔离的环境中执行。这降低了参与产品迭代的门槛,产品经理、设计师甚至业务方都可以直接提出并验证改动。
自然语言到代码的转换(NL2Code) 是指利用大型语言模型将人类用日常语言描述的意图,自动翻译成可执行的程序代码。这类系统通常基于在海量代码语料上预训练的模型(如 Codex、StarCoder、Code Llama 等),通过理解上下文(如项目结构、已有文件、依赖关系)来生成符合语法和风格的代码片段。由于自然语言存在歧义,模型往往需要结合检索增强生成(RAG)或仓库级上下文来提升准确性。在 Ovren 的场景中,NL2Code 不仅要生成代码,还要保证改动可运行、可预览,因此对模型理解具体项目的能力提出了更高要求。
真实页面上的实时预览
预览不是静态的截图或模拟器,而是运行在真实页面上的应用效果。你可以点击、导航、交互,体验改动后的完整流程。这种“所见即所得”的方式,让验证更接近最终用户体验。
实时预览(Live Preview) 在 Web 开发中通常指开发服务器在代码变更后自动重新构建,并通过热模块替换(HMR)或热重载技术在不刷新页面的情况下即时呈现更新。与静态截图或设计稿不同,实时预览运行的是真实的前端运行时,包含真实的样式、脚本和路由。要让预览在“安全副本”上生效,工具需要具备隔离的运行环境(如容器化沙箱、独立分支部署或预览 URL),并将改动注入到该环境中。预览与生产环境的一致性取决于构建配置、依赖版本和运行时环境是否与生产保持一致,这也是此类工具在实际落地时的主要工程挑战之一。
安全副本与人工审批
所有改动都在项目的一个安全副本上进行,不会直接影响主分支。你确认预览效果后,团队再合并 pull request。这种人机协作模式在提升效率的同时,保留了代码审查和质量控制的环节。
工作流与团队协作
Ovren 的流程可以概括为:描述改动 → 安全副本上生成代码 → 实时预览 → 点击确认 → 团队合并 PR。
这个流程把 AI 生成的内容纳入了现有的 Git 工作流,而不是另起一套系统。对于已经使用 pull request 进行代码审查的团队来说,迁移成本较低。同时,实时预览让审查不再只依赖代码 diff,而是可以直观看到界面变化,尤其适合前端改动频繁的产品。
对 AI 编程工具市场的意义
当前 AI 编程工具大致分为两类:一类是代码补全和生成工具,帮助开发者更快写代码;另一类是低代码/无代码平台,让非开发者搭建应用。Ovren 介于两者之间——它用自然语言降低改动门槛,但又保留了代码和 PR 流程。
这种定位的巧妙之处在于,它不试图替代开发者,而是把产品经理、设计师等角色拉入到改动验证的环节中。在 AI 生成代码越来越普遍的背景下,“如何高效验证 AI 生成的改动”正在成为一个独立的问题,Ovren 提供了一个可操作的答案。
潜在挑战与观察
从 Product Hunt 的评论数和投票数来看,Ovren 获得了开发者和产品团队的初步关注。不过,这类工具的成功取决于几个因素:对复杂前端项目的支持程度、生成代码的质量和可维护性、与现有技术栈的集成能力,以及团队对 AI 生成代码的信任度。
此外,“安全副本”的机制如何实现、预览环境与生产环境的一致性如何保证,也是实际使用中需要验证的关键点。目前这些细节在公开信息中有限,值得后续关注。
适合谁使用?
Ovren 看起来最适合以下场景:
- 产品团队需要快速验证前端改动,而不想等待完整的开发-部署周期;
- 非技术成员希望直接参与改动确认,减少沟通成本;
- 开发团队希望在不牺牲代码审查的前提下,加速迭代反馈。
如果你所在的团队正在寻找一种让 AI 辅助开发更透明、更可控的方式,Ovren 值得加入观察列表。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。