爬虫JS逆向:抖音a_bogus加密参数定位实战
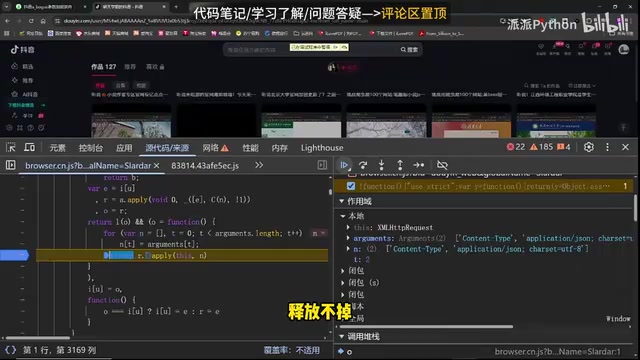
通过调用栈跟踪与断点技巧,在混淆JS中定位抖音a_bogus签名的生成位置。
本文以抖音Web端分页接口的签名参数 a_bogus 为例,系统讲解了JS逆向的定位流程。由于代码经过混淆,关键字全局搜索无效,正确做法是在Network面板找到目标接口后,利用带路径条件的XHR断点跟踪调用栈,逐帧回溯签名生成位置。跟栈过程中需优先观察XHR请求对象而非字符串URL,因为前者保存最新状态。文章还揭示了调试器的一个典型陷阱:由于JS对象是引用类型,调试器侧边栏展示的始终是当前内存状态,导致在签名生成之前的栈帧里也能看到最终值,容易让新手误判生成位置。善用日志断点和条件判断可将变量导出到全局,完成从定位到提取的完整闭环。
抖音a_bogus到底难在哪
抖音Web端的接口在每次分页请求时都会带上一个名为 a_bogus 的查询参数,值很长,且随请求上下文变化。它不是随机字符串,而是前端 JS 在本地计算出来的签名,服务端会拿同一套规则做校验。相比它的一些兄弟字段,a_bogus 是真正卡住初学者的那一环:既不在 Cookie 里,也不在请求头里,而是在请求发出前被拼进 URL 的查询串。
视频里把这部分的问题边界划得很清楚——要做的事只有三件:定位生成位置、分析生成过程、拿到正确的值。至于补环境、初始化、原型链,属于后续课程的内容。
定位第一步:从网络面板锁定接口
F12 打开开发者工具,切到 Network 面板,把页面往下滑触发分页,列表里会多出目标接口的请求。判断哪个请求是目标,靠的是响应内容:展开 Response,里面正是想要的列表数据,那这个 XHR 就是入口。视频里有人问「怎么知道就是这个接口」,答案就是看响应,不要靠猜。
接着看这个请求携带了什么。查询参数里除了常规字段,还混着一长串看起来无意义的字符串,那才是需要逆向的部分。客户端带着它发给服务端,服务端做校验,这就是绕不开 JS 逆向的根本原因。
关键字搜索走不通,就上调用栈
最省事的定位方式是全局搜索 a_bogus 字符串。视频里试了一遍:搜不到。这段代码在打包压缩后被混淆,字段名在运行时才拼出来,静态搜索自然没有结果。
那就换成跟栈。在 Sources 面板的调用栈里能看到这个请求经过了一长串调用帧。直接在第一个帧上打断点会遇到问题:页面还没触发分页事件就被断住了,因为这个 URL 路径被很多请求共用。解决办法是按路径过滤,在断点条件里写上目标接口的路径,只有匹配时才停。
跟栈时该盯哪个字段
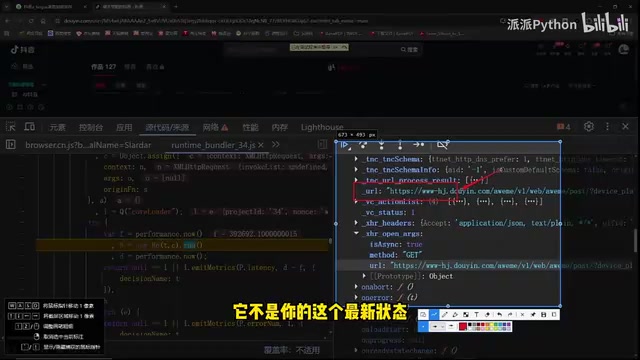
顺着调用帧往上走,帧里的局部变量会暴露中间状态。这里有个容易走错的细节:不要只看字符串形式的 URL,它可能不是最新状态。真正的最新状态写在 XHR 对象里(payload、open 的参数),因为后面的函数改的是同一个请求对象的引用。
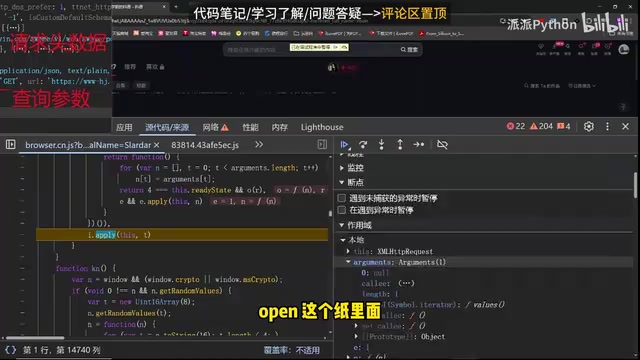
视频里用了一个借书的比喻:你借给同学的书,同学又转借给别人,你手里的状态早就过期了,最新状态在那个对象里。所以跟栈时优先看 XHR 对象,而不是字符串 URL。
JS 混淆(Obfuscation)是前端反爬的常见手段。打包工具(如 Webpack)在构建时会将变量名压缩为单字母、把字符串拆散拼接、把属性访问改写成数组索引查找,使得关键字在静态文件中完全消失。a_bogus 这类字段名在运行时往往是通过类似 obj[arr[42]] 的方式动态取到的,arr[42] 才是真正存储字符串的地方,而 arr 本身可能还经过了移位或加密初始化。这就是为什么全局搜索字面量会一无所获——源码里根本不存在这个字符串。调用栈跟踪(Call Stack Tracing)绕过了静态分析的局限:它不管代码长什么样,只关心「这个请求在浏览器里实际走过了哪些函数」,因此混淆程度再高也无法阻止你从运行时行为里找到签名的生成入口。
断点策略:XHR 断点加日志断点
一路往上跟,会跟到 bdms 这个 JS 文件。它调用了某个方法,代码模式大致是把函数挂到对象上、把参数塞进去,结果落在另一个变量里。形如把 d 和 e 写进 n 的赋值,最终产物在结果变量和参数变量上,所以要观察的是这两个值的变化。
这里推荐打日志断点而不是普通断点:在条件里写一段日志表达式,把参数值和结果值打印出来,加个固定前缀方便筛选。
刷新页面后控制台会输出大量日志,等它断住,就能看到 a_bogus 出现在变量里——这就是「从无到有」的临界点。再进一步,可以写条件判断:如果某个字段的名字是 a_bogus,就把它挂到全局变量上,方便之后在控制台直接调用。到这一步,生成位置就锁定了。
Chrome DevTools 提供两种与本文密切相关的断点类型。条件断点(Conditional Breakpoint):右键行号选择「Add conditional breakpoint」,只有表达式为真时才会暂停执行,适合在高频调用的函数里只拦截目标请求。日志断点(Logpoint):右键行号选择「Add logpoint」,执行到该行时把表达式的值打印到 Console,而不会暂停页面——这对不想打断页面正常流程、只想观察数据流动的场景非常高效。两者组合使用的典型模式是:先用条件断点锁定目标帧,再换成日志断点批量采集中间变量,避免反复手动单步造成页面超时或状态丢失。
调试器的「幻觉」:为什么生成之前的栈里也有值
这是整段分享里最有价值的部分。
跟栈跟到一半,有人在更早的位置下了断点,展开作用域后发现:这里居然也有 a_bogus?明明还没执行到生成那一行。于是怀疑自己找错了地方,往前翻半天,什么都找不到。
原因在调试器的特性。JS 里请求对象是引用类型,生成 a_bogus 之后代码并不会销毁它,而是把它写进请求对象或改写了 URL。后续所有栈帧处理的是同一个对象,引用的是同一块内存。调试器侧边栏显示的是「断点停住那一刻」的变量值,而不是「这一帧执行时」的值。所以你回看堆栈里的任意一层,只要它引用了同一个对象,看到的都是已经带上 a_bogus 的最终状态。
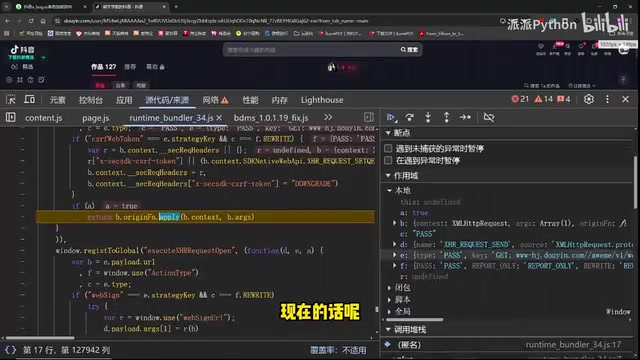
验证方法很简单:把断点挪到你认为的生成位置之前,刷新页面展开作用域,没有那个值就说明位置不对。更严谨的做法是给断点加条件,只有 URL 指向目标接口时才停住,再看作用域里有没有这个参数。
这个坑对零基础的人格外不友好,因为它会让你在一个根本不存在生成逻辑的地方反复翻找。
理解这个现象需要区分两个概念:值类型与引用类型。JavaScript 中的原始值(字符串、数字)在赋值时会复制一份,互不影响;而对象、数组等引用类型赋值时只复制了「指向同一块内存的指针」。XHR 对象属于引用类型,当函数 A 把它传给函数 B、函数 B 再传给函数 C,三个函数操作的是同一个对象。调试器侧边栏(Scope 面板)展示的是当前时刻内存里该对象的状态,而不是「该帧执行完毕时」的快照。因此,无论你在调用栈的哪一层点击查看,只要那一层持有对该对象的引用,就会看到对象的最新状态——也就是在整个调用链走完之后被写入的 a_bogus。这一行为在 Chrome DevTools 中是已知的「live binding」特性,并非 bug,但对逆向新手来说极易造成「签名在更早的地方就生成了」的错觉。
学习路线怎么搭
视频里提到,作者花了三个月、和多位从业者反复沟通修改,整理出一份面向零基础的爬虫逆向学习路线,按阶段标注了学什么、怎么学、学多久、学到什么程度,并配了对应的文档与教程。对刚接触 Python 的大学生或者想转行做爬虫的职场人来说,这样的路线能省掉大量试错时间。不过路线图本身不产生能力,跟完一个像 a_bogus 这样完整的案例,比看完十份大纲都有用。
这次分享只覆盖了定位和跟栈两部分,补环境、初始化配置、原型链等内容留在了后半段。
一点合规提醒
JS 逆向在爬虫、接口调试、前端安全分析里都是常规技能,但实际使用时需要留意目标站点的 robots 协议与服务条款、请求频率,以及个人信息保护与数据安全相关的法律规定。把这类技术用在学习和授权测试上没有问题,用来绕过他人的访问控制或大规模抓取受保护数据,则会带来实实在在的法律风险。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。