旁遮普歌曲有毒内容数据集PGT-FG发布
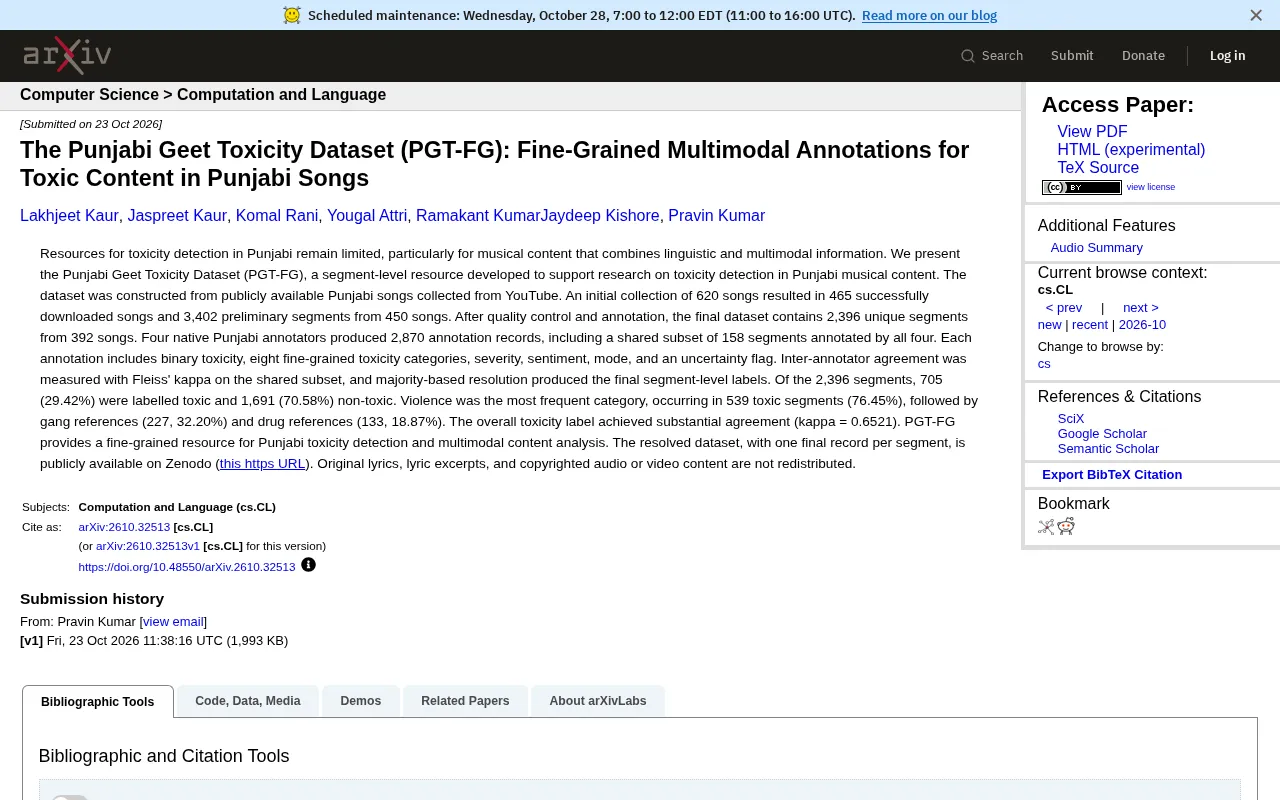
旁遮普语音乐毒性数据集PGT-FG发布,含2396个片段级细粒度多模态标注。
研究者构建了Punjabi Geet Toxicity Dataset(PGT-FG),一个面向旁遮普语音乐内容的片段级细粒度多模态毒性标注数据集。数据来自YouTube公开旁遮普语歌曲,经切片和质控后保留2396个片段,由四位母语者完成2870条标注,涵盖二分类毒性、八个细粒度类别、严重程度、情感与不确定性标记。29.42%的片段被标为有毒,暴力类占比最高。整体毒性标签的Fleiss' kappa为0.6521,属实质性一致。数据集已在Zenodo公开,但受版权限制不含原始歌词与音视频。
音乐平台的内容审核一直是个麻烦事——文字、音频、画面交织在一起,毒性内容往往藏在歌词的隐喻和旋律的情绪里。对于低资源语言来说,这个难题还要再叠加一层:标注数据稀缺、语言工具链不完善。旁遮普语就处在这样的境地。
近期发布的一个学术资源试图填补这块空白。研究者构建了 Punjabi Geet Toxicity Dataset(PGT-FG),一个面向旁遮普语音乐内容的细粒度多模态毒性标注数据集。
数据集是怎么搭起来的
从620首歌到2396个片段
数据来源是YouTube上公开可获取的旁遮普语歌曲。研究团队最初收集了620首歌,成功下载465首,从中切分出3,402个初步片段(覆盖450首歌)。经过质量控制和标注流程后,最终保留 2,396个独立片段,来自392首歌。
切片这一步值得注意。歌曲级别的毒性判断粒度太粗,一首歌里可能副歌部分干净、主歌段落却含暴力或帮派指涉。按片段标注,才能支撑更精细的检测模型训练。
片段级标注(segment-level annotation) 指将一段较长的媒体内容切分为若干短片段,再对每个片段单独赋予标签,而非只对整首歌曲给出一个整体标签。在音乐毒性检测中,这种做法能捕捉到歌曲内部标签分布不均的情况,例如副歌干净而主歌含暴力指涉。片段级标签也使模型训练样本量成倍增加,并更贴近真实内容审核中按时间窗口截取、逐段判定的工作方式。代价是切片边界的选择会影响标签质量,需要制定统一的切分规则并保证片段语义相对完整。
四位母语者的标注工程
标注由四位旁遮普语母语者完成,共产生2,870条标注记录。其中158个片段被四位标注者全部覆盖,用于计算一致性指标。
每条标注包含的信息相当丰富:
- 二分类毒性标签
- 八个细粒度毒性类别
- 严重程度
- 情感倾向
- 模态信息
- 不确定性标记
用Fleiss' kappa在共享子集上测一致性,最终以多数投票方式确定每个片段的标签。
Fleiss' kappa 是一种用于衡量多个标注者之间一致性程度的统计指标,适用于三个及以上标注者对同一批样本进行类别标注的场景。其计算基于每个样本被标注为各类别的比例,并校正了随机一致的可能性,取值通常在 -1 到 1 之间(实际应用中多为 0 到 1)。一般经验标准为:低于 0.20 为轻微一致,0.21–0.40 为一般一致,0.41–0.60 为中等一致,0.61–0.80 为实质性一致,0.81 以上为几乎完全一致。本文报告的 0.6521 落在实质性一致区间,说明标注者之间具有较好但非完美的一致性,这与毒性判断本身带有主观性有关。
数据透露了什么
2,396个片段中,705个(29.42%)被标为有毒,1,691个(70.58%)为非有毒。接近三成的毒性比例,说明音乐内容中的毒性问题并非边缘现象。
细粒度类别里,暴力出现频率最高——539个有毒片段(76.45%)涉及暴力内容,其次是帮派指涉(227个,32.20%)和药物指涉(133个,18.87%)。暴力类别的压倒性占比,与旁遮普音乐产业中部分流派长期存在的暴力叙事传统相呼应。
一致性方面,整体毒性标签的kappa值为0.6521,属于"实质性一致"(substantial agreement)区间。在涉及主观判断的毒性标注任务中,这个数字算得上稳健,但也说明约三分之一的边界案例在不同标注者之间存在分歧——这恰好解释了数据集为何要设置不确定性标记。
多模态毒性信号 指毒性不仅体现在歌词文本中,也可能通过音频(如语调、喊叫、特定音效)和视频(如手势、场景、画面文字)传递。对于音乐内容,文本模态可捕捉明示的侮辱或暴力词汇,音频模态可反映情绪强度与攻击性语气,视频模态则可能包含帮派手势等视觉线索。多模态融合模型的目标是将不同模态的特征联合建模,以弥补单一模态漏检的情况。PGT-FG 为每个片段标注了模态信息,使研究者能够分析毒性信号主要来自哪种模态,并据此设计融合策略。
这个数据集解决了什么问题
旁遮普语的毒性检测资源长期匮乏,针对音乐内容的多模态资源更是几乎没有。PGT-FG的价值体现在几个层面。
细粒度标注让模型不只回答"是否有毒",还能区分暴力、帮派、药物等具体类别,这对内容审核的分级处置有实际意义——帮派指涉和暴力威胁的处置策略显然不同。片段级粒度则更贴近真实审核场景。
多模态设计考虑到音乐内容的特殊性。歌词文本之外,音频和视频信息同样承载毒性信号,数据集为后续的多模态融合研究提供了标注基础。
数据集已在Zenodo公开(DOI: 10.5281/zenodo.23040156),以每个片段一条最终记录的形式发布。出于版权考虑,原始歌词、歌词摘录以及受版权保护的音视频内容不随数据集再分发。
局限与观察
版权限制带来一个现实问题:研究者拿到的是标注和引用信息,而非原始媒体文件。复现完整的多模态实验需要自行获取音视频素材,这提高了使用门槛。
标注者仅四人、共享标注子集仅158个片段,一致性评估的统计效力有限。八个毒性类别中部分类别的样本量偏少(如药物指涉仅133个),类别不均衡可能影响模型在小类别上的表现。
另一个值得关注的方向是语言层面的迁移。旁遮普语横跨印度和巴基斯坦,两地使用的书写系统不同(古木基文与沙穆克文),数据来源全部为YouTube公开歌曲,方言和语域覆盖范围在论文中未作详细说明。
对于做低资源语言内容审核的团队,PGT-FG提供了一个可用的起点,尤其是片段级、多标签的标注框架,可以借鉴到其他语言和音乐场景。
古木基文(Gurmukhi)与沙穆克文(Shahmukhi) 是旁遮普语使用的两种主要书写系统。古木基文主要用于印度旁遮普邦,是当地官方文字;沙穆克文则主要在巴基斯坦旁遮普地区使用,字形源自波斯-阿拉伯字母体系。两者虽然记录的是同一种语言,但字符集、书写方向和正字法规范不同,导致自然语言处理工具(如分词器、预训练语言模型)往往需要分别适配。对于毒性检测而言,若训练数据只覆盖其中一种书写系统,模型迁移到另一种时性能可能明显下降,这也是低资源语言资源建设中需要留意的语言变体问题。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。