别看跑分!四个实测标准帮你判断大模型真实水平

跑分越高,模型就越好用吗?
打开任何一个AI资讯平台,你都会看到类似的标题:某某大模型评分再创新高、某模型登顶权威榜单。这些数字看起来光鲜亮丽,却常常与实际使用体验相悖。
你是否也遇到过这样的困惑:评分极高的模型,真正用起来却"特别蠢",答非所问、废话连篇;而另一些分数平平的模型,反倒能实实在在地解决问题。
这种落差的根源在于——跑分是在考试,而使用是在实战。主流AI基准测试(如MMLU、HumanEval、GSM8K等)的设计逻辑源自学术界对模型能力的标准化量化需求:MMLU测试涵盖57个学科的多选题,HumanEval考察代码生成能力,GSM8K评估数学推理。
值得了解的是,这些基准测试诞生于特定的历史语境。MMLU(Massive Multitask Language Understanding)由加州大学伯克利分校于2020年提出,初衷是系统衡量模型跨领域知识广度;HumanEval由OpenAI于2021年设计,聚焦代码功能正确性的自动化验证;GSM8K则由OpenAI于同年发布,专注于小学级别数学推理的多步骤链式评估。这些工具在学术语境下均有其严谨价值——问题是,当模型规模从数亿参数扩张至数千亿参数,训练数据从精选语料扩展到互联网全量爬取,这些设计于"小模型时代"的静态测试集,逐渐从"能力探测器"演变为"分数游戏场"。这些测试的问题在于,题目固定、答案唯一、评分机制透明——这反而催生了"测试集污染"现象。
测试集污染(Benchmark Contamination) 是大模型评估领域长期存在的结构性问题。由于主流基准测试的题目和答案均公开发布,模型在预训练阶段爬取互联网数据时,极可能将这些题目"见过",从而在测试时产生记忆效应而非真实推理能力。这一机制在技术层面被称为"数据泄漏"(Data Leakage):预训练语料中若包含与测试集高度重叠的文本,模型实质上是在"背答案"而非"做推理",其神经网络权重中编码的是特定题目的表面模式,而非可泛化的认知结构。2023年多项研究证实,GPT-4等顶级模型在部分基准上的优秀表现,有相当比例来自训练数据与测试题目的重叠。为应对这一问题,研究界开始探索动态基准(Dynamic Benchmark)——每次评估时自动生成新题目,如HELM-Lite和LiveBench,以持续逼近模型的真实泛化能力。其中LiveBench的设计尤为激进:它通过实时抓取最新数学竞赛题、新闻事件等"模型必然未见过"的内容构建评测题库,并以月度频率更新,从根本上切断了记忆捷径。
即模型训练数据中可能已包含测试题目本身,导致跑分虚高。机构测试题目往往标准化、可量化,但真实场景中的需求千变万化,考验的是模型综合的理解与执行能力。与其盲信第三方评分,不如学会用一套简单的方法自己判断。下面这四个标准,亲手一试便知高下。
标准一:表达力——能不能把复杂问题讲清楚
表达力的强弱,直接决定了一个大模型能否帮你写文案、做报告,乃至教会你新知识。真正优秀的模型,不仅自己"懂",还能把复杂的东西"说明白"。
如何检验
方法很简单:找一个你自己都说不太清楚的观点或概念,让模型来讲解。检验的关键不在于它讲得多深奥,而在于——你听完之后,能不能再转述给父母或年纪较大的长辈,且他们也能听懂。
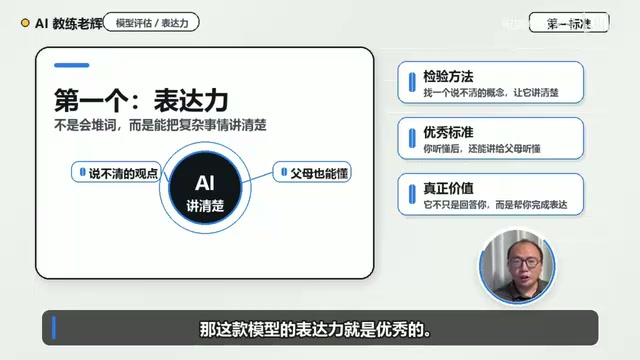
这一检验方法,本质上是物理学家理查德·费曼提出的"费曼学习法"的AI版本。费曼学习法(Feynman Technique) 由诺贝尔物理学奖得主理查德·费曼系统化提出,核心步骤是:选取概念、用简单语言向"外行"解释、识别表达卡壳处、回归原材料补全理解。这一方法揭示了"能讲清楚"与"真正理解"之间的深度关联。
对大语言模型而言,"化繁为简"不仅要求词汇层面的替换,更需要模型具备对受众认知水平的建模能力——即"心智理论"(Theory of Mind,ToM)。心智理论是认知科学中描述个体推测他人信念、意图与知识状态的能力,最初用于研究人类社会认知发展。2022年以来,多项研究开始系统测试大语言模型的心智理论能力:Kosinski(2023)的研究显示GPT-4在标准"错误信念任务"中表现接近人类,但Ullman等人随后指出,模型在经过微小变体修改后便大幅失准,暗示其依赖表面模式而非真正的心智建模。这一争议至今悬而未决。就表达力而言,当模型向不同背景的用户解释同一概念时,它需要动态推断用户的"已知-未知边界"并据此调整语言粒度——这正是心智理论在语言生成中的实际应用。研究表明,当前顶级模型在简单的受众适配任务上已有相当表现,但在多轮动态调整解释粒度方面仍有明显局限。
费曼认为,真正理解一个概念的标志,是能用最简单的语言向外行人解释清楚。认知科学中将此称为"理解的可迁移性"——知识不是孤立存储的,而是能被重新编码并传递给不同认知背景的人。对大模型而言,能做到"化繁为简"意味着模型不只是在做模式匹配,而是具备了对概念的结构性理解与语言适配能力。
如果能做到这一点,说明这个模型的表达力是过硬的。它不只是自己表达清楚了,更帮你完成了"化繁为简"这个最难的动作——把复杂问题拆解成任何人都能理解的语言。这是衡量大模型表达力的黄金标准。
标准二:洞察力——能不能一句话点破核心
洞察力,决定了模型能否在一堆杂乱信息中直接抓住问题关键,而不是在表面现象上打转。
如何检验
给模型抛出一个复杂问题,或者直接扔给它一堆资料,然后观察它的回答。不要看它罗列了多少条,而要看它有没有一句话点破核心。
判断是否点到核心,有两种办法。如果你自己心里有数,一眼就能看出它说得对不对。如果你自己也没把握,还有一个交叉验证的技巧:把它的回答同时发给另外几个AI,让它们互相评价这段分析有没有讲到本质。
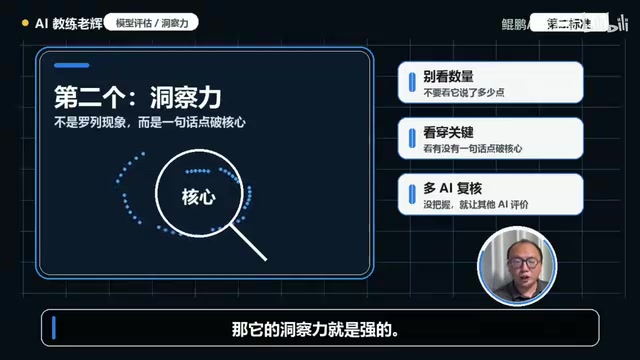
这种"AI评AI"的方法在技术上被称为**"LLM-as-Judge"(大语言模型作为评判者)**,是近年来AI评估领域的重要研究方向。该框架由Zheng等人在MT-Bench论文(2023)中系统提出,优势在于能处理传统自动化指标(如BLEU、ROUGE)无法评估的开放性、主观性任务——BLEU和ROUGE本质上是基于词元重叠率的统计指标,对"说出了关键洞见"这类需要语义判断的维度完全失效。
LLM-as-Judge框架的核心运作方式是:将被评估的回答以结构化提示词(Prompt)输入给评判模型,要求其从特定维度(如准确性、深度、洞察力)给出评分或对比判断。斯坦福大学的AlpacaEval和MT-Bench等评估框架已将这一方法系统化,并在学术界获得广泛采用。然而,单一评判模型存在已知的系统性偏差:位置偏见(更青睐第一个出现的答案)、长度偏见(倾向于给更长回复打高分,即使信息密度并不更高)、自我偏见(倾向于认为与自身输出风格相近的回答更好)。这些偏差已被多项实验所证实,意味着单一AI评判者的结论存在固有的不可靠性。
文章建议"同时发给几个AI交叉评价",本质上是构建了一个多评判者投票系统(Multi-Judge Ensemble)。在统计学上,当多个存在不同系统性偏差的评判者对同一对象独立评分时,其偏差方向往往相互抵消,最终聚合结论的可靠性显著高于任何单一评判者——这一原理与人类专家评审中的"盲审委员会"设计异曲同工。这种多模型交叉验证在方法论上合理且严谨,正是在实践层面对LLM-as-Judge已知缺陷的直觉性修正。
如果大多数AI都认为它讲到了点子上,说明洞察力确实强;如果其他AI普遍反馈"只是罗列现象、没有触及本质",那它的洞察力就有所欠缺。这种方法,某种程度上比单一机构评分更贴近真实能力。
标准三:认知深度——能不能让你跳出思维框架
认知的高低,决定了模型能否带你跳出原有的思维定式,从一个全新角度重新理解一件事。
如何检验
找一个你已经有固定看法的问题去问它,然后感受它的回答带给你的心理反应。
- 如果它讲完后,你觉得"嗯,有道理,但这些我也想到了"——那它的认知只是一般,没有带你突破原有的理解框架。
- 如果它讲完后,你心里惊叹"对呀,我怎么没想到!",某个角度让你意识到"原来这件事还可以这么理解"——那它的认知就很高。
这种"让你跳出思维框架"的体验,在心理学上对应**"视角转换"(Perspective Shift)或"概念重构"(Reframing)**。这类高阶思维活动的发生机制在于:当新信息与既有认知框架产生张力时,大脑被迫重组原有的概念网络,形成更具包容性的新理解。
从神经科学层面看,这一过程涉及前额叶皮质(Prefrontal Cortex)对默认模式网络(Default Mode Network,DMN)的调控。默认模式网络在人处于"自动驾驶"状态时最为活跃,负责维持惯性思维模式;而当前额叶皮质接收到冲突性信息时,它会主动抑制默认模式网络的优势回路,迫使大脑进入更具灵活性的重评估状态——神经科学家将这一切换过程称为"认知控制"(Cognitive Control)。心理学家卡罗尔·德韦克(Carol Dweck)的成长型思维研究表明,真正的学习发生在已有认知被挑战、需要重新整合的时刻,而非信息简单累积的过程中。
对AI而言,能触发这种体验需要模型具备两种能力:一是对问题的多维度理解(而非单一路径推理),二是对用户潜在认知盲区的感知与针对性补充——具体而言,模型需要识别问题的"隐含预设"(Implicit Assumption)并提供反预设的视角,这需要超越字面语义的深层语用理解(Pragmatic Understanding)。以"努力工作就能成功"这一命题为例,能力一般的模型会在此预设框架内补充论据,而认知深度高的模型会先识别出这一命题隐含的"个人努力是决定性变量"的假设,再引入结构性机会、社会资本等反预设维度,从而重构问题本身。这也解释了为何许多高分模型在此标准上表现平平——基准测试倾向于评估模型"知道多少",而非"能带来多少认知增量",后者才是更高阶的智识能力。
真正认知深度强的大模型,能够重构你对问题的理解,而不只是复述你已知的内容。这也是拉开模型层次的关键分水岭。
标准四:解决问题能力——给方案还是给建议
最实用的标准:解决问题的能力,决定了模型能否系统性地帮你把一件事真正做成,而不是甩给你一堆零散的提醒。
如何检验
给它一个具体任务,比如"帮我做一个项目计划"或"帮我开一家网店"。观察它的回应方式。
能力强的大模型,不会一上来就直接抛答案,也不会只堆砌"要注意这个、注意那个"的碎片提示。它会先给你一个方法论——比如把问题拆成三步:定位、执行、复盘;然后逐步拆解每一步具体做什么、先做什么后做什么、可能遇到什么问题、该如何准备。
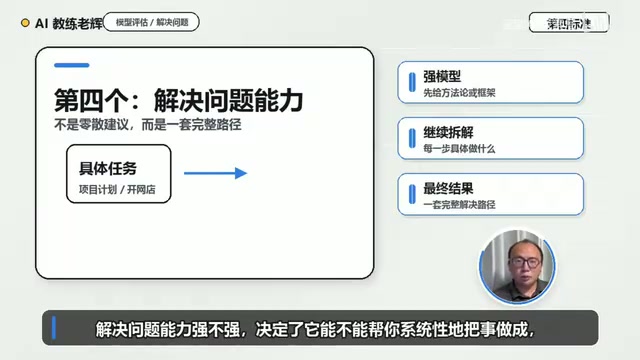
这一判断标准与管理咨询领域的"结构化思维"高度契合。MECE原则(Mutually Exclusive, Collectively Exhaustive,相互独立、完全穷尽) 由麦肯锡咨询顾问芭芭拉·明托(Barbara Minto)在其著作《金字塔原理》中系统阐述,是结构化问题解决的核心方法论。其要求将复杂问题分解为若干子问题,各子问题之间无重叠(相互独立),且所有子问题合并后能完整覆盖原问题(完全穷尽)。
在大模型的训练机制层面,这一能力的形成有其技术根源。在指令微调(Instruction Fine-Tuning,IFT) 阶段,模型通过大量"指令-回复"配对数据学习输出范式:如果训练数据中包含丰富的、遵循MECE结构的高质量问题解决案例,模型便会习得"先搭框架再填细节"的输出倾向;反之,若训练数据以碎片化问答为主,模型则倾向于给出零散的条目式回答。而在基于人类反馈的强化学习(RLHF) 阶段,标注人员对结构化回答的偏好评分会进一步强化这一行为模式。这解释了为何不同模型面对同一任务时,输出的结构化程度差异显著——这不仅是基础能力问题,更是训练数据质量与反馈信号设计共同作用的直接体现。值得注意的是,最优模型应能根据任务复杂度动态调整方案的颗粒度,而非千篇一律地套用固定框架——对简单问题强行套用三层结构反而是能力不足的表现。
这样的模型给你的是一整套完整的解决路径,而不是东一句西一句的零散建议。如果拿到的回答没有框架、没有方法论,只是碎片化提示,那它解决问题的能力就还不够。
评判AI的标准,正在变成评判人的标准
有意思的是,这四个标准不仅能用来判断AI,同样适用于判断一个人。
- 看一个人表达力强不强,就看你听完能不能讲给别人听,而别人也能懂;
- 看一个人洞察力强不强,就看他能不能在乱局中一句话点破关键;
- 看一个人认知深度高不高,就看他的话能不能让你重新思考;
- 看一个人解决问题能力强不强,就看他给的是建议还是一整套方案。
这背后反映了一个深刻的趋势:评判人与评判AI的标准,正在变得越来越一致。以前衡量一个人是否优秀,看的是考试分数;现在不同了,我们看的是他能否把复杂问题讲清楚、能否看到本质、能否引发思考、能否把事做成。
从更宏观的视角看,这种标准的趋同并非偶然。大语言模型的训练目标本质上是对人类高质量表达的模仿与提炼——研究人员筛选训练数据的标准,恰恰正是"这段文字是否体现了清晰表达、深度洞察、认知突破与系统解决"。换言之,我们在定义"好的AI"时,其实一直在定义"好的思考者"。这一标准的镜像效应提示我们:在AI能力快速演进的时代,真正稀缺的人类价值,恰恰是那些我们用来评判AI时感到"难以量化"的维度——不是信息储量,而是理解与传递信息的方式。
这既是大模型的标准,也是人的标准。 与其纠结于榜单上的数字,不如动手用这四把尺子亲测一番——毕竟,能真正帮到你的模型,才是好模型。
核心要点
- 跑分≠好用:主流基准测试存在测试集污染问题,静态题库催生记忆效应而非真实推理,动态基准(如LiveBench)是更可靠的替代方向。
- 表达力:用费曼测试法验证——模型讲完后,你能否向外行人转述且对方能听懂;这考验的是模型的心智理论与受众建模能力。
- 洞察力:观察模型能否一句话点破核心,并通过多模型交叉验证(Multi-Judge Ensemble)降低单一AI评判的系统性偏差。
- 认知深度:以"你已有固定看法的问题"为探针,感受模型是否能识别隐含预设并提供反预设视角,触发真正的概念重构。
- 解决问题能力:判断模型给出的是遵循MECE原则的完整方法论路径,还是碎片化的零散提示——这一能力差异根植于模型训练数据质量与RLHF反馈设计。
- 标准的镜像效应:评判好AI的四个维度,本质上也是评判优秀思考者的维度,揭示了AI时代真正稀缺的人类认知价值所在。
相关推荐

OpenAI安全负责人信任危机:Tomek Korbak事件引发关注
OpenAI安全负责人被曝向研究人员Tomek Korbak表示"不再信任",这则Hacker News消息引发对AI实验室内部安全治理与信任机制的讨论。本文基于有限信息进行背景梳理与审慎分析。

381个AI Agent项目全景图谱:按用途分类的生态导航
一份收录381个AI Agent项目与服务的开源Roadmap,按主要用途而非GitHub热度分类,帮助开发者快速导航碎片化的智能体生态、完成技术选型并参与社区贡献。

OpenAI新模型震动数学界:从辅助工具到研究伙伴的转变
OpenAI最新模型据报在数学领域展现惊人推理能力,引发研究者"叹为观止"与"毁灭性"的两极反应。本文分析AI对数学研究范式、数学家角色的深层冲击与理性看待的视角。