Paperless-AI:用大模型给文档自动打标签的开源利器
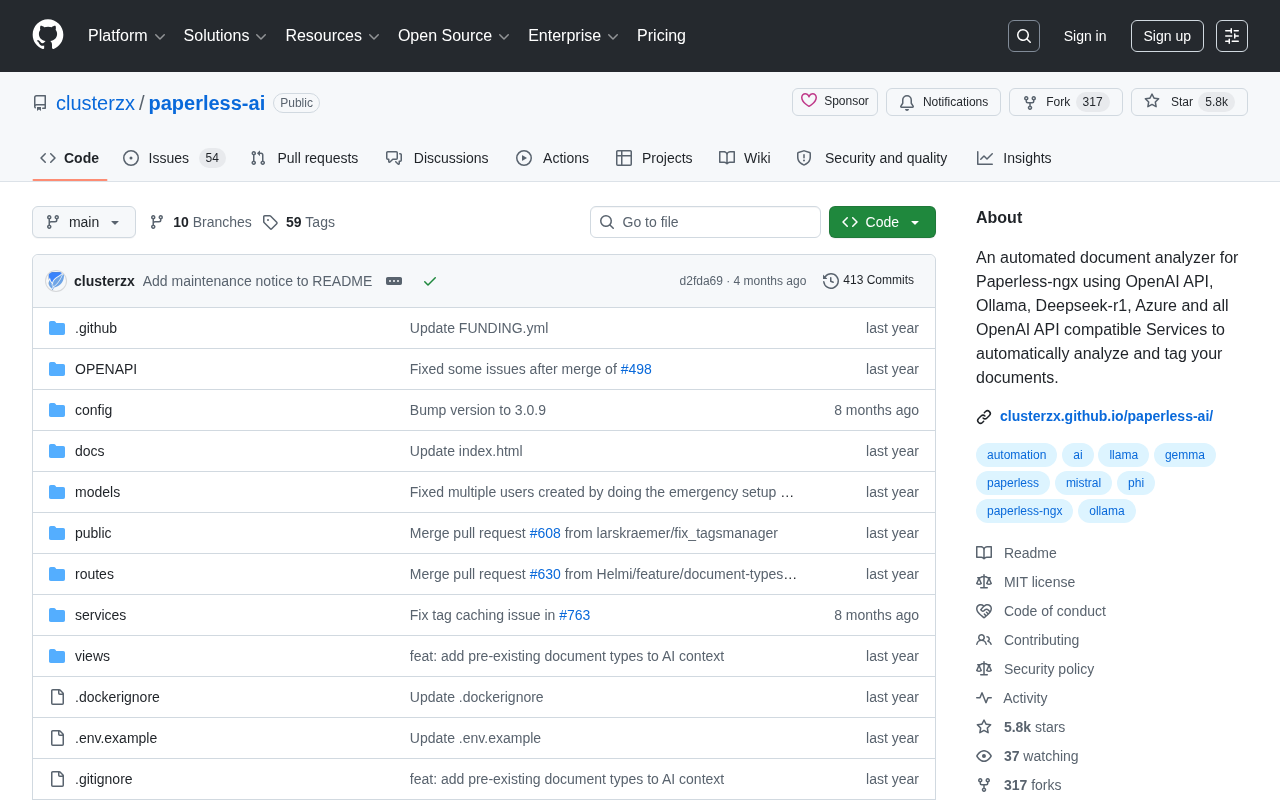
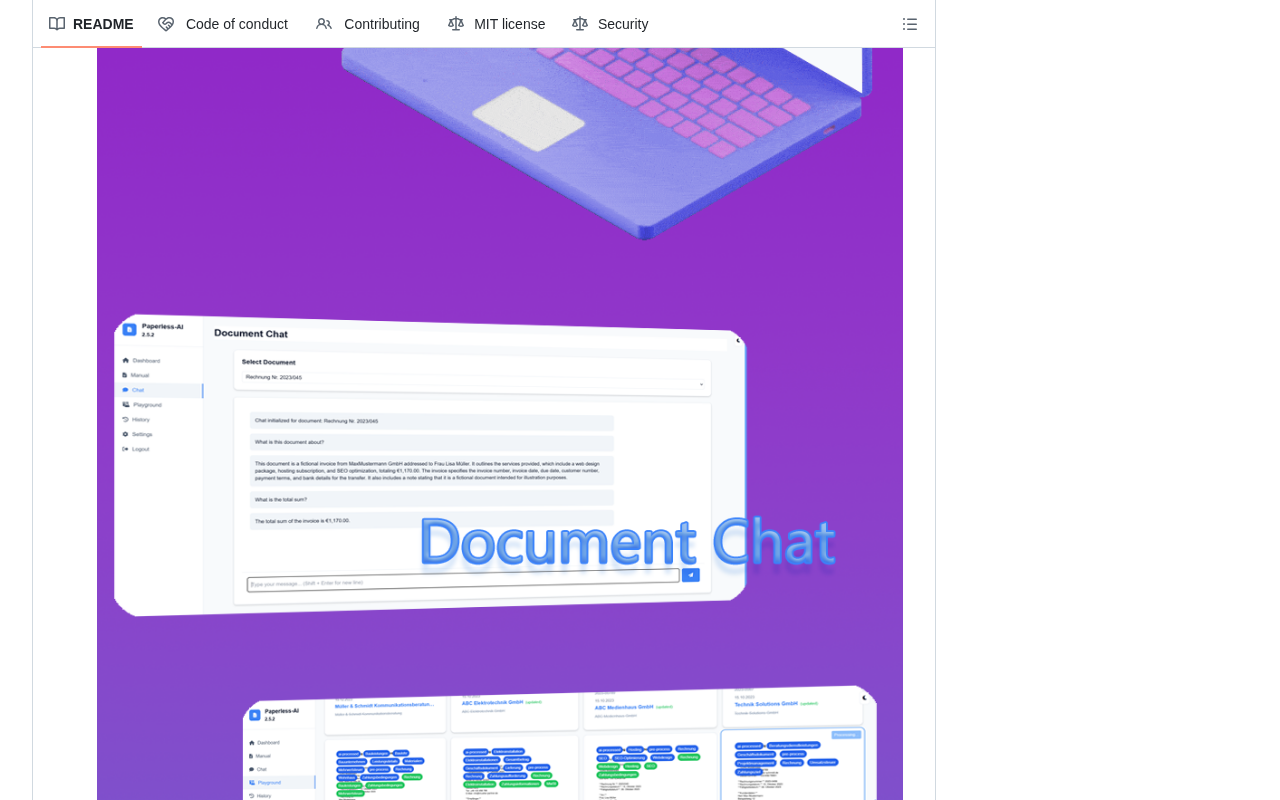
Paperless-AI 为 Paperless-ngx 接入大语言模型,实现文档自动分类与打标签。
Paperless-AI 是一个开源项目,专为 Paperless-ngx 无纸化文档管理系统补齐"智能理解"能力。它将新入库文档的内容交由大语言模型分析,自动判断分类、标签与往来对象并回写到 Paperless-ngx,彻底取代繁琐的手动规则维护。项目支持 OpenAI、Ollama(本地部署)、Deepseek-r1、Azure OpenAI 及所有兼容 OpenAI API 的第三方服务,用户可在隐私、成本与精度之间灵活权衡。部署采用 Docker 容器方式,适合家庭及小型办公室处理银行账单、发票、医疗单据等混杂文档,并可批量补全历史文件元数据。项目在 GitHub 已获逾 5600 Star,印证了"AI 整合既有工作流"这一方向的真实需求。
Paperless-AI:给文档管理装上 AI 大脑
对于长期使用 Paperless-ngx 做无纸化文档管理的用户来说,最头疼的往往不是扫描存档,而是给成百上千份文件手动分类、打标签、填写元数据。clusterzx/paperless-ai 这个开源项目正是为了解决这个痛点而生——它借助大语言模型,为 Paperless-ngx 提供全自动的文档分析与标记能力。目前该项目在 GitHub 上已收获超过 5600 颗 Star、300 多次 Fork,主力语言为 JavaScript。
它解决了什么问题
Paperless-ngx 本身是一套成熟的文档数字化归档系统,能够 OCR 识别、全文检索并存储 PDF 及扫描件。但它的分类逻辑主要依赖规则匹配和用户手动配置。当文档数量增长到一定规模,靠人力维护标签体系几乎不可持续。
Paperless-AI 的思路是把每一份新入库的文档内容交给大语言模型去"读懂",再由模型判断该文档应归属哪个分类、匹配哪些标签、对应哪位往来对象(correspondent),并自动回填到 Paperless-ngx 中。这种基于语义理解的自动化,相比传统的关键词规则更加灵活,尤其适合内容多样、格式不统一的真实文档场景。
支持的模型与后端
该项目最大的亮点之一是对多种 AI 服务的广泛兼容。根据项目描述,它支持:
- OpenAI API:直接调用 GPT 系列模型进行分析;
- Ollama:在本地运行开源模型,数据无需出本地网络,兼顾隐私;
- Deepseek广告-r1:接入具备推理能力的国产模型;
- Azure OpenAI:面向企业级部署的微软托管方案;
- 所有兼容 OpenAI API 的第三方服务:这意味着大量中转服务、自建推理端点都能无缝接入。
这种"广谱兼容"的设计非常务实。注重隐私的个人用户可以选择 Ollama 在本地跑模型,避免把敏感文档内容发送到云端;追求效果的用户则可以直接用 OpenAI 或 Deepseek 的高性能模型;而企业用户能通过 Azure 满足合规要求。用户可以根据成本、隐私和精度的权衡自由取舍。
典型使用场景
设想一个家庭或小型办公室的文档库:银行对账单、水电账单、保险合同、发票、医疗单据混杂在一起。传统做法需要为每类文件预先写好匹配规则,一旦格式变化就可能失效。
接入 Paperless-AI 后,系统能自动读取文档正文,识别出"这是一张 X 公司的电费账单",随即打上「水电费」「X 公司」等标签并归入相应分类。对于长期积累的历史文档,它同样可以批量重新分析,一次性补全缺失的元数据。这大幅降低了无纸化归档的维护门槛。
部署与技术考量
作为一个基于 JavaScript 的项目,Paperless-AI 通常以 Docker 容器方式部署,与 Paperless-ngx 实例配合运行。使用者需要准备好对应 AI 服务的 API 密钥(或本地 Ollama 环境),并配置好与 Paperless-ngx 的对接参数。
在实际落地时,有几点值得权衡。一是成本控制:若文档量大且使用商业 API,Token 消耗会累积成一笔可观支出,本地模型虽免费但对硬件有要求。二是隐私边界:把文档内容发给云端模型意味着数据离开本地,涉及敏感资料时应优先考虑 Ollama 等本地方案。三是准确性:大模型的分类判断并非百分百可靠,建议保留人工复核环节,尤其在关键财务、法律文档上。
小结
Paperless-AI 是开源社区将大语言模型能力嫁接到实用工具上的一个典型案例。它没有重新发明轮子,而是巧妙地在成熟的 Paperless-ngx 之上补齐了"智能理解"这块短板。对于饱受手动整理之苦的重度文档用户,它提供了一条低成本、可自托管、模型可自选的自动化路径。超过 5600 的 Star 数也印证了这类"AI + 现有工作流"整合工具的真实需求。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。