Parakeet Redux:178MB语音模型压缩背后的开源陷阱

Parakeet Redux将语音模型从1.2GB压缩至178MB,但开放权重背后藏着闭源引擎的隐患。
Moondream 团队基于 NVIDIA 的 Parakeet 0.6B v3,通过将编码器权重极端压缩为三值(-1/0/+1),将模型体积从1.2GB缩至178MB,英语识别准确率几乎不受影响,多语言和长音频表现甚至有所提升。178MB 的体积意味着模型可打包进 App、跑在 CPU 上,CPU 速度约为同类开源方案的3倍,但在 Mac GPU 上优势基本消失,宣传中的113倍实时需要企业级 AMD 服务器才能实现。真正值得警惕的是开源陷阱:权重采用 CC 协议开放,但驱动其运行的引擎 Photon 闭源,附带许可证措辞模糊的 Kestrel Kernels,且 Photon 曾为付费产品。文章最终指出,本地 AI 的下一场竞争将不在于谁开放权重,而在于谁掌控底层运行时。
一个原本1.2GB的语音转文字模型,被压缩到仅178MB,体积缩小约七分之一,而英语识别准确率几乎没有下降,多语言表现甚至还变好了。这听起来像是魔法,但背后既有真正的技术突破,也藏着一个值得警惕的开源陷阱。
把权重压成三个值的极端做法
这个模型叫 Parakeet Redux,来自 Moondream 团队。它基于 NVIDIA 的 Parakeet 0.6B v3——本身已经是目前最好的开源语音模型之一。Moondream 在此基础上做了一件相当激进的事情:把编码器里的每一个权重都强制压缩成三个值之一——-1、0、+1。
可以把每个权重想象成一个精密的音量旋钮。正常情况下,这个旋钮可以调到无数个位置;而三值化(ternary)相当于把旋钮直接拔掉,换成一个只有三挡的拨杆。你丢掉了大量精度,换来的是模型体积坍缩到原来的约七分之一。
按常理,精度崩了准确率也应该跟着崩,但这里并没有。英语词错率(WER)从 6.26 升到 6.55,确实变差了,但幅度极小。更反直觉的是,多语言得分从 11.62 改善到 10.56,长音频从 2.71 改善到 2.51——这两项反而变好了。模型支持 25 种欧洲语言,并且能自动检测语种。
三值量化(Ternary Quantization)是模型压缩领域的一种极端手段。主流的量化方案通常是将32位浮点权重降到8位(INT8)或4位(INT4),每个权重依然能表示数百乃至数十亿个不同数值。而三值化则更进一步,把所有权重只映射到 -1、0、+1 三个离散值,理论上每个权重仅需约1.58位来存储(log₂3 ≈ 1.58),这也是"1.58-bit 模型"这一说法的由来。压缩比如此之高的代价,通常是精度损失——大量细粒度的调节信息被抹平。三值化之所以在这里奏效,部分原因在于 Parakeet 原始模型是在海量数据上充分训练的,其权重分布已经相对集中;加之 Moondream 对编码器(负责将音频转为特征向量的部分)而非解码器动刀,保留了语言建模侧的精度。这种"只量化编码器"的策略是理解为何准确率损失如此小的关键背景。
178MB意味着什么
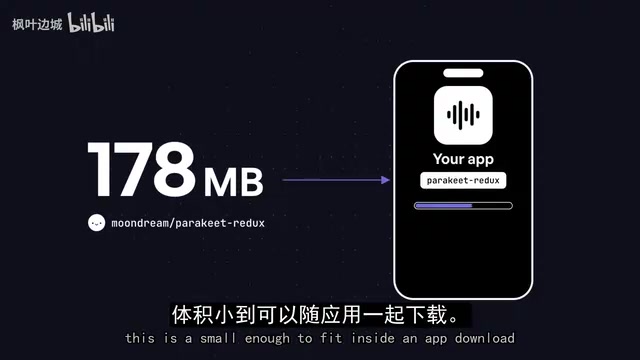
178MB 这个数字的意义,远不止省硬盘空间。它小到可以直接打包进一个 App 的安装包里,也能在老旧的笔记本上运行。更关键的是,它可以跑在 CPU 上,从而把 GPU 腾出来给本地大语言模型这类任务。
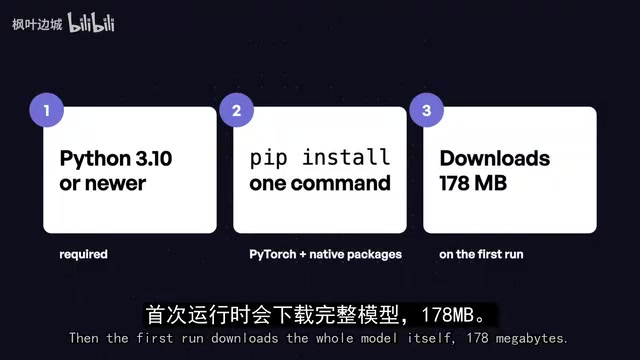
实际使用上,一个 pip install 加几行 Python 代码就能跑起来。磁盘上,Parakeet Redux 占 178MB,而对比的 Whisper Large V3 Turbo(Whisper CPP 版本)要 1.6GB。API 设计也相当友好:支持无时间戳、分段时间戳、词级时间戳三种输出;接受 WAV、MP3、FLAC、M4A 以及原始字节流;还能只截取长录音中指定起止时间的片段。
针对实时音频,它提供异步模式,可以直接从麦克风读取音频块,大约几秒后给出首个预览,之后每两秒刷新一次。不过这里有个小坑:每次流式更新都会替换上一次结果,如果你直接把每次结果追加打印,就会反复打印同一句话。
速度数字要分机器看
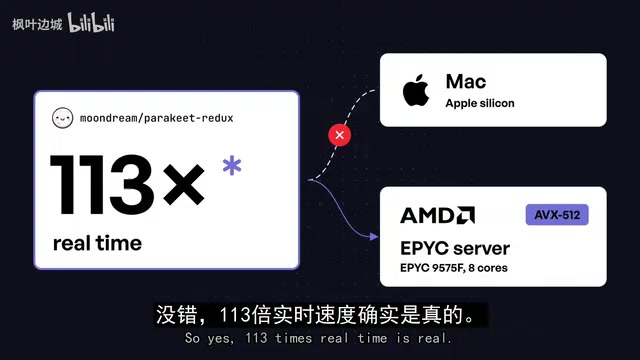
速度是这个模型的卖点,但数字必须结合硬件来看。在 Moondream 官方的 M2 MacBook Air 测试中(CPU 运行),Redux 达到 38 倍实时速度,而流行的开源运行时 Parakeet CPP 只有 12 倍——按官方数据,这是约 3 倍的领先。
但一旦切换到 Mac 的 GPU,这个优势基本消失:Redux 做到 43 倍,其他方案也在 38、39 倍左右,几乎打平。至于那个爆款标题里的「113 倍实时」,还有一个细节:那不是在 Mac 上测的,而是在一台带 AVX512 的 AMD EPYC 服务器上。所以 113 倍是真的,只是大概率不是你手头的那台机器。
横向对比也各有取舍。相比原版 Parakeet,Redux 小约七倍,还内置了语音检测器,能把音频切成小于 30 秒的片段。相比 Apache 协议的 Parakeet Mix,GPU 性能接近(43 对 37)。相比 Whisper,差异更明显:Whisper 支持约 99 种语言,Redux 只支持 25 种且全是欧洲语言,但 Redux 能直接从实时麦克风流式转写,并随着听到更多内容不断修正文本。
真正的理由不是省钱,而是隐私
一个值得停下来思考的问题是:为什么要在本地跑语音转文字?
很多人下意识认为是省钱,但这其实是个误解。云端 API 已经相当便宜——Deepgram 的 Nova 3 大约每分钟 0.4 美分,OpenAI 的 mini-transcribe 约 0.3 美分,一小时音频也就几分钱。如果只是为了省 API 费用而转向本地,这反而不是最有力的理由。
真正的价值在于隐私:离线工作,不依赖网络连接。这才是本地转录的核心意义所在。
开源权重,闭源引擎
技术很惊艳,但这里藏着一个真正的陷阱。模型权重确实是开放的,采用 Creative Commons 协议——但驱动它们运行的引擎 Photon 并不开源。
当你 pip install 时,会一并拉进一个叫 Kestrel Kernels 的包。它的许可证原文写道:如果你没有签订某项协议,你就没有使用该软件的授权。它可以免费下载,但那份「协议」具体意味着什么,并不清楚。
更微妙的是,Photon 今天免费,但在 6 月之前是付费的;Moondream 还在卖基于云的 Photon 版本,团队云端套餐规划在每月约 350 美元。于是你得到的,是「开放权重跑在一家条款已经变过一次的公司的闭源引擎里」。该如何对待这种局面,没有标准答案,只能说要小心。
另一个要注意的坑是噪声。在噪声音频基准上,错误率从 6.72 跳到约 9,差了约三分之一。模型卡本身也承认,Redux 更容易把音频替换成发音相近的词。
这里涉及一个在本地 AI 生态中越来越普遍的分层开放模式:权重(Weights)与运行时(Runtime)的分离。权重是模型学到的参数,决定模型"能做什么";运行时则是把权重加载进内存、执行矩阵运算的底层引擎,决定模型"能跑多快、跑在哪里"。开放权重意味着你可以查看、分发、甚至在另一个运行时上运行这些参数;但如果运行时闭源,你实际上依然被绑定在特定厂商的技术栈上。这与 Meta 开放 LLaMA 权重但社区随后构建了 llama.cpp 等独立运行时的路径不同——Parakeet Redux 的高性能目前深度依赖 Photon,而社区尚未有成熟的替代实现。Creative Commons 协议保护的只是权重文件本身,并不覆盖用于高效运行它的内核代码,这正是文章结尾所指"谁掌控底层运行时"这场博弈的具体体现。
该不该用它
如果你用的是纯 CPU 机器、老旧笔记本,或者在做一个对每一兆字节都斤斤计较的 App,那这个模型值得一试:按官方数据,CPU 上比 Parakeet CPP 快约 3 倍,体积约为原模型的七分之一。装上、在自己的硬件上跑一跑。
但如果你用的是 M 系列 Mac 且已经在用 GPU,开源运行时能给你基本相同的速度,还附带一份你真正能看懂的许可证。如果你要处理噪声较多的音频,还是老老实实用原版。
Parakeet 的 1.58-bit 模型,从研究论文一步跨到了 pip install,这件事本身很了不起——一个曾经 1.2GB 的模型如今能缩到约 178MB,还保住了大部分准确率。
但 Parakeet Redux 也暴露了一个新问题:开放权重并不自动等于开放技术栈。本地 AI 的下一场较量,恐怕不会围绕谁发布模型权重,而是围绕谁掌控底层的运行时。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。