PCIe 4.0 x8/x8 会拖慢双卡本地大模型推理吗?

PCIe 4.0 x8/x8 对双卡 70B 本地推理影响有限,吞吐仅损失 3%–6%。
文章用一个反直觉的结论驳斥了双卡工作站必须上 x16/x16 的迷思。作者指出,在 vLLM 或 llama.cpp 的张量并行(TP=2)模式下,自回归解码的真正瓶颈是 GPU 显存带宽(936–1008 GB/s),而非 PCIe 总线带宽。张量并行只跨总线传输中间激活张量,每 token 每层仅 32–64 KB,80 层合计不过几 MB,x8 的 15.75 GB/s 链路也能在 0.3 毫秒内完成。真正的挑战是每层两次 AllReduce 带来的同步延迟,batch size = 1 时延迟主导,x8 与 x16 差别不大。只有当 batch 扩展到 16 以上做企业级服务时,x8 才会饱和。文章还对比了流水并行、芯片组 x4 陷阱、NVLink 与各种主板平台,最终建议把预算投入更强的 GPU 或云算力,而非昂贵的工作站主板。
结论先行:x8/x8 并不严重拖慢本地推理
很多双卡工作站的搭建者愿意多花几千美元,只为让两张 GPU 跑在纯 x16/x16 的服务器主板上,默认把 PCIe 通道砍半就等于 token 吞吐砍半。这个假设忽略了 Transformer 的实际工作机制。
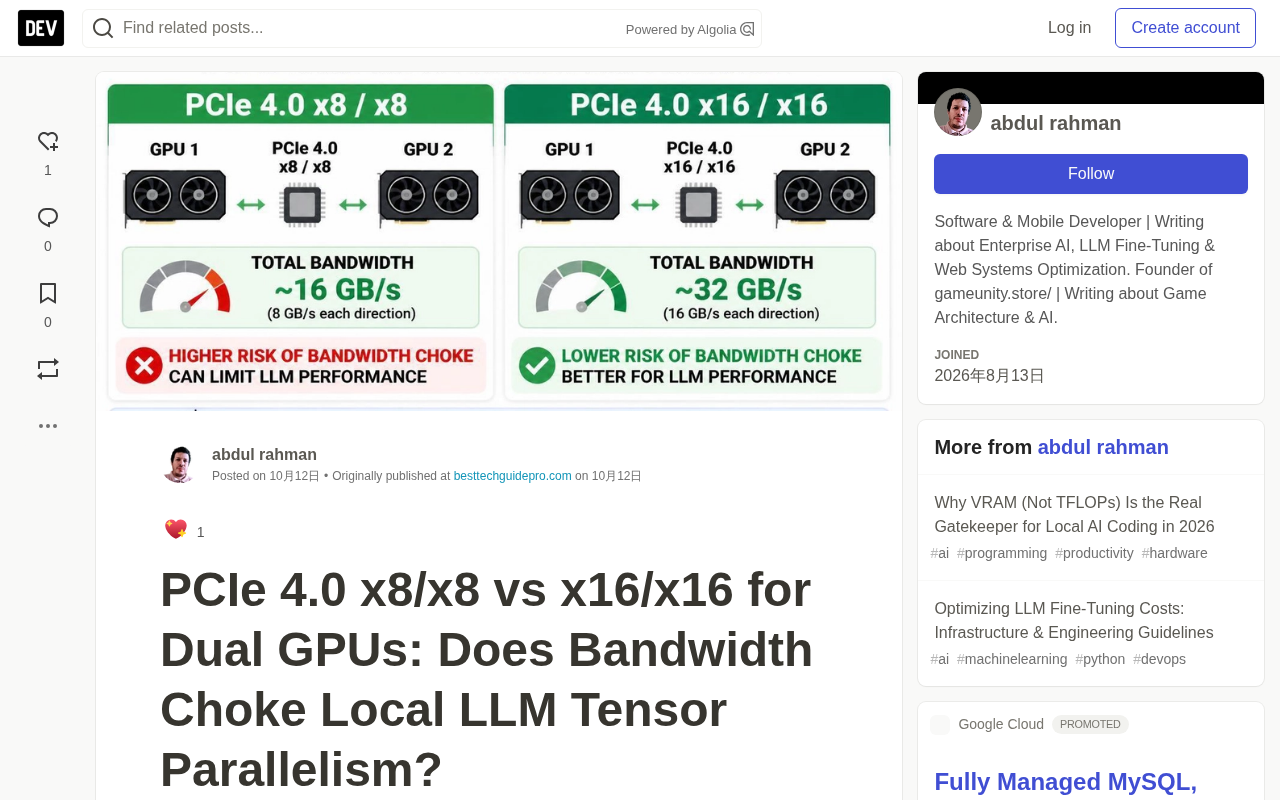
在 vLLM 或 llama.cpp 这类引擎的 Tensor Parallel(张量并行,TP=2)模式下,PCIe 4.0 x8/x8 并不会显著卡住单流 token 生成。PCIe 4.0 x16 单向带宽约 31.5 GB/s,x8 约 15.75 GB/s;但自回归解码的真正瓶颈在 GPU 显存带宽(936–1008 GB/s),而不是总线。实测 70B 模型跨双卡的 x8/x8 相比 x16/x16,吞吐损失通常在 3%–6% 之间。只有在高并发 batch 服务或超长 prompt 的 prefill 阶段,x8 拆分才会带来可测量的 NCCL AllReduce 延迟开销。
张量并行到底传了什么
一个常见误解,是认为跑本地大模型时 GPU 在 PCIe 上不停搬运几十 GB 的模型权重。事实并非如此。
在张量并行模式下,模型权重在推理开始前就已经分片存放在各自的显存里,常驻本地。真正跨总线传输的只有前向传播中的中间激活张量,而非权重。
以隐藏维度 8192 的 70B 模型、batch size = 1 为例,每生成一个 token、每层大约只传输 32 到 64 KB 的激活数据。80 层加起来,单 token 穿越 PCIe 的总数据量只有几 MB。把 5 MB 数据放在 15.75 GB/s 的链路上传,耗时不到 0.3 毫秒——远低于人类感知阈值,和 x16 几乎没有区别。
张量并行(Tensor Parallelism) 的核心思想是把单个 Transformer 层内部的权重矩阵按维度切开,分给不同 GPU 各自计算一部分,再通过集合通信把部分结果拼合。以 Megatron-LM 提出的经典方案为例,多头注意力中的 Q/K/V 投影按注意力头切分,MLP 的两层线性层则按列/行交替切分,这样每张卡只持有约一半权重,显存占用近乎减半。代价是每一层的前向传播都要插入 AllReduce 或 AllGather 之类的同步操作,让两张卡的结果对齐后再进入下一层。因此张量并行的通信频率与模型层数成正比,对跨卡通信的延迟敏感度远高于流水并行。这正是理解全文的关键:TP 的瓶颈从来不是单次传输的数据量,而是同步次数乘以每次同步的固有延迟。
真正的瓶颈是同步延迟,不是带宽
激活数据量小,但多卡推理的真正挑战在于同步。张量并行每层需要两次 AllReduce 操作。
按 NVIDIA NCCL 文档,消费级多卡拓扑上的集合通信包含:两个 GPU 上的 kernel 启动开销、PCIe root complex 的数据包穿越延迟(约 1.5–2.5 微秒),以及 CUDA 同步屏障。
在 batch size = 1 的小消息交换场景下,主导因素是延迟而不是带宽,所以 x16 相对 x8 并不能显著降低延迟。两者都要经历同样的 root complex 交换延迟。
AllReduce 是集合通信中的一种原语,作用是把所有参与 GPU 上的张量逐元素求和后,把结果广播回每一张卡。在张量并行里,它出现在注意力和 MLP 各自的反向拼接点,因此层数越多、调用越密。AllReduce 的性能由两个量刻画:一是算法带宽(algbw),反映大消息下的有效吞吐;二是总线带宽(busbw),乘以拓扑因子后用于跨硬件比较。当消息小于某个阈值(通常几十到几百 KB)时,通信进入延迟主导区,此时带宽几乎无关,性能由 kernel 启动、PCIe 链路握手和同步屏障决定。NCCL 在 PCIe-only 拓扑下采用 Ring 或 Tree 算法,小消息场景往往选择 Tree 以降低跳数。理解延迟主导区,就能明白为什么 x8 与 x16 在 batch size = 1 时表现接近。
流水并行 vs 张量并行:什么时候总线速度才重要
跨多卡扩展本地大模型时,有两种架构选择,对 PCIe 的敏感度完全不同。
流水并行(PP):第 1–40 层放 GPU 0,第 41–80 层放 GPU 1,每个 token 只在边界层跨一次 PCIe。它对通道带宽几乎完全免疫,x8/x8 甚至 x4 都能跑;代价是两张卡互相等待,产生空闲气泡。
张量并行(TP):两张卡同时对每一层做计算,没有空闲气泡,单 token 延迟减半,但每个 token 需要 160 次 AllReduce 同步。如果 batch size 扩展到 16 以上做企业级服务,x8 链路最终会饱和。
主板通道税:从 B650 到 TRX50
消费级桌面 CPU 只提供 16–24 条专属 PCIe 通道,双卡配置大致分三类。
消费级拆分(x8/x8):华硕 ProArt X670E-Creator、微星 MEG Z790 ACE 等主板把 CPU 的 16 条通道拆成两个 x8 插槽,两张卡都直连 CPU、延迟最低。整套主板成本约 450–600 美元。
预算陷阱(x16 CPU / x4 芯片组):便宜的 B650 或 Z790 让第一张卡走 CPU(x16),第二张卡走主板芯片组(x4)。这种配置应完全避免——芯片组路由会引入严重 DMI 总线延迟,张量并行速度下降超过 35%。
高端工作站(真 x16/x16):AMD Threadripper 7000(TRX50)或 Intel Xeon W 提供 48–112 条专属通道,双卡满速 x16/x16。整套平台成本约 2500–4500 美元。
为了双卡 x16/x16 专门上 Threadripper,是一笔资本配置效率很低的投入。那 2500 美元的溢价,花在更高一级的 GPU、更快显存或云算力上更划算。
CPU 直连通道与芯片组通道的区别是选板时最容易被忽视的坑。现代消费级 CPU(如 AM5 的 Ryzen 7000/9000、LGA1700 的 Core)只提供 20–28 条 PCIe 通道,其中 16 条专门留给显卡插槽。当主板声称支持双卡时,通常有两条路径:一是把 CPU 的 16 条拆成 x8/x8,两张卡都直连 CPU;二是让第一张卡独占 x16,第二张卡挂在芯片组(如 AMD Promontory、Intel PCH)下面,通过 DMI 或类似链路回连 CPU。芯片组下行链路带宽通常只有 PCIe 4.0 x4 的水平,且要与其他外设共享。这就是为什么 x16 / x4 的芯片组路由在张量并行下会断崖式下跌——它既带宽不足,又叠加了额外的 DMI 转发延迟。选购双卡主板时,务必确认第二条插槽的通道来源是 CPU 而非芯片组。
NVLink 桥接:双 3090 为何胜过双 4090
讨论双卡互联带宽,绕不开 NVLink Bridge。
RTX 3090 是最后一张带物理 NVLink 接口的消费卡。两张 3090 加桥接后,可获得 112.5 GB/s 双向带宽——是 PCIe 4.0 x8 的七倍多、x16 的接近四倍。
NVIDIA 有意在 RTX 4090 上取消了 NVLink,以保护数据中心产品的利润空间。结果两张 4090 只能走 PCIe。虽然 4090 的 FP8 算力更强,但在张量并行推理中,带 NVLink 桥的双 3090 集合通信开销更低。
NVLink 是 NVIDIA 的点对点高带宽互连总线,独立于 PCIe 之外,允许 GPU 之间直接读写对方显存,并支持硬件层面的原子操作与内存一致性。在 Ampere 消费级卡上,NVLink 3.0 每条链路提供约 14.0625 GB/s 单向带宽(双向合计约 28 GB/s),RTX 3090 支持双链路桥接,因此得到约 56 GB/s 单向、112.5 GB/s 双向的聚合带宽。除了带宽更高,NVLink 的另一个优势是延迟更低、无需经过 PCIe root complex,这对小消息的 AllReduce 收益明显。NVIDIA 在 Ada 架构的 RTX 40 系列上彻底移除了 NVLink,理由官方表述为消费级需求不足,但业界普遍认为这与数据中心 A100/H100 的产品分层策略有关。因此二手双 3090 加 NVLink 桥在小规模多卡推理场景中,仍是一个性价比极高的组合。
互联架构对比矩阵
| 总线拓扑 | 单向带宽 | 典型平台 | 70B TP=2 相对速度 | 工程结论 |
|---|---|---|---|---|
| PCIe 4.0 x8 / x8 | 15.75 GB/s | AM5 / Z790 拆分 | 比 x16/x16 慢 3.9% | 单机编码者的最佳性价比 |
| PCIe 4.0 x16 / x16 | 31.5 GB/s | Threadripper / Xeon W | 基准(100%) | 优秀,但主板税高 |
| PCIe 4.0 x16 / x4(芯片组) | 约 3.9 GB/s | 廉价 B650 / 低端 Z790 | 慢 34.5% | 张量并行必须避开 |
| 双 3090 + NVLink 桥 | 56.25 GB/s | 任意双卡板 | 比 x16 快 6.2% | DIY 黄金方案 |
| PCIe 5.0 x8 / x8 | 31.5 GB/s | 次世代主板 | 等同 PCIe 4.0 x16 | 面向未来的标准 |
常见技术问题
PCIe 4.0 x8/x8 会卡住双卡本地大模型推理吗? 单流 token 生成(batch size = 1)不会显著受限。x8/x8 与 x16/x16 的吞吐差距通常在 3%–5% 以内,因为生成主要受 GPU 显存带宽(936–1008 GB/s)约束,而非 PCIe。
x8 和 x16 的带宽差多少? PCIe 4.0 x16 单向理论带宽约 31.5 GB/s(双向 63 GB/s),拆分成 x8 后单向链路上限正好减半,约 15.75 GB/s。
双卡张量并行必须用 NVLink 吗? 不是。现代引擎如 vLLM 支持通过标准 PCIe 的 P2P DMA 做张量并行。但双 3090 加 NVLink 桥可提供 112.5 GB/s 双向带宽,几乎消除跨卡同步延迟。
为 x16/x16 买昂贵工作站主板值吗? 对 70B 本地推理来说,不值。从 x8/x8 消费级主板升级到昂贵的 Threadripper 平台,成本数千美元,token 生成速度提升却不到 5%。
完整的测试方法、NCCL telemetry 与拓扑数据发布在 CERN Zenodo(DOI: 10.5281/zenodo.22641931),全部结论来自 vLLM 与 llama.cpp 环境的实际硬件测试。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。