PDF朗读工具新解:读懂公式、图表与双栏论文的AI语音

专为学术论文设计的PDF语音阅读工具,主打公式语义朗读和双栏排版识别。
Accurate PDF Narration 是一款针对学术论文和技术书籍的垂直TTS工具,直击传统文字转语音在复杂文档场景的三大痛点:双栏排版导致的朗读顺序混乱、数学公式被逐字符念成噪音、以及页码和引用标记打断连贯性。产品的核心差异化在于「按意义朗读」公式与代码,并提供图表解释和逐词高亮同步功能,每月提供500页免费额度。目前该产品仍处于 Product Hunt 早期阶段,市场验证有限,其声称的核心能力实际效果有待用户以真实学术文档检验。从更宏观的视角看,它代表了AI TTS从「能读」向「读得懂」演进的趋势,是文档理解与语音合成结合的一种典型产品形态。
让PDF「开口说话」的技术难点
把一份PDF转成语音听起来简单——不就是文字转语音(TTS)吗?但真正用过的人都知道,学术论文和技术书籍是TTS工具的「重灾区」。双栏排版会让朗读顺序错乱,把左右两栏的文字混着读;数学公式被逐字符念出来变成一堆无意义的符号;图表、页码和引用标记则会打断阅读的连贯性。
一款名为 Accurate PDF Narration 的产品登陆 Product Hunt,正是瞄准了这些「硬骨头」场景。它的定位不是通用的文档朗读器,而是专门为研究论文和书籍这类结构复杂的文档设计的语音阅读工具。
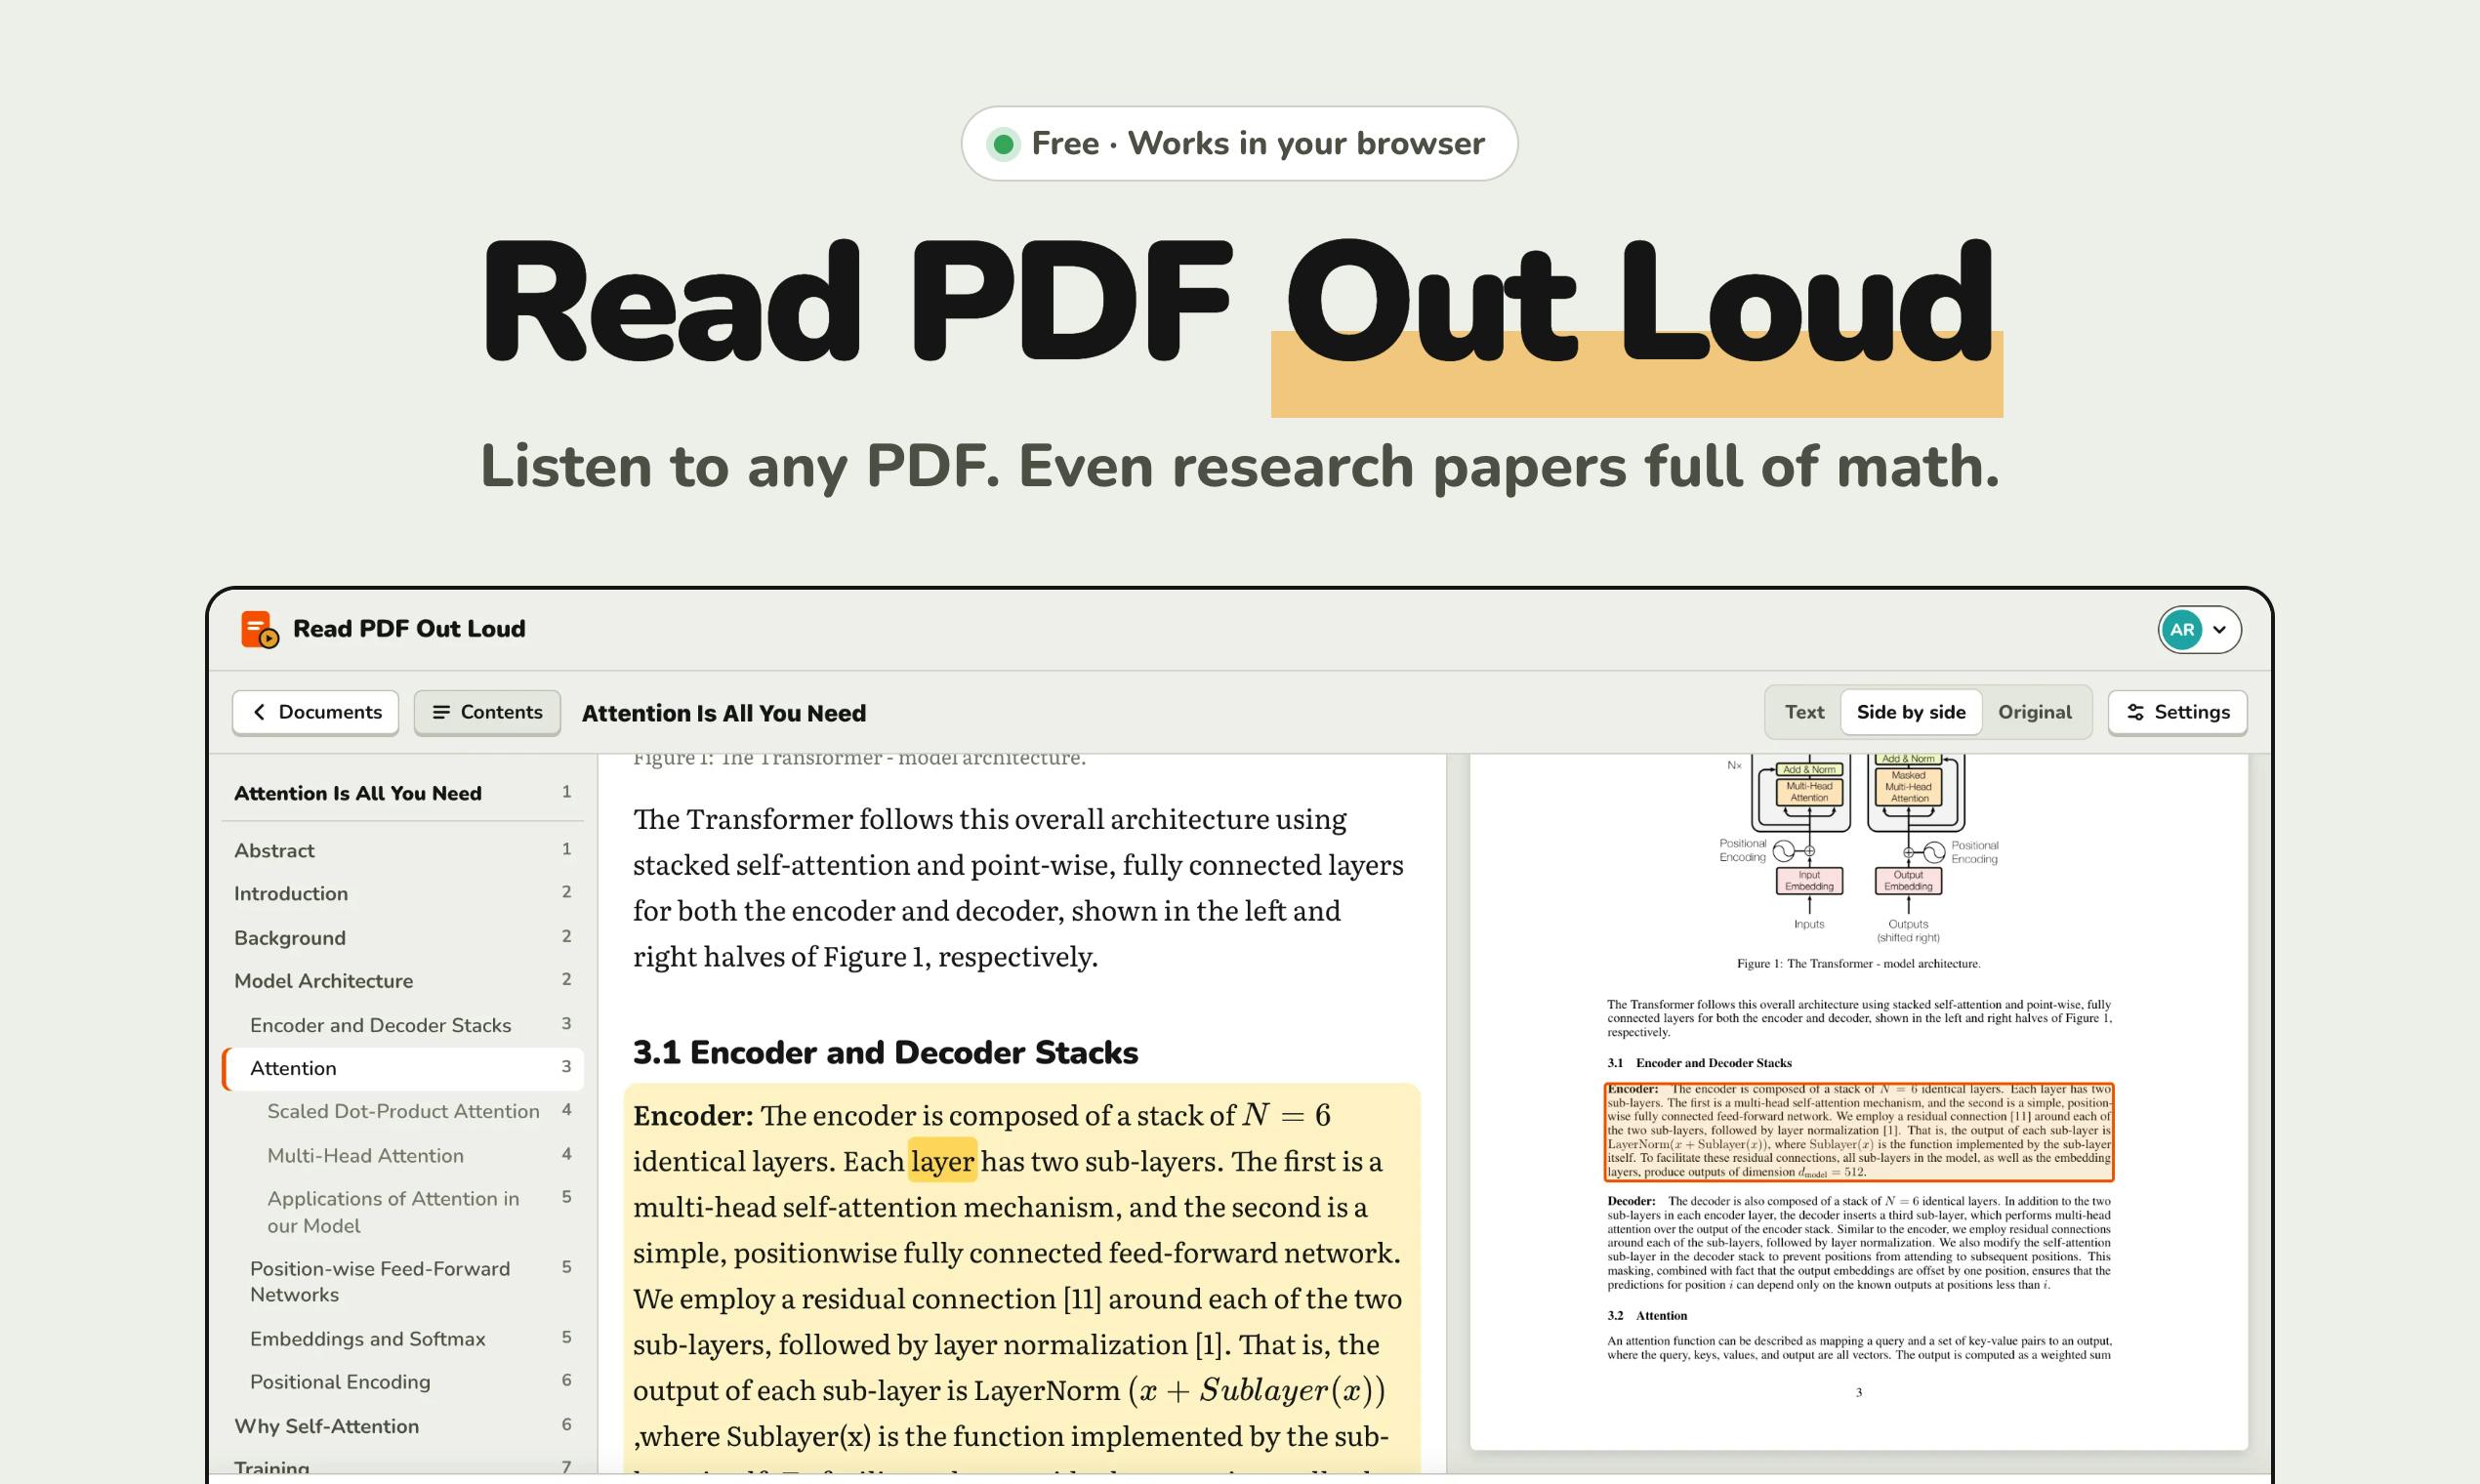
核心能力:按「意义」而非「字符」朗读
根据产品官方描述,它的几项核心功能直接对应了传统TTS的痛点:
双栏论文按正确顺序阅读
学术论文常见的两栏排版是最容易出错的地方。普通阅读器往往按行扫描,导致左栏一句、右栏一句地交替朗读,内容完全无法理解。该工具声称能识别版面结构,按人类阅读的自然顺序处理双栏内容。
公式和代码「按意义」朗读
这是最见功力的一点。数学公式如果逐字符念,∫f(x)dx 会变成一串符号噪音。产品强调「equations and code read by meaning」——即把公式和代码块转化为可理解的口语表达,而非机械地念符号。对于经常需要「听」论文的研究者来说,这个能力的实际效果将直接决定产品价值。
实现「按意义朗读」公式,技术上通常依赖两个环节:首先是公式识别,将PDF中的数学符号解析为结构化的中间表示(如LaTeX或MathML),这一步本身就对PDF解析能力要求极高,因为学术论文中的公式往往是嵌入式图像或非标准编码;其次是语义转换,将结构化公式翻译成自然语言口语表达,例如把 ∫₀¹f(x)dx 转换为「f(x)从0到1的定积分」。传统规则系统在处理复杂嵌套公式时容易失败,而大语言模型在理解公式语义并生成流畅口语描述方面具有天然优势。代码块的处理逻辑类似——直接逐字符朗读会产生大量标点和缩进干扰,更好的做法是解释代码的功能意图。这也是该产品最核心、最难验证的技术声明。
图表解释与噪音过滤
工具会对图表(figures and tables)进行解释说明,同时自动跳过页码和引用标记(citations)。这些元素在朗读时本是干扰项,跳过它们能显著提升听感的连贯性。
此外,产品还提供了逐词高亮(every word lights up)的视觉同步功能,边听边看,适合需要同时用眼睛和耳朵吸收信息的学习场景。
适用场景与定价
这类工具的典型用户画像相当清晰:需要在通勤、运动或做家务时消化大量文献的研究生、科研人员,以及有阅读障碍或视觉疲劳、更习惯听觉输入的知识工作者。
产品采用免费额度模式:每月500页免费。对于轻度使用者(比如每月读几篇论文或一两本书的部分章节)来说,这个额度基本够用;重度用户则可能需要付费方案。
「垂直场景TTS」赛道的竞争格局值得了解。Speechify 是目前市场占有率最高的通用文档朗读工具,支持多语言和多种文件格式,但对学术公式的处理并非其核心卖点。NaturalReader 同样定位通用,主打语音自然度。近两年,随着大语言模型普及,Elicit、Consensus 等学术AI工具也在向「文献消化」场景延伸,但方向是问答和摘要而非语音朗读。专门针对「学术PDF语音化」的垂直产品目前仍是相对空白的细分市场,这既是 Accurate PDF Narration 的机会窗口,也意味着用户教育成本较高——需要让目标用户意识到这个痛点值得用专门工具解决。
客观看待:一款早期产品
补充一点,这款产品目前在 Product Hunt 上的数据相当早期——3票、1条评论、排名第20位,还谈不上市场验证。它归属于 Productivity、Education 和 Artificial Intelligence 三个分类,由独立开发者 Hasitha 打造。
这类「垂直场景TTS」赛道本身并不新鲜,市面上已有 Speechify、NaturalReader 等成熟玩家,以及各类基于大模型的文档问答工具。Accurate PDF Narration 的差异化押注在「准确处理复杂学术文档」这一细分能力上。如果它宣称的公式朗读、双栏识别等功能在实测中确实靠谱,那么对特定人群会很有吸引力;反之,若只是营销话术而实际效果一般,就很难在竞争中脱颖而出。
值得关注的信号
从产品思路看,Accurate PDF Narration 反映了一个趋势:AI TTS 正在从「能读」走向「读得懂、读得对」。单纯的语音合成已经是成熟技术,真正的门槛转移到了对文档结构、语义和专业内容的理解上——这恰恰是大语言模型能够发挥作用的地方。
对于关注AI应用落地的读者,这款产品的看点不在于它本身规模多大,而在于它示范了一种把「文档理解」和「语音合成」结合的产品形态。想尝鲜的用户可以利用其免费额度亲自验证核心功能的成色,用实际的论文和书籍来检验它是否真如宣传般「准确」。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。