PDF转Markdown为何仍是开发者的噩梦?

PDF因打印保真设计无法保留语义结构,专用确定性解析器可将PDF还原为干净的Markdown,提升文档可读性与RAG效果。
文章指出PDF从1993年诞生起就为打印保真服务,用绝对坐标渲染字符而不理解语义结构,导致开发者复制代码、表格时断行错位、缩进丢失。Markdown则是GitHub、Obsidian、Notion及Claude、Cursor等AI助手的原生格式,两者之间存在语义鸿沟。作者建议放弃手写pypdf脚本,改用为Markdown树结构设计的确定性解析器(如MD-Convert),基于语义AST而非OCR猜测进行转换。干净Markdown能提升LLM上下文利用率与RAG检索准确率,减少幻觉触发,同时保留GFM表格与代码块。转换流程轻量,无需Docker或API密钥,拖入PDF即可获得.md文件。
每个开发者都经历过这样的场景:找到一份40页的技术论文、API规范文档或遗留软件手册,兴冲冲地把代码片段或对比表格复制粘贴到README.md或LLM提示词中,结果却得到一堆断行错位、缩进混乱的文本。PDF,这个为打印保真而生的格式,正在成为开发者工作效率的隐形杀手。
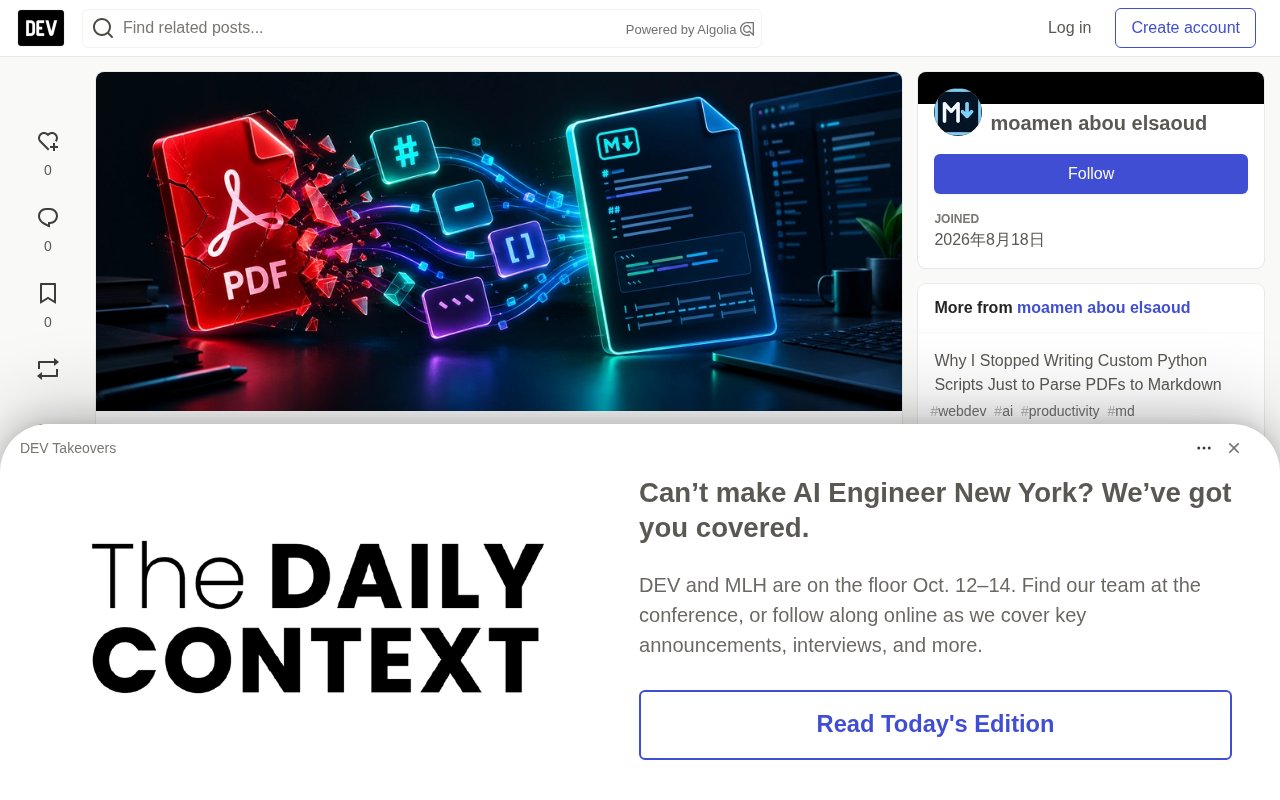
PDF为何从设计上就与开发者作对
PDF诞生于1993年,核心使命只有一个:打印保真度。它关心的是字符在二维平面上的绝对坐标(例如X: 140pt, Y: 520pt),而非文档的语义结构。PDF并不真正理解什么是表格、代码块或二级标题,它只是在物理空间里渲染字符。
这种设计哲学的后果很直接。当你从PDF复制代码时,原本干净的const parseData = (data) => data.map(item => item.id);会变成断成多行的乱码,缩进丢失、标识符被拦腰截断。表格更糟——多列数据会退化成制表符和换行符的“汤”。
Markdown则完全相反,它是纯粹的语义结构,是GitHub、Dev.to、Obsidian、Notion以及Claude、Cursor等AI编程助手的原生语言。从PDF的视觉坐标到Markdown的语义树,中间隔着一道需要大量正则表达式和手动删行才能跨越的鸿沟。
PDF的坐标模型值得展开理解。PDF文档内部是一系列页面内容流,每个字符由文本展示操作符(如Tj、TJ)定位在具体的变换矩阵上,字距、行距、字偶间距都通过数值精确控制。文本流中并不存在“段落”“表格”“列表”这些容器对象,页面上的表格往往只是若干个独立定位的文本片段在视觉上恰好对齐。这意味着两个字符在PDF里是否属于同一单元格,完全取决于它们的X/Y坐标距离,而非任何语义标记。因此,所有PDF文本提取工具本质上都是在逆向推断:用坐标聚类重建阅读顺序,用间距阈值判断换行与分栏,用字体和字号差异猜测标题层级。推断越激进,误判风险越高;越保守,输出就越接近原文那堆散落的字符。这也解释了为什么同一份PDF用不同工具提取,结果可能天差地别。
确定性解析器与OCR或启发式提取的根本区别在于处理路径。常规工具通常将PDF先栅格化为图像,再依赖OCR识别字符,或直接按坐标流式吐出文本,两者的输出都带有概率性或位置噪声。确定性解析器则直接读取PDF的对象层,解析其内容流中的文本操作符,同时建立字符到语义块的映射,再依据版面分析规则将连续文本归类为段落、将规则对齐的文本归为表格、依据字号层级归为标题,最终输出结构化AST。由于不涉及像素识别,只要PDF本身含可提取文本(非扫描件),输出就完全可复现,同样的输入永远得到同样的Markdown,适合纳入版本控制与CI流程。
自动化PDF转Markdown的正确工作流
与其每次都写pypdf或pdfplumber脚本、冒着破坏语法结构的风险提取文本,不如换用专门为Markdown树结构设计的确定性解析器。
一个无需安装重型本地依赖、也不需要交出邮箱地址就能用的工具是MD-Convert的PDF转Markdown工具。它的处理流程很清晰:原始PDF规范→语义AST解析→干净的Markdown文件,后者可直接用于GitHub文档、LLM上下文窗口(Claude/ChatGPT)以及Next.js、Astro等静态站点生成器。
这类工具的核心价值在于“确定性解析”——不是靠OCR猜测字符,而是基于文档的语义抽象语法树进行结构化转换。
为什么这对现代开发栈至关重要
LLM与RAG的上下文摄入
大语言模型按token消费。把原始PDF提取出的大量空白字符和断裂结构喂给模型,不仅浪费宝贵的上下文窗口,还会引入幻觉触发点。干净的Markdown表格和标题层级能显著提升向量检索的准确率,让RAG管线真正可靠。
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种将外部知识库与大语言模型结合的技术:用户提问时,系统先从向量数据库中检索出语义最相关的文档片段,把片段拼接进提示词,再由LLM生成回答。RAG的成败关键在检索环节——如果文档片段本身因为PDF提取而支离破碎,向量模型会把“Host localhost Port 5432”这类混在一起的文本编码成含义模糊的向量,检索时难以命中真正相关的块,甚至把不相关内容排到前面。反之,结构清晰的Markdown让每个标题、表格行、代码块成为独立且语义完整的片段,嵌入向量更纯净,检索准确率随之提高。同时,干净的块不会因为无意义的空白字符和断行而白白占用上下文窗口的token预算,意味着同样长度的提示词能装入更多真正有用的信息。
表格完整性保留
多列数据在专用转换器手中才能真正变成GitHub风格的Markdown表格。原始PDF提取出的表格是破碎的空格制表符,而语义解析后得到的是带|---|分隔符的有效GFM表格。代码块能从混乱格式变成语法高亮块,标题能从压平的纯文本恢复为正确的#、##层级。
GFM(GitHub Flavored Markdown)表格是Markdown在GitHub等平台上广泛支持的一种扩展语法,由表头行、分隔行(如|---|)和若干数据行组成。它的解析规则要求每行用竖线|分隔单元格,且分隔行必须存在,才能被渲染成真正的表格而非普通文本。与HTML表格不同,GFM表格不支持单元格合并、嵌套表格或复杂跨行,结构简单但足够版本控制友好——每一行是纯文本,Git diff能清晰显示增删改。从PDF还原表格时,难点在于确定列边界:工具需要根据文本块的X坐标聚类出列位置,把落在同一列区间内的文本归入同一单元格,再补上分隔行。这样才能把PDF里视觉对齐但无结构标记的多列数据,转成可被GitHub、静态站点生成器乃至LLM稳定解析的GFM表格。
零额外开销
不需要启动Docker容器,不需要申请API密钥,只是为了读一份10页的规范文档。这种轻量级方案对日常开发工作流的侵入性最小。
前后对比:技术数据块的真实转换效果
用一个数据库配置示例来说明差异。标准PDF复制粘贴的结果是:Database Config Host localhost Port 5432 User postgres MaxConnections 100 SSL true——所有字段被压成一行,几乎不可读。
经过专用转换器处理后,输出变成结构清晰的Markdown:
### 数据库配置

| 键 | 值 | 描述 |
|---|---|---|
| `Host` | `localhost` | 主服务器节点 |
| `Port` | `5432` | 标准Postgres端口 |
| `MaxConnections` | `100` | 连接池上限 |
| `SSL` | `true` | 强制TLS |
这种输出干净、可版本控制,能直接用于开发文档。
如何将其融入日常工作流
迁移遗留文档或为团队知识库提取白皮书时,可以遵循一个简单流程:把转换工具固定在开发者书签栏,将技术PDF或规范文件拖入转换器,获取生成的.md文件后直接提交到Git仓库。
整个链条不需要本地Python环境,不需要OCR调参,也不需要处理PDF解析库的版本兼容问题。对于需要频繁处理非结构化文档的团队来说,这能省下大量原本花在正则表达式和手动修表格上的时间。
你的技术栈目前如何处理非结构化文档?是本地Python脚本解析、专用OCR方案,还是直接把原始文件喂给LLM?欢迎在评论区分享你的工具链。
相关推荐
ChatGPT+Codex零基础教程:AI编程从入门到实战
基于B站教程内容,系统梳理OpenAI Codex的三种使用形态、七大核心能力及工程化设计思想,涵盖规范驱动开发、Agent循环机制、上下文工程优化等关键技术点,为开发者提供从入门到实战的完整认知框架。

Claude账号被封怎么办?2026实用替代方案与自救指南
Claude账号被封怎么办?本文整理封禁常见原因、官方申诉流程、防止工作丢失的实用习惯,以及按编程/写作/研究场景推荐的替代方案,帮你快速恢复生产力。

Muse Wonder迷失森林:前沿模型的96美元翻车
Meta新前沿模型Muse Wonder在《宝可梦红》直播中花费96美元、六小时困于常磐森林,同价位Opus 5.5仅用8.44美元通关。本文分析跑分与实战的落差、商品化趋势及隐私争议。