Perplexity发布pplx-embed-v2-late:0.6B与9B多模态检索模型

Perplexity 发布 0.6B/9B 多语言多模态 late-interaction 嵌入模型,共享空间支持非对称部署。
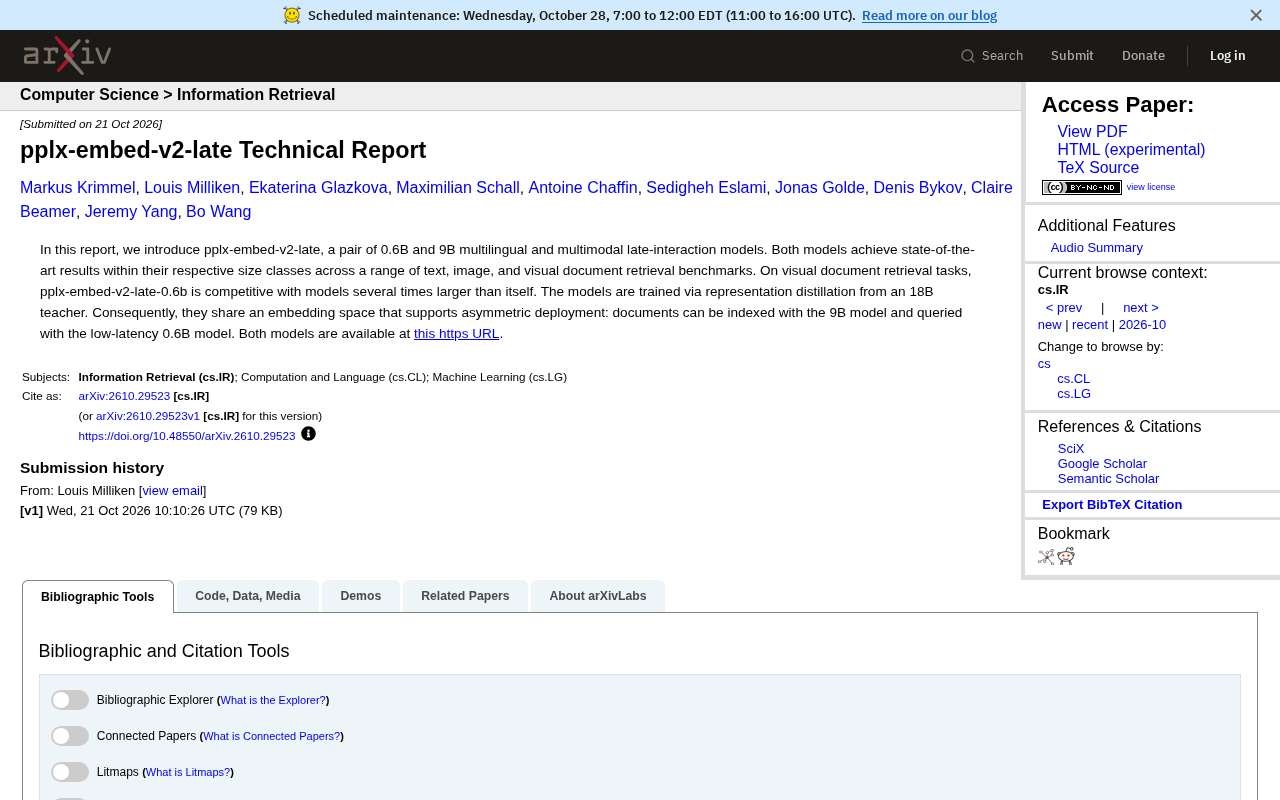
Perplexity AI 发布 pplx-embed-v2-late 系列,含 0.6B 与 9B 两个多语言、多模态 late-interaction 嵌入模型,在文本、图像与视觉文档检索基准上取得同尺寸类别 SOTA。两模型均从 18B 教师模型表示蒸馏而来,共享同一嵌入空间,因而支持用 9B 构建离线文档索引、用 0.6B 处理在线低延迟查询的非对称部署,对 RAG 流水线尤具价值。0.6B 版本在视觉文档检索上可与数倍参数量的模型竞争。模型已在 Hugging Face 公开,但报告摘要未给出具体基准数值,SOTA 结论仍待独立评测验证。
Perplexity AI 近日发布技术报告,推出 pplx-embed-v2-late 系列模型,包含 0.6B 和 9B 两个参数版本。这对多语言、多模态的 late-interaction 模型在文本、图像和视觉文档检索基准上均取得同尺寸类别中的 SOTA 成绩,并通过共享嵌入空间实现“大模型索引、小模型查询”的非对称部署方案。
模型架构与核心特性
pplx-embed-v2-late 采用 late-interaction 架构,区别于将整段文本或图像压缩为单一向量的双塔模型,late-interaction 保留 token 级别的细粒度表示,在检索阶段再进行交互计算,从而在召回精度上更具优势。该系列同时支持多语言与多模态输入,意味着同一套嵌入空间可以处理纯文本、图像以及视觉文档(如扫描件、图表密集的 PDF 页面)的检索需求。
两个版本的具体定位如下:
- pplx-embed-v2-late-0.6b:轻量级模型,面向低延迟查询场景,在视觉文档检索任务上可与数倍于自身参数量的模型竞争。
- pplx-embed-v2-late-9b:大参数量版本,负责高质量文档索引与复杂检索任务。
据技术报告披露,两款模型均通过从 18B 教师模型进行表示蒸馏(representation distillation)训练而来。这一训练策略使两个不同尺寸的模型共享同一个嵌入空间,为后续的非对称部署奠定基础。
Late-interaction 是信息检索中的一类建模范式,由 ColBERT 系列工作推广。与把查询和文档各自编码成单一稠密向量的双塔(bi-encoder)模型不同,late-interaction 为查询和文档的每个 token 保留一个嵌入向量,检索时用 MaxSim 等操作计算查询 token 与文档 token 之间的最大相似度之和作为相关性分数。由于保留了 token 级表示,它能捕捉细粒度的词项匹配信号,召回精度通常优于单向量模型;代价是索引体积显著增大(每个文档要存储数百个向量),且打分阶段的计算量高于点积检索,实际系统常结合倒排或向量量化(如 PLAID)来加速。
表示蒸馏(representation distillation) 指让小模型学习大模型中间表示或输出嵌入的训练方法,区别于只对齐最终 label 的传统知识蒸馏。在嵌入模型中,常见做法是让学生的 token 向量或相似度分布逼近教师,从而把大模型的语义空间“压缩”进小模型。这里两个尺寸的 pplx-embed-v2-late 都从 18B 教师蒸馏,关键收益是学生与教师落在同一嵌入空间,使不同尺寸模型产出的索引和查询可以直接互操作,而不需要额外训练映射层。
非对称部署:用9B索引,用0.6B查询
报告中一个值得关注的工程亮点是共享嵌入空间带来的非对称部署能力。在实际检索系统中,文档索引通常是一次性离线完成的,计算成本可以容忍较高;而查询侧面对的是实时请求,延迟和吞吐是硬约束。pplx-embed-v2-late 的设计允许用 9B 模型构建文档索引,再用 0.6B 模型处理在线查询,两者因共享嵌入空间而无需额外的对齐或映射层。
这种模式对 RAG(检索增强生成)流水线尤其有价值:索引质量由大模型保障,线上服务的响应速度由小模型保障,系统可以在不牺牲检索效果的前提下显著降低查询侧的计算开销。0.6B 版本在视觉文档检索上与数倍大模型持平的表现,进一步说明蒸馏过程较好地保留了教师模型在细粒度视觉文档理解上的能力。
RAG(Retrieval-Augmented Generation,检索增强生成) 指在生成模型回答前,先从外部语料库检索相关片段并作为上下文拼入提示词的范式。其流水线通常分为离线索引与在线检索两段:离线阶段把文档切块、编码为向量并写入向量数据库;在线阶段把用户查询编码后在库中做近邻搜索,再把 Top-K 结果交给生成模型。检索器的质量直接决定生成答案的事实性上限,而查询编码器又处在每次请求的关键路径上,因此“索引侧重、查询侧轻”的非对称设计正好契合 RAG 的成本结构。需要注意,late-interaction 的索引用的是 token 级多向量,存储开销远高于单向量索引,部署时需评估向量库对多向量检索的支持程度与磁盘成本。
基准表现与竞争定位
技术报告称,两款模型在各自尺寸类别内于文本、图像、视觉文档检索基准上均达到 SOTA。说一下,报告未在摘要中给出具体基准名称与数值对比,因此“同尺寸类别 SOTA”的结论目前仅能依据官方表述,尚缺乏第三方复现验证。
视觉文档检索是本次发布强调的重点场景。这类任务要求模型同时理解版面结构、文字内容与图表信息,传统纯文本嵌入模型难以胜任。0.6B 版本在此任务上“与数倍于自身的模型竞争”的表述,若能在独立评测中成立,将使其成为成本敏感型文档检索系统的有力候选。
获取方式与适用场景
两款模型已在 Hugging Face 的 Perplexity AI 组织页面公开,集合地址为 https://huggingface.co/collections/perplexity-ai/pplx-embed-v2。
从应用角度看,该系列适合以下场景:
- 多语言文档检索:需要跨语言召回的企业知识库。
- 视觉文档搜索:扫描件、发票、图表报告的检索与问答前置环节。
- 高并发 RAG 服务:查询侧延迟敏感、索引侧可离线批量计算的在线系统。
对于资源受限的团队,0.6B 版本提供了较低的部署门槛;而对检索质量要求更高的场景,可采用 9B 索引加 0.6B 查询的混合方案。
小结
pplx-embed-v2-late 的核心贡献在于把“尺寸-质量”的权衡转化为可组合的部署策略:蒸馏保证嵌入空间一致,late-interaction 保证细粒度检索能力,多模态与多语言覆盖扩展了适用范围。具体基准数据与独立评测结果有待报告全文与社区验证,这将是判断其实际竞争力的关键。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。