Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:云端规划、本地守隐私,16GB 起步即可用。
Perplexity 推出的 Hybrid Compute 试图解决敏感数据既想用大模型处理又不敢上传云端的矛盾。科技博主 Alex Ziskind 用三台不同内存的 Mac 实测:云端模型负责规划、推理与联网搜索,本地模型接触隐私文件,桌面端应用作为编排者自动分流。核心组件 PrivacyGate 基于开源 PII Tracer 小模型,在数据离开设备前拦截脱敏,并提供本地处理、直接分享、取消三个选项,且可事后审计。本地模型按内存分级,16GB 仅支持 Gemma 4 E4B,32GB 才能解锁 Qwen 3.5 35B 与 Perplexity 自研 19GB 模型。银行流水、医疗记录、停车罚单等递进测试显示方案实用,但拖拽图片入对话框会绕过网关,隐私保护仍部分依赖用户操作习惯。
Perplexity 推出的 Hybrid Compute 试图解决一个长期困扰 AI 用户的矛盾:既想让大模型帮忙处理敏感数据(银行流水、医疗记录、合同账单),又不愿把这些东西上传到云端。科技博主 Alex Ziskind 在 B 站发布的实测视频,用三台不同配置的 Mac 完整跑了一遍这套混合计算流程,结果比预期更实用。
混合计算到底在做什么?
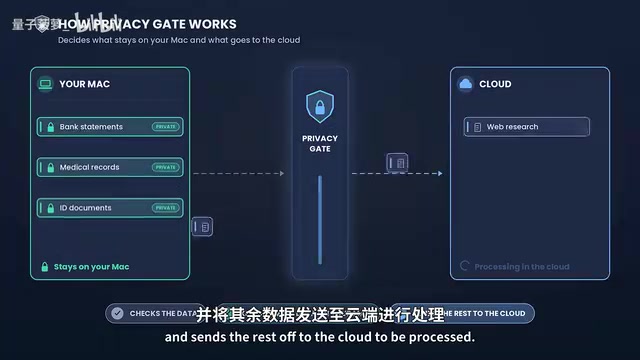
Hybrid Compute 的核心思路并不复杂:把任务拆开,云端模型负责规划、推理和联网搜索,本地模型负责接触隐私文件。Perplexity 的桌面端应用在其中扮演编排者(orchestrator)角色,自动判断哪些内容可以出本地、哪些必须留下。
用户不需要手动切换模型,只需在模型选择器里勾选 Hybrid 模式,然后正常提交任务。系统会调用一个名为 PrivacyGate 的隐私网关,在数据离开设备前进行拦截和脱敏。Alex 在视频中反复强调一点:本地模型和云端模型各有所长,争论谁替代谁没有意义,真正合理的策略是两者并用。
Orchestrator(编排者) 在混合计算架构中扮演调度中枢的角色:它接收用户任务后,根据内容类型与隐私属性自动拆解步骤,决定哪些子任务交给云端大模型(如规划、推理、联网检索),哪些下发给本地小模型执行。编排者本身通常运行在本地客户端,只传递抽象后的指令而非原始数据,从而在保持任务连贯性的同时最小化数据外泄面。这种设计与传统「手动切换模型」的体验差异在于,用户无需理解底层路由逻辑,只需一次授权,系统便按预设策略自动分流。
PrivacyGate:真正的守门人
PrivacyGate 是整个方案的技术支点。它的检测能力来自 Perplexity 在 Hugging Face 上开源的 PII Tracer 小模型,专门识别个人身份信息。当用户提交的文件或图片中包含敏感内容时,网关会弹出提示,给出三个选项:在本地处理(推荐)、直接分享、或取消。
实测中,Alex 故意在示例数据里埋了需要检测的隐私项。上传互联网服务合同、六个月银行流水和账单后,PrivacyGate 立刻拦截并要求确认。选择本地处理后,云端模型继续完成支付匹配和费率比对,本地模型则读取原始文件。他事后查看了一次运行记录,清楚看到哪些字段被脱敏、哪些内容被送往云端,这种可审计性对注重合规的用户来说相当关键。
PII(Personally Identifiable Information,个人身份信息) 指可单独或结合其他信息识别到特定自然人的数据,包括姓名、身份证号、银行账号、病历号、住址、车牌等。在 AI 应用中,PII 检测通常采用轻量级命名实体识别(NER)模型,对文本与图像 OCR 结果进行实时扫描并打标签。PII Tracer 这类小模型的价值在于可在端侧低延迟运行,无需将原文上传即可完成敏感项定位;检测到 PII 后,网关可按策略执行脱敏(如掩码替换)或阻断,从而在数据离开设备前建立一道可控的检查点。
硬件门槛:16GB 起步,32GB 才能解锁全部模型
本地推理对内存有硬性要求。Perplexity 目前提供三个本地编排模型:Gemma 4 E4B(4-bit 量化,6.6GB,需 16GB 内存)、Qwen 3.5 35B(需 32GB 内存),以及 Perplexity 自研的 19GB 模型(同样需 32GB 内存)。
Alex 用三台机器做了对照:16GB 的 MacBook Air 只能看到 Gemma 一个选项;32GB 的 Mac mini 可以解锁全部三个模型;128GB 的 MacBook Pro 自然毫无压力。这种按内存分级的策略务实,但也意味着入门级 Mac 用户的选择空间有限。他提到希望未来能看到更多经过验证的模型加入列表,目前 Perplexity 显然对可用模型做了严格筛选,以保证在特定任务上的可靠性。
4-bit 量化 是一种模型压缩技术:将原本以 16 位浮点存储的权重降为 4 位整数表示,使模型体积缩减至约四分之一,同时通过量化感知训练或后训练校准尽量保持精度。文中 Gemma 4 E4B 的 6.6GB 体积即得益于此。本地推理的内存占用不仅取决于权重体积,还需为 KV Cache(注意力键值缓存)和上下文窗口预留空间,因此 16GB 统一内存的 Mac 在加载 6.6GB 模型后可用余量有限,只能运行单一模型;而 32GB 机型才能同时容纳 19GB 级别的自研模型并留出推理缓冲。
真实场景测试:从银行流水到医疗记录
视频中最有说服力的部分是一连串递进式测试。Alex 准备了带隐私信息的纸质材料拍照上传,包括车辆信息、手术医疗记录和一张停车罚单,隐私敏感度逐级上升。
银行流水任务的完成度最高:本地模型解析文件并匹配付款,云端模型联网搜索并发现了比合同费率更优惠的本地宽带套餐,同时识别出一笔最高 88 美元的疑似多收费。医疗记录测试中,他要求给出手术相关信息的网络检索结果,但坚持文档本身留在 Mac 上,系统照做了——只把脱敏后的查询意图发往云端。停车罚单测试里,他要求核对华盛顿特区的公共记录,模型拒绝发送图片,改为提供查询指引,让他自己输入罚单编号。
一个值得注意的细节是:直接把图片拖进对话框会绕过 PrivacyGate 直接上传云端。正确做法是通过文件系统入口指定文件夹,让系统在本地完成识别。这个交互差异说明,隐私保护机制的有效性仍然部分依赖用户的操作习惯。
便利与安全的平衡点
Alex 在结尾的总结很克制:这套工作流的价值在于把原本需要手动切换的混合模式做成了一个连贯体验,云端负责难问题,本地守住敏感文件。它没有消灭隐私风险,而是把风险控制点从“用户自觉”转移到了“系统拦截 + 用户确认”的双层机制上。
对需要处理财务、医疗、合同类数据的知识工作者来说,这种范式提供了一个可操作的中间路线。代价是硬件门槛和一定的交互学习成本,收益则是不必再在便利与安全之间做非此即彼的选择。
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。