PewDiePie 同款 AI Agent:从零搭建自己的 Odysseus
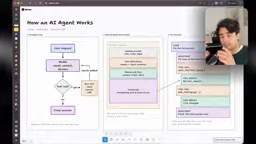
PewDiePie 用 Odysseus 项目展示了普通人如何搭建属于自己的本地 AI Agent。
文章以 PewDiePie 开源项目 Odysseus 为切入点,把"搭建 AI Agent"这件看似门槛很高的事拆成几个可理解的概念。首先解释 agent 的本质是对 LLM 的循环调用——输入、推理、工具调用、结果返回、再推理,复杂度都藏在上下文管理里。其次澄清"应用在本地"和"模型在本地"是两回事,Odysseus 跑在本机 Docker 中,但可以选择云端或本地模型。接着给出本地模型的落地路径:在 Hugging Face 筛选模型、用 llama.cpp 运行、按硬件兼容性图表选量化等级。最后讲微调,说明小模型工具调用为何不稳定,以及 OpenAI 加密推理 token 导致无法直接蒸馏、转而使用开源模型轨迹或公开数据集的替代方案。
一个网红如何把 AI Agent 带进大众视野
PewDiePie 开始做 AI 了。这件事本身的意义在于:一个拥有巨大影响力的创作者,正在尝试搭建属于自己的 AI Agent——而且他把整个过程暴露在了公众面前。很多人看到他做的事情会觉得"太复杂了",但实际上,如果从最基础的概念开始理解,这些东西远比想象中可接近。
他正在构建的项目叫 Odysseus,一个本地部署的 AI Agent 应用。它本质上是一个类似 ChatGPT 的对话界面,但完全 LLM 无关(LLM-agnostic)——你可以接入任何模型。它通过 MCP 服务器支持外部工具,还内置了邮件客户端、记忆系统、技能提取、模型对比、深度研究等功能。安装方式偏技术化:从 GitHub 克隆仓库,挂载 Docker 容器,整个应用运行在你本机的 Docker 环境里。
你可能没注意到,他还尝试把一个 Qwen 3.5 系列的小参数模型微调后跑在本地,专门配合 Odysseus 做工具调用。这篇文章会拆解他做了什么、你如何复现,以及背后的技术原理。
什么是 Agent Harness:两三次 LLM 调用构成的循环
要理解 Odysseus,先要理解"agent harness"这个概念。视频中的解释非常清晰:一个 agent 本质上就是对语言模型的循环调用,仅此而已。
Agent 的工作流程
当你向 agent 发送一条输入,这条输入会被送到语言模型。模型读取上下文——包括系统提示词、工具定义、相关记忆、对话记录——然后决定如何回应。如果问题可以直接用文字回答,它就输出答案。如果需要调用工具(比如搜索互联网、执行程序、调用外部服务),它就发起一个 tool call。你的应用程序(在这里就是 Odysseus)执行这个工具调用,把结果返回给模型,模型再次推理,决定是继续调用工具还是给出最终答案。
这个循环听起来简单,但整个 agent 的复杂性都藏在"上下文管理"里。每次调用模型时发送的上下文通常包括:系统提示词(定义 agent 的目标和身份)、工具定义列表(告诉模型有哪些工具可用)、记忆和文件(从之前的对话或用户分享的资源中提取)、以及完整的对话记录(每一条消息都会被持久化并在每次交互中重新发送)。
工具不只是给模型用的
Odysseus 有一个很有意思的设计思路:工具同时拥有自己的用户界面,你可以手动操作它们。比如日历工具,你可以自己创建事件,模型也可以。这种"工具即应用"的模式正在 MCP 服务器中越来越常见——Agent 可以操作你的 Notion、Airtable,但这些应用本身仍然有你可以使用的界面。
MCP(Model Context Protocol) 是由 Anthropic 在 2024 年底提出并开源的协议,目标是给 LLM 应用和外部数据源、工具之间定义一个统一的通信标准。在 MCP 出现之前,每个 agent 框架都要自己定义工具接口——OpenAI 用 function calling 的 JSON Schema,LangChain 有自己的 Tool 抽象,各家互不兼容。MCP 把这些抽象成一套基于 JSON-RPC 的客户端-服务器协议:工具、资源、提示词模板都被包装成 server 暴露的能力,客户端(也就是 agent harness)只要实现一次 MCP 客户端,就能接入所有遵循该协议的 server。这使得"一次编写工具,多个 agent 复用"成为可能,也是 Odysseus 这类应用能快速接入日历、邮件、Notion 等外部服务的原因。
本地运行的真相:应用在本地 ≠ 模型在本地
PewDiePie 说 Odysseus 是本地运行的,这没错——它跑在你电脑的 Docker 容器里,把 URL 分享给外部的人,他们是访问不到的。但这并不意味着模型也在本地运行。
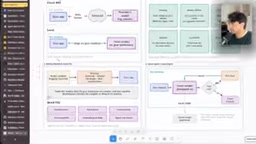
这是很多人容易混淆的地方。当你在 Odysseus 里选择 Mistral Large 这样的云端模型时,你的数据会离开本机,经过 OpenRouter 路由到 Mistral 的 API,然后再返回结果。每一轮 agent 循环都是如此。
而"本地模型"意味着模型本身运行在你的硬件上,数据永远不离开你的设备。这就是为什么很多人偏好本地方案:隐私性更强、可以离线工作、没有按 token 计费。但要注意——本地运行不等于免费。你仍然要付电费,而且运行大模型时电费开销不小。
本地模型的优势还在于:你可以完全控制它,甚至微调它。对于中小型应用和自包含的任务,本地模型的速度已经相当可观。
量化(Quantization) 是把模型权重从高精度(如 FP16、BF16,每个参数占 2 字节)压缩到低精度(如 INT8、INT4,每个参数占 1 或 0.5 字节)的技术。它直接决定了你能否在消费级硬件上跑起某个模型:一个 27B 参数模型在 FP16 下需要约 54GB 显存,而 Q4 量化后只需约 14GB,普通游戏显卡或 Mac 统一内存就能装下。代价是精度下降,通常会带来少量质量损失——Q4_K_M 这类格式在实践中被证明是质量与体积的较好折中。Hugging Face 页面上标注的 Q4、Q5、Q8 就是指不同的量化等级,数字越大精度越高、体积也越大。llama.cpp 原生支持 GGUF 格式的量化模型,这也是它在本地推理中广泛使用的主要原因。
在 Hugging Face 上找到适合你的模型
Hugging Face 是开源模型最大的集散地。你可以按"文本生成"筛选,再按模型大小过滤。一般来说,消费级硬件能跑的模型上限大约在 240 亿到 320 亿参数之间(取决于量化方式和具体硬件)。比如 Qwen 3.8 的 27B 版本,经过量化后大多数消费级设备都能运行。
运行本地模型最直接的方式是用 llama.cpp(llama.app)。它不仅能帮你运行模型,还会根据你的硬件推荐合适的模型。安装后,你会看到一个菜单,里面有针对你电脑的推荐模型列表。
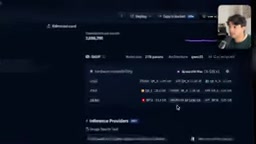
在 Hugging Face 的设置里填写你的硬件信息(比如 Apple M4 Max 36GB),系统会给出一个兼容性评分。然后你可以在具体模型页面上看到硬件兼容性图表,它会推荐最适合你的量化等级——比如 Q4。如果模型太大跑不动,可以往下降级,选更小的版本。
在 Odysseus 中加载本地模型也很简单:进入 Cookbook,找到你下载的模型即可。
微调小模型:PewDiePie 踩过的坑和你该走的路
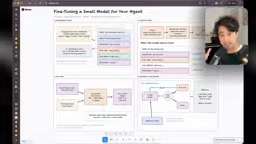
PewDiePie 的 Ajax 项目是一个微调过的 Qwen 3.5 9B 模型。他为什么需要微调?因为当他从 GPT 系列切换到 Qwen 9B 本地模型后,agent 变得不可靠了——工具调用经常失败或选错工具。
为什么小模型需要微调
云端大模型(如 GPT-4 级别)在工具调用上表现稳定,但小参数模型在理解复杂工具定义时容易出错。一个可能的优化方向是精简工具定义,让它们对小模型更友好。但如果效果仍然不够,微调就是下一步。
开源模型的好处就在于:你可以下载现有权重,在自己的任务数据上继续训练。即便只有 90 亿参数,针对性微调后也能在特定场景下表现优秀。
工具调用(Tool Calling / Function Calling) 对模型来说并非"理解工具"那么简单,它要求模型在自然语言输出中稳定地生成结构化 JSON,并且能根据用户意图从几十个候选工具中挑选正确的一个并填对参数。这依赖预训练阶段是否见过足够多的结构化调用样本,以及模型是否有足够容量记住每个工具的参数 schema。参数越大,模型对这种"格式约束 + 语义匹配"的处理越有余量;9B 级别模型往往会生成格式合法但选错工具、或参数缺失的调用。LoRA(Low-Rank Adaptation) 是微调这类模型的主流方法,它冻结原权重,只在注意力层旁边训练一对小的低秩矩阵,显存占用和训练时间远低于全参数微调,也正因此在消费级硬件上可行。
训练数据从哪来
微调一个工具调用模型,需要的是"正确调用工具的对话历史"。PewDiePie 原本想用 GPT 产生的 agent 轨迹来训练小模型,但遇到了一个硬性障碍:OpenAI 通过 API 或订阅返回的生成结果中,推理 token 是被加密的。而推理过程对微调至关重要——模型先思考再回答,那些思考内容包含了关键的决策逻辑。他尝试提取这些推理内容,结果被 OpenAI 封禁了两次。
更聪明的做法是:使用开源模型(如 DeepSeek广告 或 GLM)产生的轨迹来训练小模型。或者直接在 Hugging Face 上筛选已有的公开 agent 轨迹数据集。如果你自己在运行 agent,也可以把本地的轨迹数据匿名化后上传到 Hugging Face——去掉凭证信息再公开,帮助社区训练更多小模型。
推理 token(Reasoning Tokens) 是 o1、o3 等推理模型在给出最终答案前生成的一段内部思考内容,模型会先"想"再"答"。许多模型供应商出于防止蒸馏和商业保护的考虑,通过 API 返回时对这段内容做了加密或隐藏,只透出最终答案。这意味着研究者无法直接从 API 输出中拿到可供训练的"思考轨迹"。相比之下,DeepSeek-R1、GLM 等开源推理模型会以明文输出推理过程,配套的开源权重和数据集也让研究者可以做蒸馏(distillation)——用大模型的推理轨迹去监督小模型。这正是原文建议改用开源模型轨迹的核心原因,也是当前社区生成 agent 训练数据最常用的路径。
完整的学习路径
Hugging Face 频道有一套完整的"post-training agents"播放列表,共五个视频。如果你想做上面说的这些事情,可以从第三个视频(训练 agent)开始看起,它详细演示了如何用大模型的轨迹来训练小模型。
你现在就可以开始
总结下来,搭建一个属于自己的 AI Agent(无论是自建 harness 还是用 Odysseus)的路径是清晰的:
先理解 agent 的循环本质——输入、推理、工具调用、结果返回、再推理。然后选择一个 harness(Odysseus 或其他),配置你想要的模型(云端或本地)。如果想要完全本地化,用 Hugging Face 找模型,用 llama.cpp 运行,根据硬件兼容性图表选择量化等级。如果小模型的工具调用不够稳定,收集正确执行的轨迹数据,参考 Hugging Face 的微调教程进行针对性训练。
整个链条没有哪一步是不可逾越的。PewDiePie 做的事情,你在家里也能做。
相关推荐

REA:无需编码,用AI逆向任意应用
REA是一款爆火GitHub的开源AI逆向工程工具,可让Claude、Codex等AI代理直接分析任意应用并生成功能克隆,无需编码。本文介绍其工作原理、安装方法、实测案例及法律风险。

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。