PFN如何逼近贝叶斯推断?摊销误差的实证剖析

PFN摊销贝叶斯推断总体有效,但罕见场景下存在无法靠扩大规模消除的残差误差,贝叶斯模型平均可有效缓解。
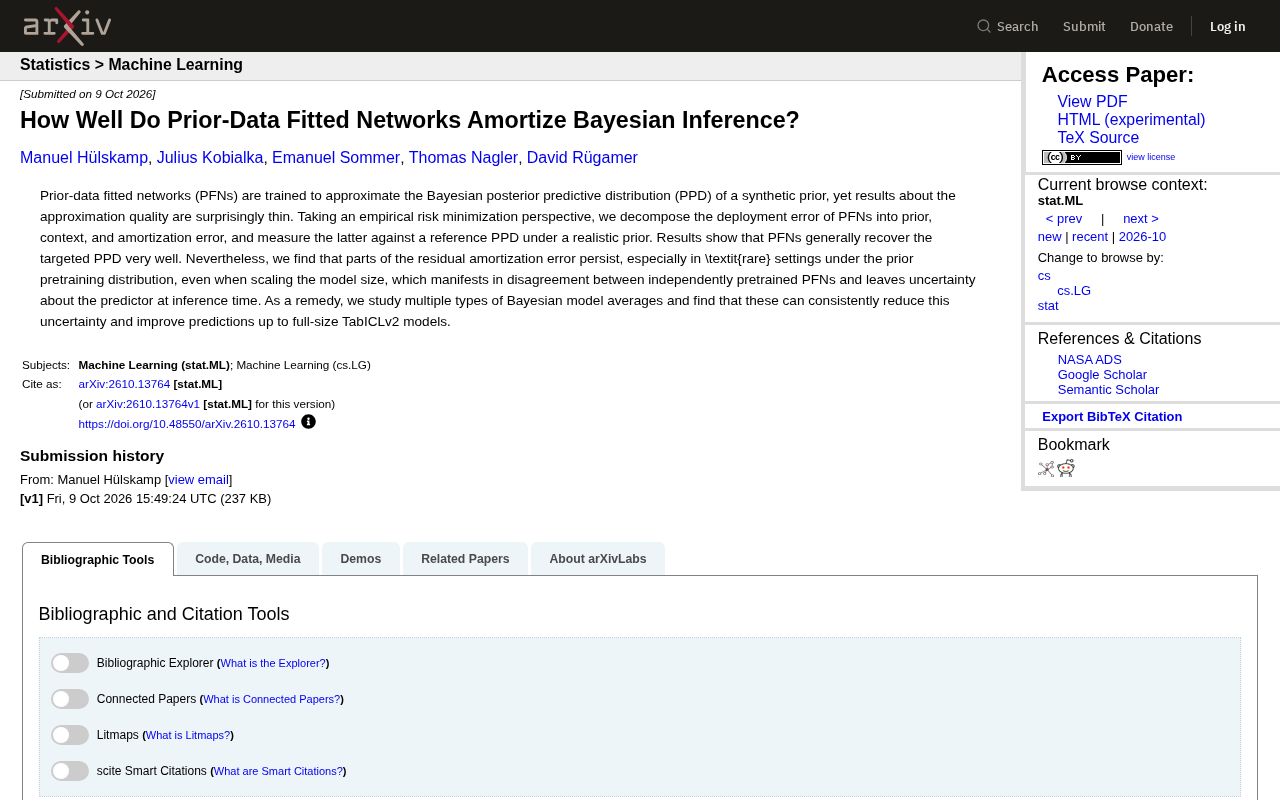
先验数据拟合网络(PFN)通过在合成数据上预训练Transformer,将贝叶斯后验预测分布的计算"摊销"到训练阶段,从而实现无需推断时更新参数的快速预测。本研究首次系统评估了PFN的摊销近似质量,将部署误差拆解为先验误差、上下文误差和摊销误差三部分,重点测量第三项。结果显示,PFN总体能良好复现目标分布,但在先验分布中的罕见场景下存在顽固的残差摊销误差,且该误差无法通过扩大模型规模消除——其外在表现为独立训练的多个PFN之间出现系统性预测分歧。对此,研究验证了多种贝叶斯模型平均策略能一致降低该不确定性,即便在全尺寸TabICLv2模型上仍有增益,表明这是一个结构性问题,集成平均是当前最有效的工程补救路径。
从摊销学习看PFN的本质
先验数据拟合网络(Prior-data Fitted Networks, PFN)是近年来表格数据建模领域的重要创新。它的核心思路是:通过在大量合成的先验数据上进行预训练,让神经网络直接学会近似贝叶斯后验预测分布(Posterior Predictive Distribution, PPD)。这种做法把原本需要在推断时反复进行的贝叶斯计算,"摊销"(amortize)到了一次性的预训练过程中——换言之,模型学会了一种直接从数据映射到预测的能力,而无需在部署时做显式的后验采样。
这一思路听起来优雅,但一个关键问题长期被忽视:PFN究竟在多大程度上真正逼近了目标后验预测分布?这项研究指出,关于PFN近似质量的实证结果"出人意料地稀缺"(surprisingly thin),而这正是其试图填补的空白。
贝叶斯后验预测分布(PPD)是贝叶斯推断的核心输出:给定已观测数据(上下文),它描述了对新样本标签的完整概率分布,而非单点预测。传统方法需要对模型参数的后验分布进行积分——这在计算上极为昂贵,通常需要马尔可夫链蒙特卡洛(MCMC)采样或变分推断等技术。"摊销"这一概念借鉴自摊销变分推断(Amortized Variational Inference):与其在每个新数据集上从头做推断,不如用大量训练样本让网络直接学会推断过程本身,将推断成本"预付"到训练阶段。PFN将这一理念推进到极致——Transformer架构天然适合处理变长上下文,使得网络可以在推断时直接将训练集作为输入并输出预测分布,无需任何参数更新。
把部署误差拆成三部分
研究采用了经验风险最小化(Empirical Risk Minimization)的视角,将PFN在实际部署时产生的误差系统地分解为三个来源:
- 先验误差(prior error):合成先验与真实数据分布之间的差距;
- 上下文误差(context error):有限上下文样本带来的信息不足;
- 摊销误差(amortization error):网络本身在逼近目标PPD时的近似偏差。
这种分解的意义在于,它把一个笼统的"预测不准"问题,转化为可以分别测量和归因的组成部分。研究重点聚焦于摊销误差,并在一个现实的先验设定下,将PFN的输出与参考PPD进行对照测量。这样的实验设计让"PFN到底哪里出了问题"变得可量化,而非停留在直觉判断。
经验风险最小化(ERM)框架将学习问题表述为:在有限样本上最小化损失函数的期望,以逼近真实目标函数。将其应用于PFN的误差分析时,三类误差对应三种不同的近似缺口:先验误差类似于传统机器学习中的"模型偏差"——合成数据生成过程与真实世界分布的系统性偏离;上下文误差对应统计估计中的方差——有限的训练样本无法完整刻画数据生成过程;摊销误差则独属于这一范式——即便先验完美、样本无限,神经网络的有限容量和训练过程的随机性仍会引入额外偏差。这三类误差的正交分解使得"模型在某数据集上表现不佳"这一笼统现象变得可诊断、可归因,为定向改进提供了理论抓手。
整体表现良好,但残差误差顽固存在
实证结果给出了一个相对乐观的基本结论:PFN通常能够很好地复现目标后验预测分布。也就是说,在大多数常规场景中,摊销学习确实有效,网络捕捉到了贝叶斯推断的核心行为。
然而,研究也发现了一个值得警惕的现象:部分摊销误差会顽固地残留,尤其是在先验预训练分布中的罕见(rare)场景下。更关键的是,这种残差误差无法仅靠扩大模型规模来消除——即便把模型做得更大,罕见设定下的近似偏差依然存在。
这一误差的外在表现是:独立预训练的多个PFN之间会出现预测分歧。当两个用相同方法、不同随机种子训练出来的模型对同一输入给出不一致的预测时,就说明推断时存在关于"哪个预测器才对"的额外不确定性。这种不确定性并非来自数据本身,而是来自摊销过程的不完美。
贝叶斯模型平均作为解药
针对上述残差不确定性,研究提出并验证了一种务实的补救方案:贝叶斯模型平均(Bayesian Model Average, BMA)。
直觉上,既然多个独立训练的PFN会产生分歧,那么对它们的预测进行合理的平均,就有望抵消各自的随机摊销偏差。研究考察了多种类型的贝叶斯模型平均方式,结果表明这些方法能够一致地降低推断时的不确定性,并改善预测质量。
尤为值得关注的是,这种改善在最大规模的TabICLv2模型上同样成立——即便是已经达到全尺寸的强大模型,模型平均依然能带来增益。这从侧面印证了前面的发现:摊销误差是一个结构性问题,不是单纯靠堆参数就能解决的,而集成式的平均策略提供了一条更有效的路径。
贝叶斯模型平均(BMA)的理论基础是:当存在多个合理的模型时,真正的贝叶斯处理方式不是选择其中"最优"的一个,而是对所有模型的预测按照其后验概率加权平均。在深度学习语境中,不同随机初始化训练得到的多个模型可以视为对模型空间的采样——每个模型隐含了关于"哪种推断器更合适"的不同假设。对于PFN,每次独立训练相当于对摊销误差的不同随机实现,平均这些实现可以抵消随机偏差,效果类似于集成学习(Ensemble)中的方差缩减。与普通集成方法的差别在于,BMA有明确的贝叶斯解释:它不只是工程技巧,而是在模型不确定性层面做了更完整的概率处理。TabICLv2是目前规模较大的表格上下文学习基础模型,该模型上依然存在改善空间这一事实,说明摊销误差的残留是系统性而非容量瓶颈导致的。
对实践与研究的启示
这项工作给表格基础模型的使用者和研究者都带来了实际价值。
对于使用者而言,一个直接可操作的建议是:在依赖PFN进行高风险或罕见场景预测时,不应盲信单个预训练模型的输出,而应考虑通过多个独立模型的贝叶斯平均来降低不确定性。独立模型间的分歧本身,也可以作为一个识别"模型可能不可靠"的信号。
对于研究者而言,误差的三元分解框架(先验、上下文、摊销)为后续诊断PFN性能瓶颈提供了清晰的工具。它提醒社区:评估PFN不能只看平均指标,更要关注分布尾部与罕见情形下的近似退化——这往往是摊销学习最薄弱的地方。
总体来看,PFN作为"把贝叶斯推断摊销进网络权重"的范式确实可行且表现优异,但它并非完美替代真正的贝叶斯计算。认识到摊销误差的存在边界,并用模型平均等手段加以弥补,是让这类方法走向可靠部署的关键一步。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。