Pi Context View插件:让Agent上下文与Skill一目了然
Pi Context View插件让Agent输入侧上下文可见、可查、可对比。
文章介绍了B站UP主小莫桃推荐的一款Pi插件Pi Context View,用于查看AI Agent实际收到的系统提示词、工具定义和动态注入内容。插件提供Usage和Injections两个入口,前者展示上下文的分类与估算占用,后者可展开系统提示词、工具定义及扩展注入的内容。文章说明了安装与使用方式(输入/context打开,需Pi 1.3以上),并给出多种实用场景:安装前后对比验证插件新增内容、分别检查Skill的列表与已读取正文、搜索项目规则是否生效,以及通过先搜索定位再局部读取大幅节省上下文字符(案例从36000多降至397)。此外还介绍了如何配合Compact压缩机制检查摘要保留情况,并提醒插件数字为估算值、只能确认内容可见而不能解释模型决策。
在AI Agent开发中,模型实际收到的系统提示词、工具定义和动态注入的内容往往像黑盒一样难以观察。B站UP主小莫桃在视频中介绍了一款名为Pi Context View的插件,专门用于查看Agent的输入侧上下文,帮助开发者验证配置是否生效。
为什么需要上下文查看插件
当你为Agent添加了插件、Skill或项目规则后,模型收到的系统提示词和工具说明究竟包含哪些内容?哪些信息会直接注入,哪些需要读取文件后才进入上下文?这些问题在常规聊天界面中无法直接回答。
Pi Context View填补了这一空白。它提供两个核心入口:Usage用于展示上下文的分类和估算占用情况,Injections则可以展开系统提示词、工具定义以及部分扩展加入的内容。
使用方式很简单:在终端执行安装命令后,启动Pi并在输入框中输入/context即可打开上下文视图。如果Pi会话已经开启,需要先执行/reload重新加载扩展。注意该插件需要Pi 1.3或更新版本。
系统提示词(System Prompt)是模型在对话开始前收到的最高优先级指令,通常包含角色设定、行为约束和输出格式要求。在Agent场景中,系统提示词往往比普通聊天长得多,因为它还要嵌入工具使用规范、安全策略和多步任务流程。开发者通常只能通过代码或配置文件间接推断最终拼装结果,而不同框架的模板拼接、变量替换和条件分支会让实际内容与预期产生偏差。Pi Context View的Injections视图直接呈现拼装后的系统提示词原文,使这类偏差可被定位。
工具定义(Tool Definition)则是以结构化schema形式声明的可调用函数,包含名称、描述和参数说明。模型依据这些描述决定何时调用哪个工具、如何填参。工具描述写得含糊或参数名不一致,会直接导致调用失败或误用。因此查看工具定义是否被完整、正确地注入,是调试Agent行为的关键一环。
上下文分类与可视化
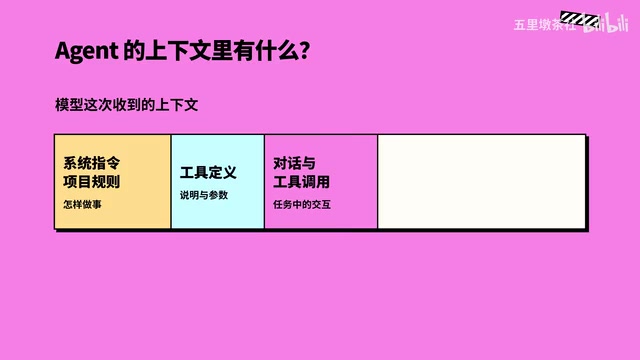
插件以图表形式展示上下文的组成。系统指令和项目规则说明Agent应如何工作、遵守什么要求;工具定义则列出可用工具、功能及参数。任务进行中的对话、工具调用和返回结果会持续加入上下文,读取文件带入正文,搜索代码带入匹配结果,运行测试带入测试结果或日志。
同类内容保持同色,方便理解。部分历史也可能被整理成摘要供后续使用。聊天窗口只能看到其中一部分,而系统提示词、工具说明和扩展临时加入的内容通常需要另外检查——这正是Pi Context View的价值所在。
如何检查插件和Skill的注入
想验证插件新增了哪些内容?可以安装前后各开一个新会话,保持Pi版本、模型、项目和原有工具一致,再对比系统提示词和工具定义的变化。
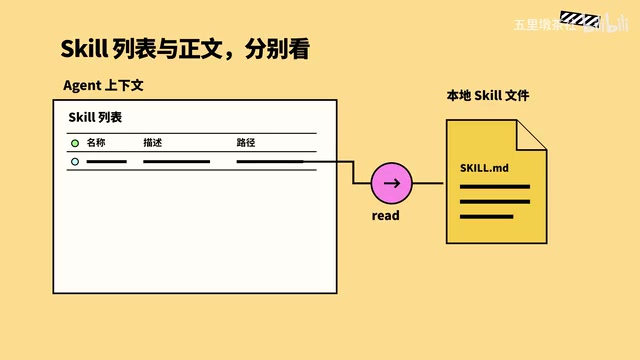
对于Skill,模型先收到名称、描述和路径,但文件正文仍在本地,只有当Agent用Read工具读取后,正文才作为工具返回内容加入上下文。因此检查Skill时需要分别看列表和已读取的正文。
项目规则也可以这样验证:展开系统提示词,搜索你写过的要求,确认它是否出现在当前可查看的提示词中。
Skill的懒加载机制值得单独说明:Agent启动时通常只把每个Skill的名称、一句话描述和本地路径写入上下文,这是一种节省token的设计。模型看到描述后判断当前任务是否需要该Skill,若需要则调用Read等文件读取工具加载正文。这意味着“列表里出现了某个Skill”与“该Skill的正文已进入上下文”是两个不同状态。调试时若发现模型没有按Skill要求行事,应先确认正文是否真的被读取,而不是只检查名称是否出现。同理,项目规则若以文件形式存放,也可能经历类似的按需加载流程。
搜索与上下文优化
上下文内容较多时,可以直接在Injections里按名称筛选。例如打开Read工具定义并搜索Limit,就能查看限制读取行数的参数说明。

一个实际案例:需要从600行配置样本中找两个值时,完整读取返回36000多个字符,而先搜索位置再读取相关区域,合计仅返回397个字符,两个目标值仍然都在。这能有效节省上下文窗口。
与压缩机制的配合
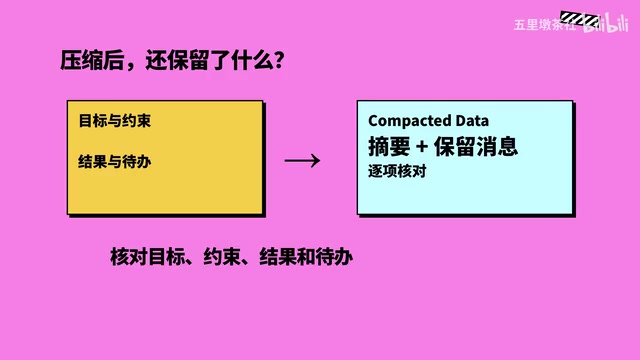
Pi本身支持自动压缩历史或手动执行Compact。想了解压缩后模型还能看到什么,可以打开Compact Data和保留的消息,检查任务目标、限制条件、验证结果和待办是否保留。
插件中的数字主要根据字符数等方法估算,适合比较组成和查找内容,实际费用需看服务用量记录。扩展的加载顺序会影响部分变化是否可见。
上下文压缩(Compaction)是长会话中控制token预算的常用手段:当历史消息接近窗口上限时,系统把较早的对话、工具调用和结果汇总成一段摘要,用摘要替换原始记录,从而腾出空间。压缩的副作用是细节丢失——被压缩掉的原始工具返回内容不再对模型可见,只有摘要中保留的要点继续生效。Pi的Compact Data视图展示的正是这份摘要及被保留的最近消息,因此检查时应重点关注任务目标、硬性约束、已验证结论和未完成待办是否在摘要中被准确保留,这些信息一旦丢失,模型后续行为就可能偏离原定方向。
使用建议与局限
选定一个具体问题——项目规则有没有加入、工具有哪些参数、某个Skill的正文有没有读入——找到对应分类搜索并展开,再决定是否调整配置。需要注意的是,检查到某条指令只能确认它出现在可观察的内容中,不能单凭它解释模型为什么做出某个决定。
Pi Context View让平时不容易看见的输入变得可检查,为配置和调试Agent提供了可靠依据。
相关推荐

用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。