Pilot5 Legal:五个AI模型互相"挑刺"的法律助手

Pilot5 Legal用五个AI模型互相质疑法律答案,以透明推理和引用验证对抗AI幻觉风险。
Pilot5 Legal是一款面向法律专业人士的AI工具,其核心创新在于让五个前沿AI模型独立分析同一法律问题并互相质疑,最终收敛出推荐结论,同时保留最强反对意见。这一"多模型对抗"设计直指法律AI最大的痛点:AI幻觉与盲目自信。在功能层面,产品提供一手资料研究、引用验证、合同分析与透明推理四项能力,特别是引用验证功能直接回应了ChatGPT虚构判例等行业翻车事件。产品理念强调可审查、可挑战,契合律师对AI输出负最终责任的合规现实。但多模型架构也带来成本与延迟的代价,且若各模型存在同质化训练偏差,"对抗"效果将大打折扣。目前产品在ProductHunt获73票,仍处早期阶段,核心指标有待验证。
一个让AI彼此"质疑"的法律工具
在ProductHunt上,一款名为 Pilot5 Legal 的产品引起了法律科技圈的关注。它的标语直截了当:"Five AI models challenge every legal answer"(五个AI模型质疑每一个法律答案)。截至发稿,该产品获得73个投票、6条评论,位列当日排行榜第16名,被归入 Productivity、Legal 和 Artificial Intelligence 三个分类。
与市面上多数基于单一大模型的法律AI不同,Pilot5 的核心思路是"多模型对抗":让五个前沿AI模型独立分析同一个法律事务,相互挑战对方的推理过程,最终收敛到一个推荐结论——但同时保留最强的反对意见。这种设计直指当前AI在专业场景中最大的痛点:幻觉与盲目自信。
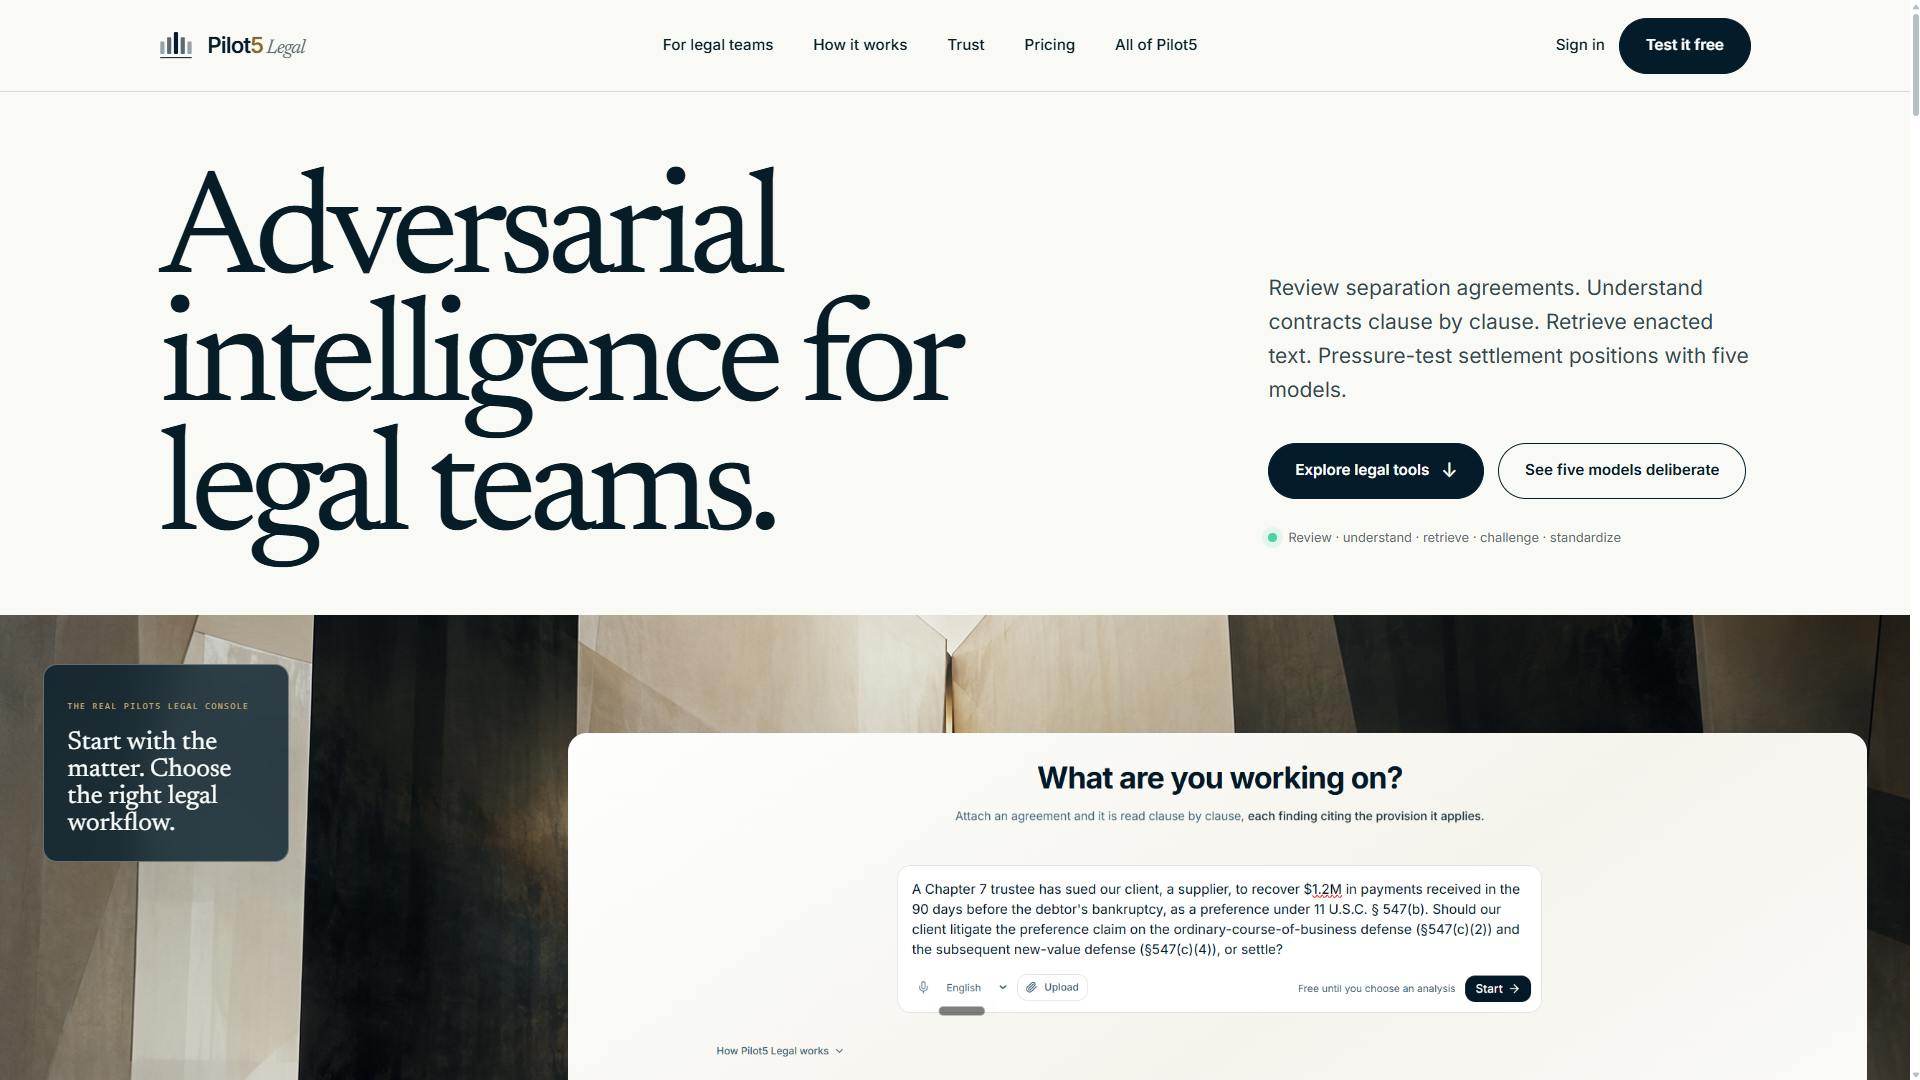
为什么要让多个模型"打架"?
单一大模型在给出法律意见时,往往以流畅自信的语气输出结论,哪怕内容存在错误。对律师而言,这种"看似可信"恰恰是最危险的——一个错误的判例引用或条款解读,可能带来真实的职业与法律风险。
Pilot5 的多模型交叉验证机制试图解决这个问题。五个模型独立推理、互相质疑,相当于在系统内部构建了一场"模拟辩论"。当多个模型就某个结论达成一致时,可信度自然更高;而当它们产生分歧时,系统不会强行抹平矛盾,而是把最强的对立观点呈现给用户。
这种"保留异议"的设计理念值得肯定。法律工作的本质之一就是权衡对立论点,一个只给单一答案的工具反而可能误导判断,而展示分歧则更贴近律师真实的思考方式。
AI幻觉(Hallucination)是指大语言模型以高置信度生成事实上并不存在或错误的内容。在法律场景中,这一问题的危害尤为突出:2023年美国联邦法院的Mata v. Avianca案中,律师使用ChatGPT撰写案件摘要,AI凭空捏造了多个不存在的判例,最终导致律师被法院处以制裁并公开道歉。这一事件成为法律界对AI工具保持戒惕的标志性案例。多模型交叉验证的思路,本质上借鉴了学术同行评审(Peer Review)和法庭对抗制(Adversarial System)的设计哲学——没有单一权威,结论需经得起独立审查和反驳,方可被采信。
专为法律场景打造的四项能力
在多模型框架之外,Pilot5 Legal 针对法律工作补充了四项关键功能:
一手资料研究
直接检索权威的原始法律文献,而非依赖训练数据中的二手信息,降低了内容陈旧或断章取义的风险。
引用验证
对AI给出的判例、法条引用进行核验。这是法律AI的生命线——AI"编造判例"已有不少公开翻车案例,引用验证能力直接决定工具能否被专业人士信任。
法律引用的准确性在专业实践中具有"一票否决"效力。一旦向法院提交含有虚假判例的文件,不仅案件本身受损,律师还可能面临职业纪律处分。当前主流大模型的训练数据存在截止日期,且法律数据库(如Westlaw、LexisNexis)并非完全开放抓取,导致模型在生成引用时容易混淆真实判例与臆造内容。真正可用的引用验证功能,需要在运行时实时连接权威法律数据库进行比对,而非仅靠模型自身的"记忆"——这也是该功能的实现难度远高于普通RAG(检索增强生成)的原因。
合同分析
针对合同文本的条款审查与分析,是律师日常工作中高频且耗时的环节,自动化价值明显。
透明推理
整个推理过程对用户可见,设计目标是让律师能够"检查、挑战并验证"AI的输出。这与"黑箱给答案"的模式形成鲜明对比。
透明与可验证:法律AI的正确方向
Pilot5 Legal 的产品哲学可以概括为一句话:不让律师盲信AI,而是给律师提供可审查的工具。
这与当下法律AI的监管与行业共识高度契合。在许多司法辖区,律师对提交内容负有最终责任,AI生成的任何意见都必须经过人工核验。因此,一个强调"透明推理+引用验证+保留异议"的工具,在合规层面比单纯追求"一键生成答案"的产品更有生存空间。
从产品定位看,Pilot5 并非全新品牌,而是"relaunching for legal work"(为法律工作重新定位)。这意味着团队已有多模型协作的技术积累,如今将其聚焦到对准确性要求极高的垂直领域。
几点冷静的观察
多模型架构在提升可信度的同时,也带来成本与延迟的代价——五个前沿模型同时运行,推理开销不容小觑,这可能反映在定价上。
其次,"模型互相质疑"的效果高度依赖编排逻辑的质量。如果五个模型本身存在相似的训练偏差,所谓的"对抗"可能只是"同温层附和",无法真正暴露错误。多样性能否落到实处,是决定产品成色的关键。
另外,ProductHunt 上73票、6条评论的热度属于中等水平,产品仍处于早期阶段,实际的引用准确率、合同分析质量等核心指标还需要更多真实用户的长期验证。
对于正在寻找法律AI工具的从业者,Pilot5 Legal 提供了一个值得关注的思路:与其追求一个无所不知的AI,不如构建一个敢于质疑、可被审查的AI协作系统。
模型同质化偏差(Model Homogeneity Bias)是多模型架构面临的深层挑战。当前主流前沿大模型(GPT-4、Claude、Gemini等)在训练数据、RLHF对齐方式上存在高度重叠,导致它们在特定问题上可能呈现系统性的一致性错误,而非真正独立的推理分歧。有研究者将这种现象称为"AI同温层"——表面上多个模型达成共识,实则是共同的训练偏差在强化同一个错误方向。真正有效的多模型对抗,需要在模型选型上刻意引入架构差异(如混合使用不同系列的基础模型)和推理策略差异,并在编排层设计能够识别"伪共识"的机制,这对系统设计者的专业能力要求相当高。
相关推荐
Databricks上线Workday Data Connect联邦连接器:Unity Catalog打通HR数据
Databricks宣布Workday Data Connect联邦连接器在Unity Catalog进入公开Beta,支持通过查询联邦直接访问Workday的HR与财务数据,实现统一治理与跨域分析,降低ETL工程负担。
OpenAI DevDay 发布 Codex Cloud:AI 编程走出笔记本
OpenAI 在 DevDay 2026 推出 Codex Cloud、Space 和 dots,让 AI 编程 Agent 彻底摆脱本地笔记本。本文详解云端环境自动配置、私有资源访问、代码审查重构、Slack 协作与 CLI 改版等关键更新。
OpenAI DevDay 2026:ChatGPT Work如何重塑日常工作流
OpenAI DevDay 2026 演讲详解 ChatGPT Work、Space 与 Dots 三款产品,通过社交运营、竞争研究、人力资源三位内部高频用户的真实案例,展示 AI 智能代理如何接管日常工作、重塑知识工作者的协作方式。