评测幻觉:19个攻击家族注册,只有3个真正跑过模型
AI评测工具中,能力注册表≠验证证据,19个攻击家族只有3个真正测过真实模型。
一位机器人VLA策略红队工具开发者发现,自己工具的注册表宣称覆盖19个攻击家族,但实测记录文件中真正与真实模型交过手的只有3个。这揭示了AI评测领域的普遍陷阱:注册表回答"能表达什么",而测量文件才是真正的证据;被拿去宣传的往往是前者,导致营销数字与验证数字严重脱节。作者提出用"新鲜度文件"(freshness file)在公开指标旁标注测量版本,允许系统公开自相矛盾。他坦承自己的版本已落后九个版本,但每次都略过了这个警告——机制有效,慢下来的是人。更值得反思的是,补一次真实测量仅需约三十美分GPU成本,阻碍验证的从来不是资源,而是流程惯性与"注册即完成"的错觉。
当"能表达"被误当成"已验证"
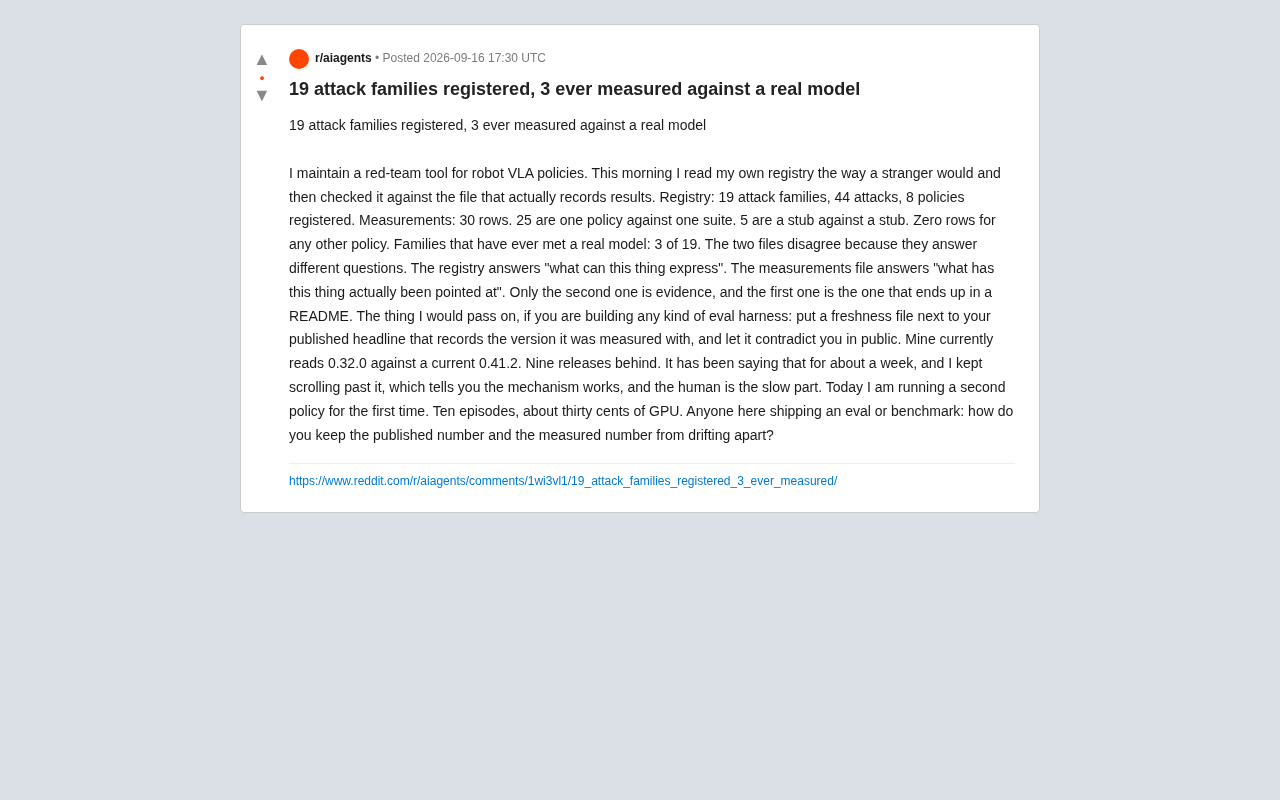
一位维护机器人 VLA(视觉-语言-动作)策略红队工具的开发者,在 Reddit 上分享了一个让人警醒的自查经历。他用陌生人的视角重新审视自己的工具注册表,然后把它和真正记录结果的文件对比,发现了一条几乎所有做评测的人都会踩到的陷阱。
注册表里写着:19 个攻击家族、44 种攻击、8 个策略。听起来相当可观。但真正记录测量结果的文件只有 30 行数据——其中 25 行是同一个策略对同一套测试集,5 行是"桩对桩"(stub against stub,即占位符对占位符)。除此之外,没有任何一行涉及其他策略。真正与真实模型"交过手"的攻击家族,19 个里只有 3 个。
VLA(Vision-Language-Action)策略是近年来机器人领域的前沿范式,将视觉感知、自然语言理解与机器人动作控制统一在同一个模型框架中。其"红队"(Red Teaming)测试借鉴自网络安全领域,指专门构造对抗性输入或场景,试图让模型暴露失败模式、越界行为或安全漏洞。由于 VLA 模型需要在真实或仿真的物理环境中执行动作,其红队测试比纯语言模型更为复杂——除了语义层面的攻击,还涉及视觉扰动、指令歧义、物理约束违反等多个维度。正因如此,"攻击家族"的数量通常被用作评估红队工具覆盖范围的代理指标,但这恰恰埋下了本文所揭示的陷阱:能够分类和描述的攻击类型,与真正执行过并记录结果的攻击,是两回事。
两个文件回答的是两个不同的问题
作者点出了核心问题:这两个文件之所以对不上,是因为它们回答的根本不是同一个问题。
注册表回答的是"这个工具能表达什么"(what can this thing express)——它描述的是能力边界、设计意图、理论覆盖范围。而测量文件回答的是"这个工具实际被指向过什么"(what has this thing actually been pointed at)——它记录的是真实发生过的验证。
关键区别在于:只有第二个文件才是证据。但讽刺的是,最终被写进 README、被拿去对外宣传的,往往是第一个文件里那个漂亮的数字。19 个攻击家族听起来远比"3 个真正测过"更有说服力,于是营销数字和验证数字之间的鸿沟就此产生。
这不是造假,而是一种更隐蔽的自我欺骗——当你反复看着注册表里的能力清单,很容易把"我能做"错当成"我做过"。
一个务实的建议:让"新鲜度文件"公开打你的脸
作者给出的解决方案很有工程智慧:在你对外发布的头条数字旁边,放一个新鲜度文件(freshness file),记录这个数字是在哪个版本下测出来的,并允许它公开地与你自相矛盾。
他自己的新鲜度文件当前显示:测量版本是 0.32.0,而当前版本已经是 0.41.2——落后了整整九个版本。更有意思的是他的坦白:这个文件已经这样显示了大约一周,而他每次都直接划过去没管。
这恰恰证明了机制本身是有效的——自动化的漂移检测在正常工作,慢下来的是人。系统忠实地告诉你数据过期了,但人的惰性让警告失效。这个观察对任何构建评测体系的人都极具价值:机制能暴露问题,但不能强制你行动。所以新鲜度文件必须"公开",让外部压力弥补人的惰性。
版本漂移(version drift)是软件工程中的常见问题,在评测场景下尤为危险。当模型权重、推理框架或测试环境发生变更后,历史测量结果的有效性会逐步衰减,但这一衰减过程通常是隐性的——没有报错,没有警告,只有一个越来越旧的时间戳。"新鲜度文件"本质上是一种显式化的过期声明机制,类似于食品包装上的"最佳赏味期",将隐性的衰减转化为可见的状态差。这种设计在持续集成(CI)体系中有对应实践,例如在流水线中嵌入"指标有效期断言",当当前版本与测量版本差距超过阈值时自动触发警告甚至阻断发布。作者选择让新鲜度信息"公开"而非内部消化,体现了一种将外部问责压力制度化的工程哲学——个人自律的失效,用社会压力来兜底。
三十美分的一次真实测量
帖子结尾,作者提到今天他第一次运行第二个策略:十个 episode,大约三十美分的 GPU 成本。
这个细节耐人寻味。阻碍真实验证的往往不是成本——三十美分几乎可以忽略不计——而是流程上的惯性和"注册即完成"的错觉。当补一行真实测量数据如此廉价,却迟迟没有发生时,说明问题出在优先级和习惯,而非资源。
他最后向社区抛出了一个所有做基准测试和评测的人都该思考的问题:你如何防止已发布的数字和实测的数字发生漂移?
对评测工程的启示
这条来自单一开发者的自省,触及了 AI 评测领域一个普遍痛点。随着模型和工具快速迭代,任何静态的"能力宣称"都会迅速与实际验证状态脱节。几点可以直接落地的实践:
- 区分能力清单与证据清单:README 里的数字应当来自实测文件,而非能力注册表。
- 版本绑定:每一个对外公布的指标都应标注其测量时的版本号。
- 允许系统公开反驳你:新鲜度检测不该被藏起来,要让它成为团队和用户都能看到的"良心"。
- 降低验证的摩擦:当补测成本低到三十美分,就没有理由让宣传数字长期悬空。
评测工具的价值,最终不在于它"声称"能测什么,而在于它"真正"测过什么。这条帖子提醒我们:在 AI 快速迭代的当下,诚实的第一步,是让你的数字敢于当众打脸自己。
相关推荐
多智能体SOC应用的LLM选型策略:规则路由还是LLM自主决策?
在 LangGraph 多智能体 SOC 应用中,LLM 选型应采用规则路由还是让 LLM 自主决策?本文分析两种方案的权衡,并给出适合安全运营场景的混合路由策略建议。
Snap再推2200美元智能眼镜,能否说服市场?
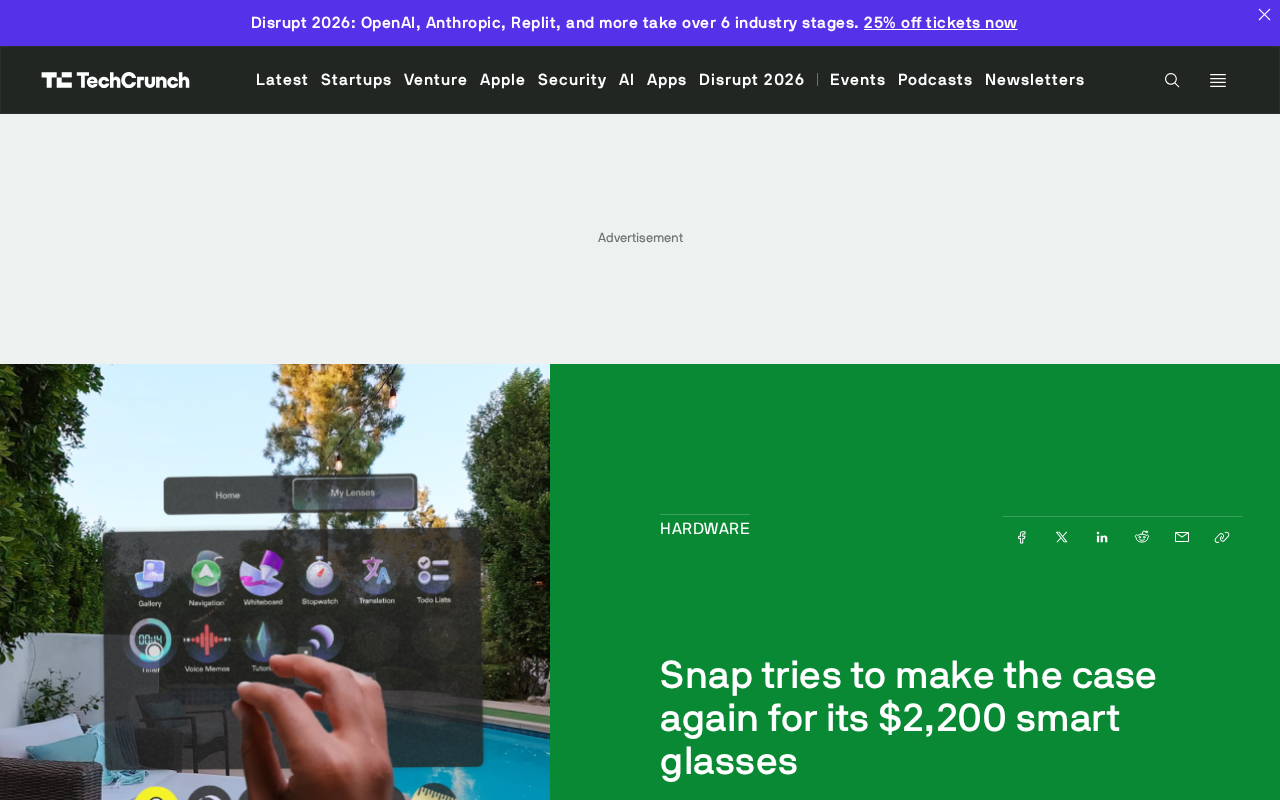
Snap本周为其售价2200美元的智能眼镜发布新功能,再次尝试证明产品价值。本文分析Snap智能眼镜的定价困境、市场定位及其在AR眼镜赛道的行业意义。
Vercel AI SDK 更新:阿里巴巴模型支持多轮推理保留
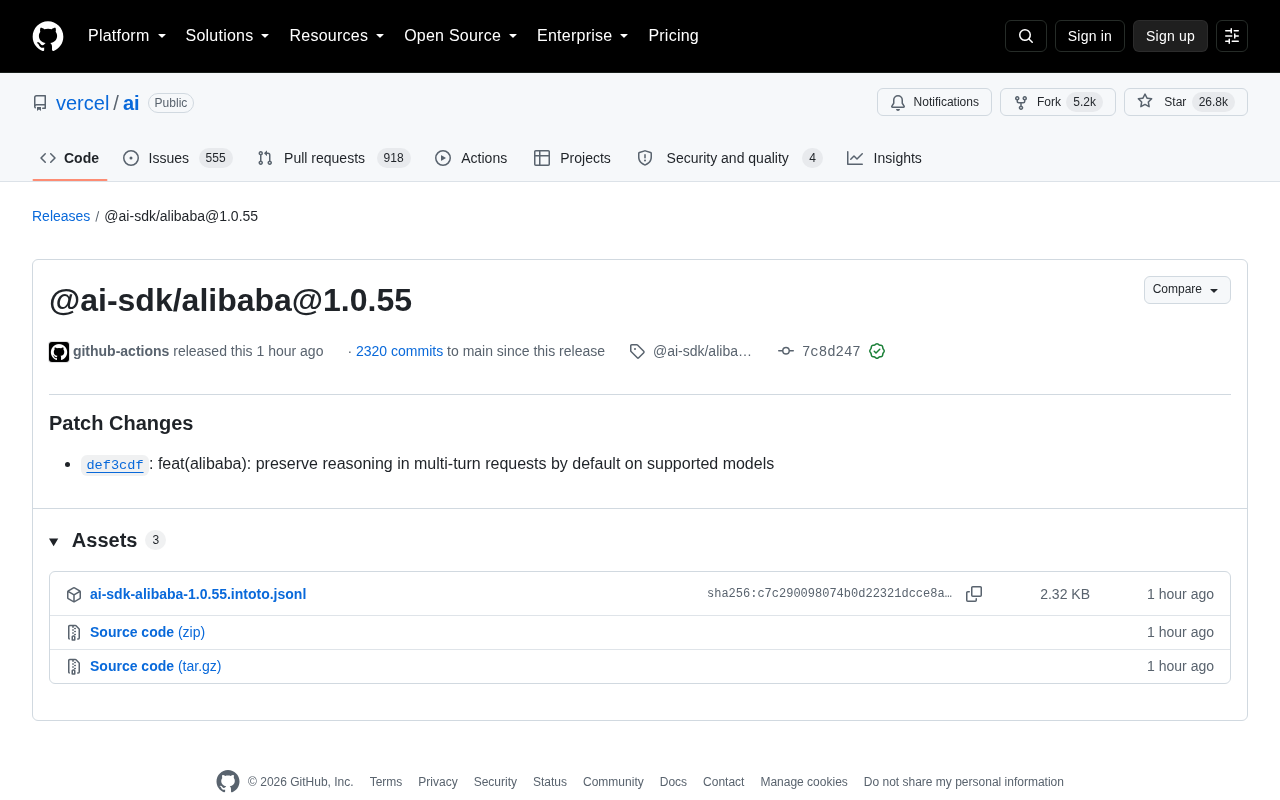
Vercel AI SDK 发布 @ai-sdk/alibaba@1.0.55 补丁更新,为阿里巴巴受支持模型默认启用多轮请求中的推理保留(reasoning)能力,优化多轮对话与 Agent 场景体验。本文解析该更新的核心变化与开发者应对建议。