评测者不谈可靠性,车主却提及两倍:一个被忽视的选车维度
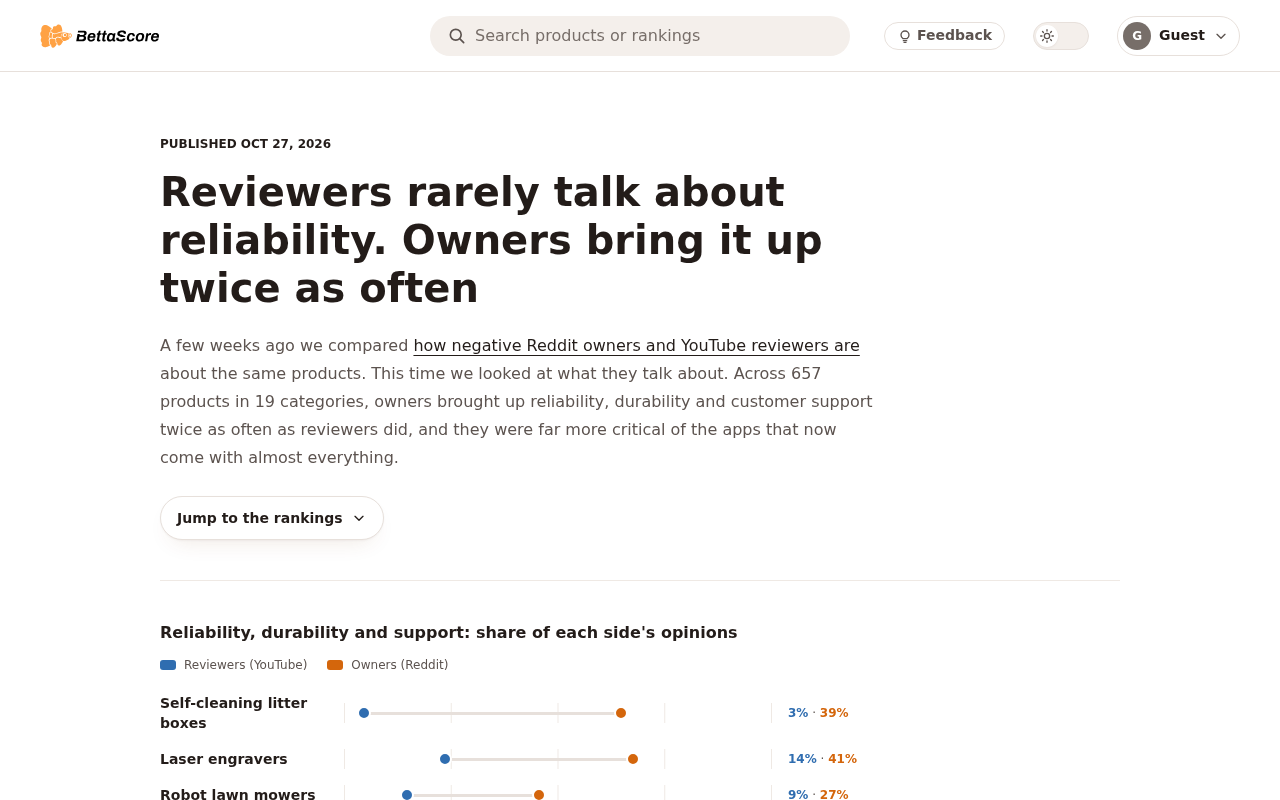
评测者与车主对可靠性的提及频率相差一倍,揭示短周期评测与长期拥车体验之间的结构性偏差。
文章从 Hacker News 上一条低热度帖子出发,指出评测者极少讨论可靠性,而车主的提及频率约为其两倍。作者分析这一偏差的成因:评测多发生在发布后数天至数周,缺乏长期样本与故障率数据,且商业激励偏向可量化、可传播的首因体验,可靠性因此被默认推迟。车主口碑则围绕维修次数、异响、软件卡顿与售后响应,构成另一套评价坐标系。作者据此提出选购科技产品的原则:评测参考能力上限,老用户口碑参考长期下限,主动检索三个月后的长周期反馈,并警惕评测中集体沉默的维度。同时提醒原始帖子缺乏数据来源与样本界定,应作为观察引子而非研究结论。
一个被数据暴露的认知鸿沟
Hacker News 上一条只有 8 分、6 条评论的帖子,标题却抛出了一个值得玩味的观察:评测者极少讨论可靠性,而车主提及它的频率是评测者的两倍。
这句话没有点名任何品牌或车型,也没有给出统计口径,但它精准戳中了一个长期存在的结构性偏差——专业评测的叙事框架,与真实拥车体验之间,存在一条不小的裂缝。
对于关注 AI 与科技产品的人来说,这个现象并不陌生。它同样适用于手机、笔记本、SaaS 工具,甚至大模型产品:发布时的参数与体验评测,和用了一年之后的稳定性感受,往往讲的是两件事。
评测者为什么天然回避可靠性
评测的商业模式决定了它的时间尺度。多数评测发生在产品发布后的数天到数周内,评测者手上只有一台样机,没有长期使用的样本,也没有维修记录和故障率数据。可靠性恰恰是一个需要时间沉淀、需要大样本才能讨论的维度。
另一层原因在于激励结构。评测内容需要可看、可读、可比较,加速成绩、屏幕素质、交互流畅度这类指标容易量化、容易形成结论;而“这台车开了三年没出过大毛病”既缺乏戏剧性,也难以归因。
于是评测自然滑向首因体验,可靠性被默认为“以后再说”的问题。但它并不会因为不被讨论而消失,只是转移到了车主的口碑渠道里。
首因体验(first impression experience)是指用户在接触产品最初阶段形成的感受与判断,通常集中在开箱、初次设置和头几天的使用上。社会心理学中的首因效应(primacy effect)表明,最早获得的信息对整体印象的权重远高于后续信息,这也解释了为什么发布初期的评测容易形成并固化公众认知。对产品评价而言,首因体验天然偏向可感知的设计、性能与交互,而把耐久性、故障率这类需要时间暴露的维度排除在外。评测者若只依赖首因体验,其结论在传播上高效,却系统性地高估了产品的长期表现,这也是首发口碑与长期口碑经常出现落差的原因之一。
车主的口碑为何是另一个坐标系
车主谈可靠性,谈的是维修次数、异响、软件卡顿、售后响应速度,以及那些在长周期里反复出现的小毛病。这些内容不具备评测的传播效率,却构成了真实的拥车成本。
这条帖子之所以能引起讨论,正是因为它把一个模糊的直觉变成了可比较的表述:同一件事,两类人群的提及频率相差一倍。这种差异不是谁对谁错,而是两套评价体系在关注不同的东西。
放到科技产品上,逻辑同样成立。首发评测里很少有人讨论“两年后系统更新是否还跟得上”“电池衰减到什么程度”,而老用户社区里这些是高频话题。
拥车成本(cost of ownership)是一个来自汽车行业的分析框架,指用户在持有期间发生的全部支出,包括购车价之外的保养、维修、保险、能耗、折旧以及因故障造成的停工与时间成本。它的关键价值在于把一次性购买决策转化为全生命周期的现金流视角。迁移到科技产品上,对应的是订阅费、配件更换、维修与数据迁移等隐性支出。评测通常只覆盖购置成本与短期体验,而拥车成本恰恰由可靠性主导,这也解释了为何车主对可靠性更敏感:他们承担的是长期账单,而非一次性体验。
对科技产品购买的启示
如果把这条观察迁移到 AI 工具和硬件选购上,可以提炼出几条实用原则。
其一,把评测当作能力上限的参考,把车主或老用户口碑当作长期下限的参考,两者不可互相替代。
其二,主动去搜长周期反馈。发布三个月后的用户讨论、售后论坛的故障帖,往往比首发评测更能说明问题。
其三,警惕“评测真空”领域。当某个维度在评测中几乎不被提及,它未必不重要,可能只是不方便说、没时间说。
生存者偏差(survivorship bias)是解读用户口碑时必须警惕的陷阱。愿意在社区长期发言的往往是使用顺利或问题已解决的用户,而那些因故障彻底弃用的用户早已退出讨论,导致口碑样本系统性偏向正面。因此在检索长周期反馈时,应优先查看售后论坛、投诉平台和二手交易平台的转手理由,这些渠道更可能保留负面样本。同时要注意样本规模与时间窗口:几条零散的故障帖不足以说明可靠性,但同一问题在多个独立渠道反复出现,则构成值得重视的信号。
一句话的局限与价值
需要承认,这条帖子本身信息量有限:没有说明数据来源、样本规模,也没有界定“可靠性”具体指什么。它更像一个引子,而不是一份研究结论。
但它提出的问题足够锋利。在信息过载的产品评价环境里,谁在说话、说了什么、没说什么,本身就是一种值得解读的信号。评测者的沉默和车主的重复提及,共同构成了一个产品完整画像的两面。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。