PinSay:为 AI Agent 打造的 MCP 代码评审工具
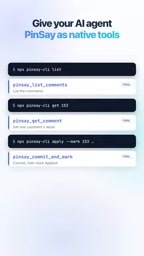
PinSay 是将代码评审动作封装为 MCP 工具的 AI Agent 工具集,强调读写分离、人类最终把关与安全边界。
PinSay 是一套基于 MCP(Model Context Protocol)协议的工具集,专为让 AI Agent 参与代码评审工作流而设计。它通过用户级配置接入,不污染团队仓库。工具分为读操作(获取评论列表、待处理队列及源文件)和写操作(提交修改、标记已应用、回复评论)两类,但写操作被明确约束为永不执行 push,将最终发布权留给人类。在安全设计上,PinSay 将评论文本视为不可信数据以防范提示词注入攻击,并以结构化错误码而非自然语言返回错误信息,提升自动化流程的健壮性。整体设计哲学是在增强 Agent 能力的同时,通过明确的边界约束保持人类对关键操作的控制权。
PinSay 是什么
PinSay 是一套面向 AI Agent 的 MCP(Model Context Protocol)工具集,核心定位是让 AI 编程助手能够直接参与代码评审(code review)的工作流。它的理念可以用一句口号概括:PIN it, Say it, Your agent ships it——标记问题、留下评论、让你的 Agent 完成交付。
与其把评审意见零散地散落在聊天框里,PinSay 把评审动作封装成一组标准化的 MCP 工具,直接挂接到 AI Agent 的能力当中。开发者只需把配置写进 Agent 的 MCP 设置里,Agent 就能像人类评审者一样读取评论、回复评论、标记问题已解决。
MCP(Model Context Protocol)是由 Anthropic 于 2024 年底提出的开放协议,旨在标准化 AI 模型与外部工具、数据源之间的交互方式。其核心思想是为 AI Agent 提供一套统一的「工具调用接口」,让模型能够以一致的方式调用文件系统、数据库、第三方服务等能力,而无需为每个集成单独定制。目前 Claude、Cursor、Windsurf 等主流 AI 编程助手均已支持 MCP,开发者只需在配置文件中声明工具集地址,助手便能发现并调用对应工具。PinSay 正是以 MCP 工具集的形式存在,这意味着任何兼容 MCP 的 Agent 都可以低成本接入,不依赖特定平台或私有 API 协议。
如何接入
接入方式非常轻量:把 PinSay 提供的 config 配置添加到用户级别(user-level)的 MCP 设置中,而不是项目级别。这样做的好处是工具跟随开发者个人环境走,不需要为每个仓库单独配置,也不会被提交(commit)到代码库里,避免把个人工具链污染进团队共享的项目配置。
这种“用户级而非项目级”的设计是一个值得关注的细节。它表明 PinSay 把评审工具视为开发者的个人生产力扩展,而不是项目的一部分依赖,减少了团队协作中因配置差异带来的摩擦。
工具分为读与写两类
PinSay 的工具集清晰地划分为读操作和写操作两组,这种职责分离的设计让 Agent 的行为边界更可控。
读操作
读操作主要用于获取评审上下文,包括 list comments(列出评论)和获取待处理队列(queue),以及拉取已解决(resolved)项对应的源文件内容。换句话说,Agent 可以先“看懂”当前有哪些评审意见、哪些已经处理、涉及哪些源代码,再决定下一步动作。
写操作
写操作则赋予 Agent 真正的执行能力:它可以 commit(提交修改)、把评论标记为 applied(已应用)、以及对评论进行 reply(回复)。
关键的安全约束在于:写操作永远不会执行 push。也就是说,Agent 能在本地完成提交和评审回应,但不会主动把代码推送到远程仓库。这道“护栏”把最终的发布控制权牢牢留在人类手里,是一个相当克制且负责任的设计选择。
把评论当作不可信输入
PinSay 在安全模型上有一个明确的立场:评论的文本内容被视为不可信数据(untrusted data)。
在 AI Agent 直接读取外部文本并据此采取行动的场景下,这是极其重要的防护思路。评审评论可能来自任何人,其中可能夹带诱导 Agent 执行危险操作的提示词注入(prompt injection)。PinSay 把评论文本标记为不可信,意味着 Agent 不应盲目把评论里的指令当作可信命令执行,从而降低被恶意注入攻击的风险。
此外,PinSay 还规定错误以错误码(error code)的形式返回,而非含糊的自然语言描述。结构化的错误返回让 Agent 更容易判断调用是否成功、失败原因是什么,并据此做出可靠的后续决策,这对自动化流程的健壮性至关重要。
提示词注入(Prompt Injection)是 AI Agent 场景下的主要安全威胁之一。攻击者通过在 Agent 会读取的外部内容(如网页、文档、代码注释、评审评论)中嵌入伪装成系统指令的文本,诱导 Agent 执行超出预期的操作——例如泄露凭证、删除文件或向外发送请求。与传统 SQL 注入类似,问题根源在于「数据」和「指令」没有被严格区分对待。在代码评审场景中,评论作者可以是任何团队成员甚至外部贡献者,内容完全不可控,因此将其标记为不可信输入并在 Agent 处理链路上加以隔离,是防范此类攻击的必要措施。OWASP 已将 Prompt Injection 列为 LLM 应用的首要安全风险(LLM Top 10 第一位)。
设计理念小结
从披露的信息来看,PinSay 的几个设计取舍传递出一致的工程哲学:
- 轻量接入:用户级配置,不污染仓库。
- 读写分离:职责清晰,行为可预期。
- 人类最终把关:绝不自动 push,发布权留给人。
- 安全优先:评论视为不可信输入,错误以结构化码返回。
这套工具瞄准的是一个正在快速成熟的领域——让 AI Agent 从“写代码的助手”进化为“能参与评审闭环的协作者”。在 Agent 自主性不断增强的趋势下,像 PinSay 这样强调边界与安全约束的工具设计,比单纯追求“全自动”更值得借鉴。
需要说明的是,本文基于一段来源有限的介绍性素材整理,关于 PinSay 的具体支持平台、定价与完整工具列表仍需参考官方文档进一步确认。
相关推荐
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。
Mia Goth怒斥Instagram放任AI假图:认证账号也难逃AI伪造
Mia Goth发现一张AI生成的假图通过Instagram蓝V认证账号广泛传播,她公开质疑平台为何未能拦截。此事暴露了社交平台认证体系在应对AI伪造内容时的结构性漏洞。
Google 让 Vibe-Coded 应用一键上架 Play Store
Google 在美国推出新功能,允许开发者将 AI Studio 中 vibe-code 的个人应用直接通过 Play Store 发布,无需连接电脑侧载安装。本文分析这一功能对个人开发者的影响、AI 编程工具竞争格局的变化,以及审核机制等潜在问题。