破解PS5跑Llama.cpp:主机原生运行GGUF大模型

开发者越狱后在PS5上跑通Llama.cpp,验证了轻量推理框架的跨平台可移植性极限。
有开发者在越狱后的PS5上成功编译运行Llama.cpp,使这台游戏主机能原生加载GGUF格式的大语言模型。PS5基于FreeBSD的系统与POSIX的良好兼容性、AMD Zen 2八核CPU加RDNA 2 GPU与16GB GDDR6统一内存,是这次移植得以实现的基础。得益于统一内存架构,7B至13B的量化模型理论上可直接加载,无需在CPU与GPU间反复拷贝权重。但受限于RDNA 2缺乏通用计算驱动支持,推理大概率以CPU为主,速度与散热都存在明显约束。该实验的象征意义大于实用价值:它展示了Llama.cpp跨操作系统与硬件架构的可移植边界,也揭示了端侧AI部署的真正瓶颈往往在驱动与计算后端适配。
当游戏主机变成AI推理平台
一条来自Hacker News的讨论帖引发了技术圈的关注:有开发者成功在越狱后的PS5上运行了Llama.cpp,让这台索尼游戏主机能够原生加载并推理任意GGUF格式的大语言模型。
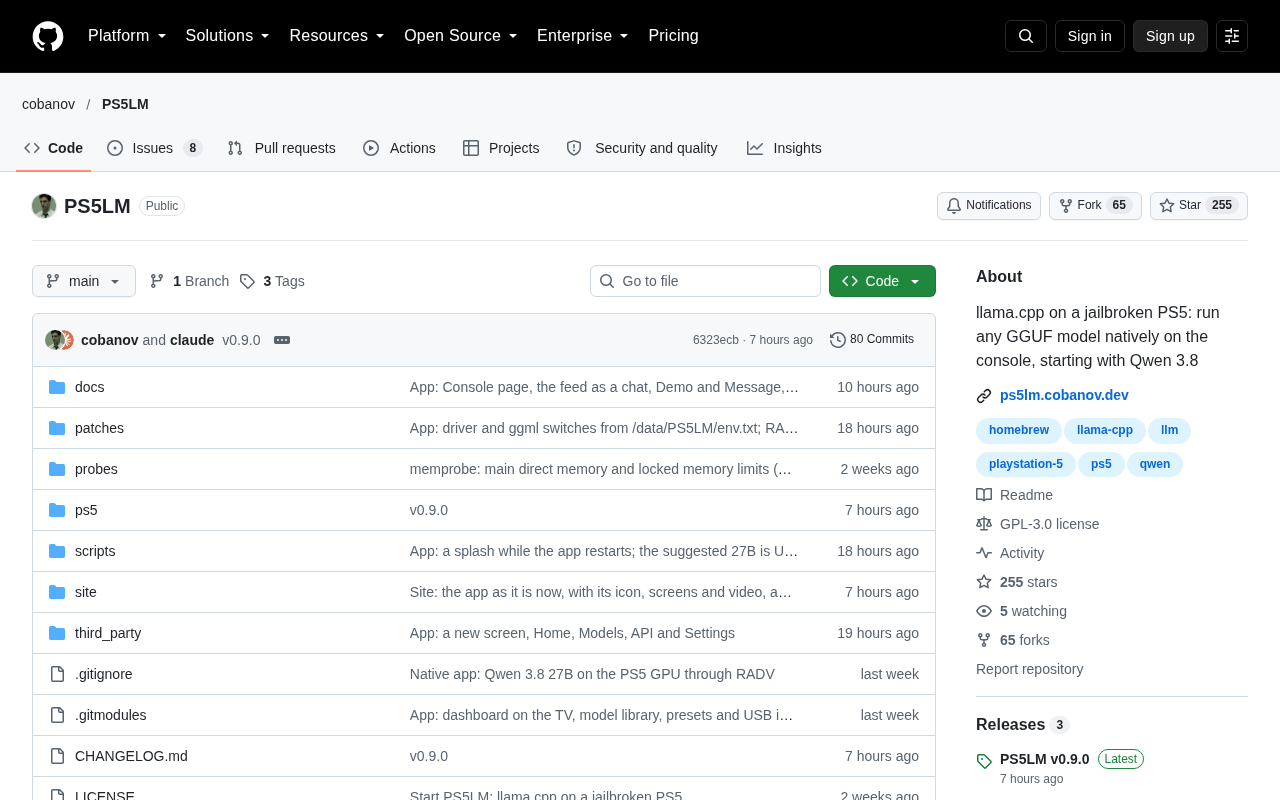
Llama.cpp是Georgi Gerganov开发的轻量级LLM推理框架,以纯C/C++实现、极低的依赖门槛著称。它支持GGUF(GPT-Generated Unified Format)模型格式,能在从树莓派到高端工作站的各类硬件上运行量化后的模型。而PS5的硬件配置——定制的AMD Zen 2八核CPU和RDNA 2架构GPU,配合16GB GDDR6统一内存——从纸面参数看,确实具备运行中等规模量化模型的潜力。
技术路径:FreeBSD底层的意外便利
PS5的操作系统基于FreeBSD内核构建,这一点在此次移植中起到了关键作用。Llama.cpp本身对POSIX环境有良好的兼容性,FreeBSD与Linux在系统调用层面的相似性,使得编译移植的难度远低于从零适配一个专有平台。越狱后的PS5开放了对底层系统的访问权限,开发者得以部署编译工具链、配置运行环境,并最终让Llama.cpp在这套非标准硬件上跑起来。
GGUF格式的支持意味着用户可以直接加载社区中大量现成的量化模型——从7B到13B参数级别,根据量化精度的不同,对内存的占用可以从几GB到十几GB不等。PS5的16GB统一内存架构在这里反而成为一个优势:CPU和GPU共享同一块内存池,模型权重无需在设备间反复拷贝。
GGUF 与量化简述:GGUF(GPT-Generated Unified Format)是 llama.cpp 主导推出的模型容器格式,取代了早期的 GGML。它把模型权重、分词器、超参数打包进单个文件,并支持元数据自描述,因此 llama.cpp 能直接加载不同来源的模型而无需额外配置。GGUF 的关键在于“量化”——将原本 FP16 的权重压缩为 4-bit、5-bit、8-bit 等低精度整数表示,配合分组缩放因子尽量减少精度损失。常见的 Q4_K_M、Q5_K_M 等命名即描述量化等级与算法。以 7B 模型为例,FP16 权重约需 14GB 显存,而 Q4 量化后仅约 4GB 左右,13B 亦能控制在 8-10GB。量化让大模型得以塞进消费级硬件的内存预算,但也会带来一定的推理质量下降,需要在速度、显存与效果之间权衡。
性能预期与现实约束
需要冷静看待的是,PS5的GPU(RDNA 2)并非为通用计算设计,其CUDA等价物——AMD的ROCm——在游戏主机环境中的可用性存疑。Llama.cpp虽然支持多种GPU后端加速,但在PS5上大概率是以CPU推理为主。
这意味着实际推理速度可能并不理想。作为参照,在类似性能的桌面CPU上,7B Q4量化模型的生成速度大约在每秒几个token到十几个token之间。PS5的Zen 2核心在游戏负载下表现优异,但面对持续的大模型矩阵运算,散热和功耗墙会成为限制因素。
另一个不确定因素是内存分配。虽然16GB GDDR6看似充裕,但系统本身需要占用一部分,实际可供模型使用的内存可能低于预期。运行13B以上的模型时,可能需要依赖更激进的量化策略。
统一内存架构(UMA)的意义:传统 PC 中 CPU 使用 DDR 内存、GPU 使用独立显存(VRAM),模型权重若要在 GPU 上计算,必须通过 PCIe 总线拷贝到显存,带宽成为瓶颈,也让显存容量限制模型规模。PS5 采用 16GB GDDR6 统一内存,CPU 与 GPU 共享同一物理内存池,理论上模型权重只需加载一次,GPU 可直接访问,省去反复拷贝的开销。这一架构正是 Apple Silicon(M 系列芯片)能在本地运行大模型的重要基础。不过 UMA 也意味着同一块内存要同时服务于系统、图形渲染与模型推理,可用额度会被系统和其他进程挤占;加上 GDDR6 的带宽虽高于 DDR,却仍不及高端独立显卡的 HBM 或 GDDR6X,因此推理速度仍受带宽上限约束。
ROCm 与 GPU 通用计算的生态壁垒:AMD 的 ROCm 是其在通用计算领域对标 NVIDIA CUDA 的开源平台,提供 HIP 编程接口与 BLAS、cuDNN 等价库。llama.cpp 已支持通过 HIP/ROCm 后端调用 AMD GPU 加速,但在消费级显卡上 ROCm 的官方支持范围本就有限,在游戏主机这类定制硬件上更是几乎不存在——PS5 的 GPU 驱动、固件与 API 均为索尼私有,未开放通用计算接口。因此即便 RDNA 2 的算力在理论上远超 CPU,实际也缺少可用的软件栈把算力释放出来。这也是本实验“只能以 CPU 为主”的根本原因,同时也解释了为什么“打通 GPU 计算路径”被认为是此类项目未来最有想象空间的突破口。
为什么这件事值得关注
抛开"能不能用"的实用性问题,这个项目的象征意义更大。它展示了Llama.cpp作为推理框架的可移植性极限——当一个为CPU推理优化的轻量级框架能够跨越操作系统和硬件架构的边界时,AI推理的部署场景就被进一步拓宽了。
从技术社区的反应来看,这类实验的价值在于验证可行性边界。游戏主机拥有强大的异构计算能力和统一内存架构,如果未来能够打通GPU计算路径,理论上可以成为低成本的本地推理节点。当然,越狱本身的法律和安全风险,以及缺乏官方支持的脆弱性,都让这条路线目前只停留在实验阶段。
对于关注端侧AI部署的开发者而言,这个案例提供了一个有趣的参考:在非标准硬件上运行LLM,瓶颈往往不在框架本身,而在于驱动层和计算后端的适配。Llama.cpp的C++实现和最小依赖设计,使它成为这类探索的理想起点。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。