论文精读·第9期:量子代码测试、空间心智化与工具检索可靠性
论文精读·第9期:量子代码测试、空间心智化与工具检索可靠性
每周二精选本周最值得读的AI论文,深入解析问题/方法/改进
每周二精选本周最值得读的AI论文,深入解析问题/方法/改进
又到了每周论文精读时间。李博,这周我翻了翻arXiv,信息量有点大。量子代码、空间推理、智能体工具检索,方向挺散的。
看着散,其实有条暗线。这周好几篇都在问同一个问题:模型知道自己不知道吗,知道自己的输出靠不靠谱吗。
这个角度有意思。那我们就顺着这条线聊,先从最出乎我意料的那篇开始,量子代码测试。
好,第一篇,QTestBench。它要解决的是,大模型能不能给量子程序写单元测试。注意啊,不是写量子代码,是写测试。
等一下,写测试不是比写代码简单吗?为什么量子这块就难了?
重点就在这。量子程序是概率性的,还依赖数值容差,判定标准是领域专用的检查器。所以一个格式完全正确的测试,结论可能跟基准完全相反。
也就是说测试能跑通,不代表它真能区分对的实现和错的实现。
对,他们把测试本身就当成了被评测对象。跑八个PennyLane挑战,十个Qiskit任务,生成的测试几乎都能执行,但真正抓 bug 的能力差很多。
具体差到什么程度?
最好的生成器,QHack上测试质量只有0.71,Qiskit上掉到0.34。所以能跑通这件事,严重高估了测试的真实水平。
这个结论我挺认同的。我们做AI产品评测也踩过坑,任务能完成,不等于它理解了这个任务。
而且他们还发现,自然出现的错误解太少了,所以用合成变异体来稳定估计。这跟你们做评测时数据不够就造数据是一个思路。
总结一下这篇的价值:评测AI生成测试,得看判别力,不能只看能不能跑。那第二条呢?
第二条,结构自动机那篇。它讲的是语义解析里,模型逐token生成,但合法与否取决于引用和作用域,这些是生成过程中才展开的。
这不就是约束解码吗?不让它生成不合法的token。
你说的没错,但这里有个关键点。局部遮罩只能防当下非法,它不保证剩下的长度还够不够把一个合法前缀补完。
所以模型可能前面走得挺顺,走到一半发现没路可走了。
对。他们提出接受路径解码,每一步都保证还有一条走到终点的路。而且它不撤销已经生成的token。
不撤销还能保证合法,怎么做到的?
它优先跟随模型想选的token,只要那个token还能被补完就行。只有走不通时才退而求其次。在长度吃紧时,DRS上比局部遮罩高5.1分。
这个思路其实很工程。就像导航,不是等你拐错了再重算,而是每条路都给你留着出口。
这个类比挺准。他们还发现,无效输出其实集中在同一批输入上。训练数据少的时候,八个采样没一个合法,占10.2%,数据全了才0.4%。
所以问题不在采样运气,是输入本身难度分布不均。这条总结一下:结构化约束要从解码、后处理、训练三头一起抓。
第三条,我觉得是这周最惊艳的。SpatialASM,让视觉语言模型学会主动换视角想问题。
主动换视角?你解释一下。人看图的时候,确实会在脑子里转一下,从别的角度看看。
对,他们管这叫主动空间心智化。现在的视觉语言模型基本是被动看图,不会自己重新观察。他们用一个新视角生成器,把假想视角锚定在真实视觉证据上。
所以是教模型什么时候该转视角,怎么转?
没错,给了两种监督。一种是显式的轨迹,教它何时调用视角规划;另一种是透视任务,强化以视角为条件的场景想象。
效果呢?在四个模型骨架上都有提升?
对,七项空间基准平均准确率提升,而且原来的通用视觉能力没掉。这点很关键,专项增强不能以牺牲通用能力为代价。
那第三条和第二条其实是一回事的两面,一个管输出的合法性,一个管推理的可靠性。
对,而且都指向同一个趋势:模型得对自己的生成过程有元认知。那第四条,把这条暗线收得最狠。
是不是那篇讲模型该不该放弃回答的?标题我就被吸引了。
就是它。用一个分数,答对加分,答错扣分,放弃不加不减。然后在Qwen3-14B上比两种方案,改模型本身,还是加一个回答选择器。
结果呢,哪个赢?
选择器赢。在TriviaQA上,覆盖率从20.2%提到30.9%,而且有效回答里的错误率从23%降到14.5%。
覆盖率涨了,错误率还降了,两个指标同时变好,这可不容易。
对,但重点在后面。强化学习那套没带来稳定提升。而且在NQ-Open上,选择器虽然比置信度过滤好,但还是不如干脆啥都不答。
也就是说,可靠地弃答这件事,换个数据集就不成立了。这个诚实的结论我很欣赏。
第五条也说这类问题,智能体的工具检索。现在检索只看语义相关,不管工具当时是不是挂了。
这不就是我线上做agent最头疼的事吗,语义上最匹配的工具,结果接口挂了,整个流程就崩了。
所以他们搞了RATED,语义匹配加一个轻量上下文老虎机,用实时执行反馈来重排候选。核心是能快速适应运行时故障,不用重训模型。
老虎机这个词有点吓人,其实就是在试错中调整偏好?
对,就是动态调权重。效果很硬。真实查询上MRR相对提升52.2%,严重故障时,选错工具的比例从86.2%压到2.9%,延迟只多了不到1毫秒。
86%掉到3%,这个数字有点夸张。等于把一个经常翻车的系统拉到了基本可用。
对,而且他们还开源了EcoAgent基准,5172个真实工具,21万多对查询。这个对做agent的人来说是直接的资产。
这条收一下:工具检索必须把运行时的可靠性算进去,静态的语义相似度已经不够用了。
最后聊个轻松的。有篇论文让语言模型玩维基百科游戏,只能用文章链接跳到目标页。
这个游戏人玩就很上瘾。结果呢,模型比人强吗?
没有任何模型显著超过人类。最好的几个,像o3mini、GPT-4o、QwQ和DeepSeek广告-R1,只是跟人打平。而且不同语言和主题上的排名还会变。
这个结论其实挺冷静的。检索导航这种能力,可能光堆参数不解决,得换个范式。
对,而且他们建了超大的本地维基图,不依赖第三方API。这本身就是个实用的基础设施。
那今天聊下来,几条线其实收敛到一个判断了。
对,2026年下半年这一批研究,主题已经不是把模型做大了,是让模型变得可信、可验证、知道自己的边界。
测试要能判别,解码要保证合法,推理要会换视角,回答要会弃权,工具要会避险。说到底都是同一件事。
就是模型的自我认知。它对自身能力的估计,可能比它单点能力再涨10分更重要。
这个判断我记住了。今天就到这儿,下期见。
相关推荐
 科技前沿
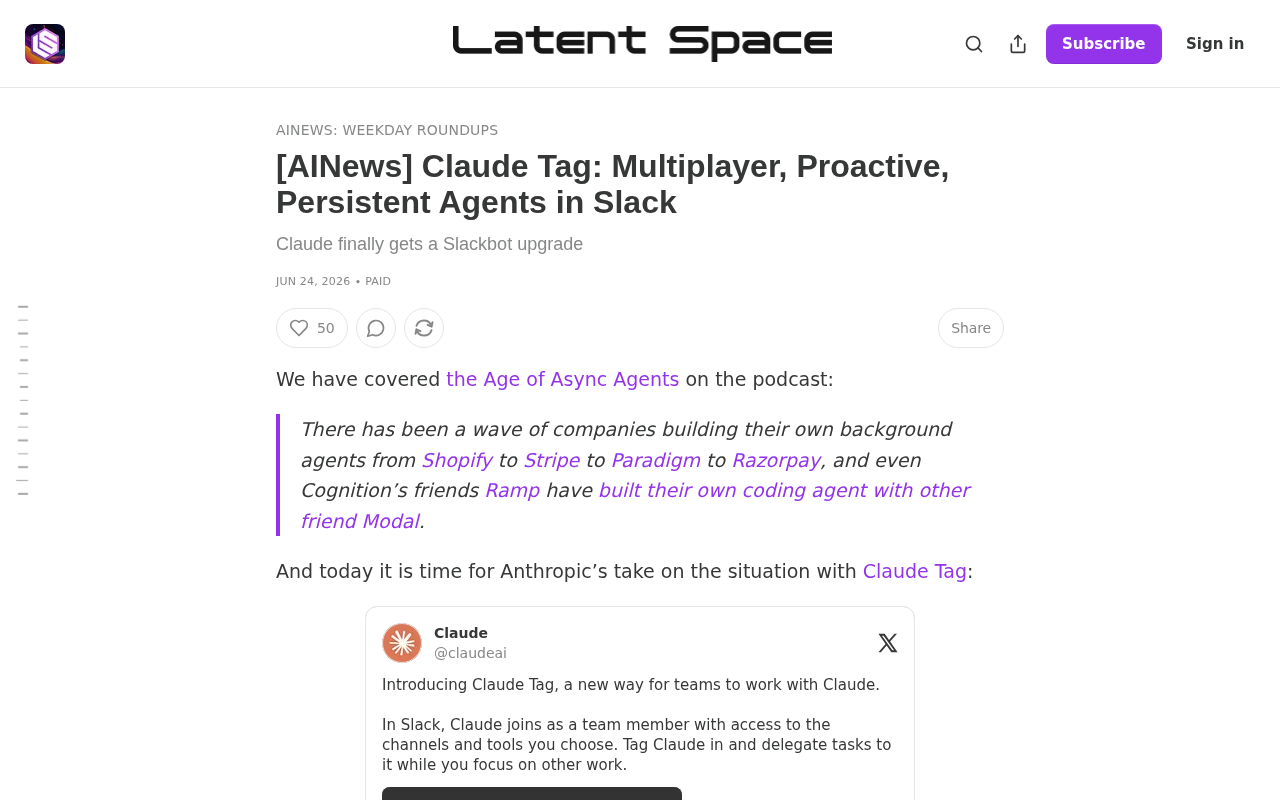
Claude Slack智能体升级:多人协作、主动响应与持久记忆全解析
Anthropic为Claude推出Slack集成重大升级,新增多人协作、主动响应和持久记忆三大核心能力,将AI从被动问答工具转变为真正的团队协作伙伴,重新定义企业级AI智能体应用标准。
 科技前沿
AI行业罕见平静日:递归自我改进暗流涌动
AI领域迎来罕见的平静一天,多个资讯源集体沉默。但平静背后,递归自我改进(RSI)研究仍在持续推进。解读AI行业发展节奏与从业者应对策略。
 科技前沿
In the Weights:查看你在AI领域的影响力权重分数
In the Weights 是一个AI领域个人影响力搜索引擎,通过量化评分衡量你在人工智能世界中的存在感。了解这个工具如何评估AI从业者的多维度影响力,以及它背后关于数字身份的深层思考。