Policy Lens:用本地AI拆解保险条款的「隐藏陷阱」

开源工具 Policy Lens 用本地大模型解析保险 PDF,识别除外条款并支持问答。
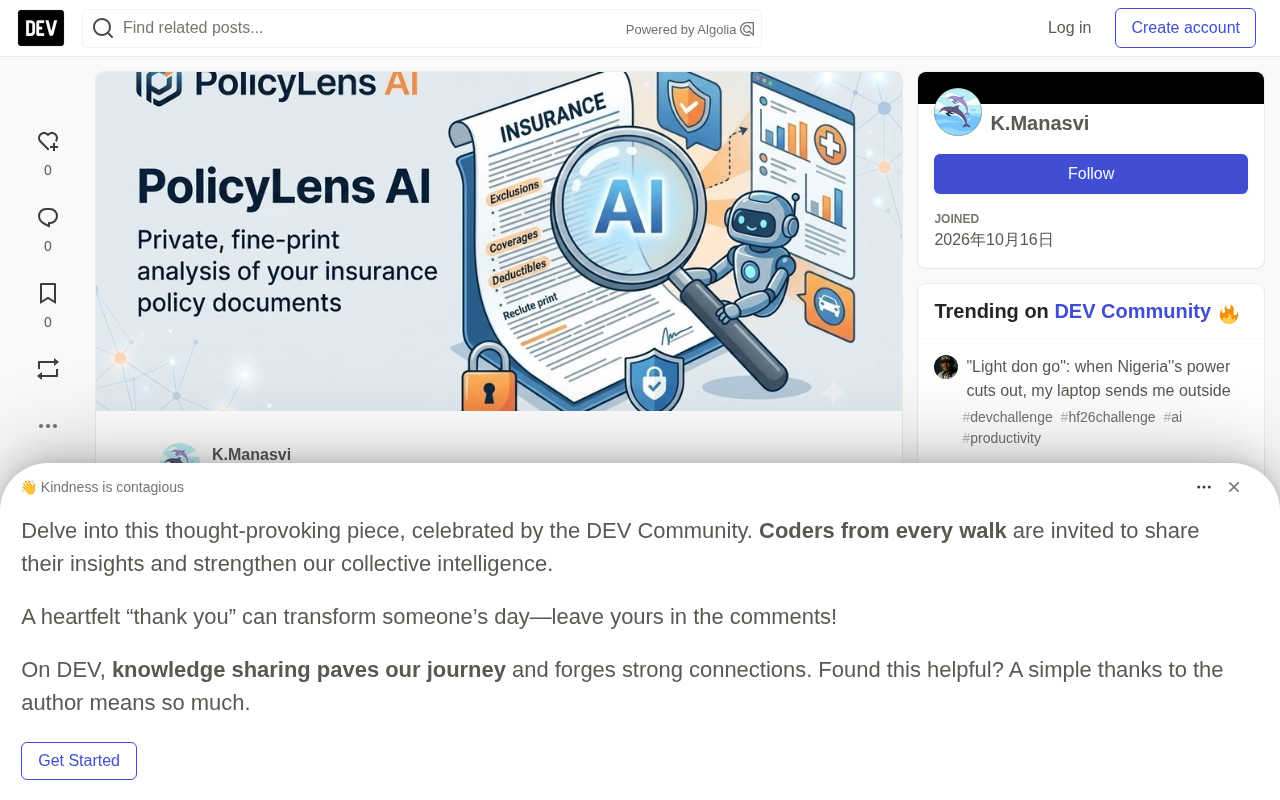
Policy Lens 是开发者 manjushapirati030 在 Hacktoberfest 开源AI挑战赛中提交的项目,旨在用本地大模型解决保险合同「天书条款」带来的信息不对称问题。它支持上传健康险、寿险、车险等 PDF 保单,自动提取保额、免赔额、共付额、等待期等关键参数,重点扫描隐藏的除外责任与拒赔风险点,并允许用户就自己保单的具体内容进行问答。技术栈上采用 Ollama 驱动 Gemma 模型完全本地运行,敏感文件不出本机,满足强监管行业的合规要求。商业化路径分三层:面向保险经纪和财务顾问的 B2B 订阅(29-99 美元/月)、面向个人的单次报告微交易(5-10 美元)以及区域机构的私有部署授权。主要挑战是 PDF 格式多样性对提取准确率的考验,以及 AI 误判可能对用户决策产生的负面影响。
保险合同的「天书条款」一直是消费者的噩梦——你以为买了全险,理赔时才发现有一堆除外责任等着你。开发者 manjushapirati030 在 Hacktoberfest 开源AI挑战赛中提交的 Policy Lens,试图用本地大模型把这件事自动化。
它解决什么问题
保险条款的复杂程度并非偶然。Policy Lens 的作者在项目说明中直言:保险合同「故意用复杂的法律术语写成」,导致消费者误以为自己拥有某项保障,实际上并没有。这种信息不对称正是保险公司控制赔付率的工具。
另一个痛点来自从业者。保险经纪人和财务顾问需要逐页阅读 50 页以上的保单文件来评估保障范围或做产品对比,这个过程往往耗费数小时。Policy Lens 希望把这类重复性的「细读」工作交给 AI。
隐私问题同样关键。保单包含个人健康、财务等高度敏感信息,上传到云端 AI 服务存在合规风险。Policy Lens 选择完全本地运行,这在保险和医疗这类强监管行业中是刚需。
核心功能拆解
文档解析与结构化提取
Policy Lens 支持上传健康险、寿险、车险、财产险等 PDF 保单,自动提取保额上限、共付额(co-pay)、免赔额(deductible)、等待期等关键参数。这些数据是判断一份保单实际价值的基础——很多人只看保费和保额,忽略了免赔额和等待期对实际理赔的影响。
除外责任与「红旗」检测
这是整个工具最有价值的部分。它会自动扫描合同,标注出隐藏的除外条款、限制性条件和可能被拒赔的风险点。传统上这项工作依赖人工逐条比对,而 AI 的扫描速度和一致性在理论上优于疲劳的人类审阅。
共付额、免赔额与等待期:三个最容易被忽视的关键词
免赔额(deductible)指理赔发生前需要被保险人自掏腰包的固定金额,保险公司只赔付超出这部分的费用。例如一份免赔额 1 万元的车险,维修花费 8 千元时保险公司一分不赔。共付额(co-pay)通常出现在健康险中,指每次就诊或购药时被保险人按固定金额或比例承担的部分,与报销比例直接相关。等待期(waiting period)则是保单生效后的一段时间内特定疾病不予赔付的约定,健康险常见 30~180 天,寿险可能长达两年。这三项参数会显著抬高实际理赔门槛,很多消费者只看保额和保费,恰恰忽略了它们对「实际到手赔付」的削弱作用。Policy Lens 把这三项作为结构化提取的首要目标,正是抓住了保单价值评估中最容易被话术掩盖的部分。
交互式问答
用户可以直接向自己的保单提问,比如「水管漏水造成的损失是否在保障范围内」。系统基于该保单的具体内容给出上下文相关的回答,而不是泛泛的通用保险知识。这种 RAG(检索增强生成)式的交互是当前 LLM 落地的一个典型模式。
RAG 为什么适合保险场景
RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路是:不把全部知识塞进模型参数,而是在回答前先从一份外部资料库中检索相关片段,再让大模型基于这些片段组织答案。对于保险问答,这带来两个直接好处。第一是事实锚定:模型的回答必须引用保单中的具体条款,而不是凭通用保险常识「编造」,大幅降低幻觉风险。第二是可更新性:保单条款随时可能修订,只需替换检索库中的文档,无需重新训练模型。相比直接微调,RAG 的部署成本更低,也更适合 Policy Lens 这种一次性处理单份保单、需要精确引用的场景。
本地推理架构
后端使用 Ollama 驱动 Gemma 模型,敏感文件不离开本机。这意味着不需要网络连接即可使用,也消除了企业客户在数据合规上的顾虑。选择 Gemma 而非更大的模型,暗示开发者更看重本地部署的可行性和推理成本,而非绝对的语言理解能力。
Ollama 与 Gemma 是什么
Ollama 是一个开源的本地大模型运行时,把模型下载、量化、加载和推理封装成一条命令,开发者无需自己折腾 CUDA 或推理框架即可在笔记本上跑起 LLM。Gemma 是 Google 发布的开源轻量级模型系列,参数量覆盖 2B 到 27B,主打在消费级硬件上可运行。相比 GPT-4 这类云端大模型,Gemma 的语言理解能力有差距,但胜在可以完全离线、无需按 token 付费,且数据不出本机。Policy Lens 选择这一组合,本质是在「理解精度」和「隐私+成本」之间做了明确取舍——对结构化信息抽取这类相对规范的任务,轻量模型往往够用;对需要复杂法律推理的例外判断,则可能力不从心。
谁愿意为之付费
作者给出了清晰的商业化分层。
B2B 方向面向独立保险经纪、财务规划师、企业 HR 福利团队以及法律和公共理算机构。这些用户的核心需求是效率——快速审核客户保单、发现保障缺口、生成对比报告。作者设想的 SaaS 订阅价格在每月 29 到 99 美元之间。
B2C 方向则面向个人保单持有人,典型场景是续保前或理赔前做一次「体检」,避免意外拒赔。定价模式为单次微交易,每份报告 5 到 10 美元。
此外还有面向区域保险机构的本地部署企业授权,针对那些因监管要求不能使用云服务的客户。这个方向虽然销售周期长,但客单价和粘性最高。
务实但待验证的路径
从项目描述来看,Policy Lens 的产品思路是务实的:选本地模型解决隐私问题,选保险文档这个高价值垂直场景,并且规划了从 B2C 微交易到 B2B 订阅再到企业私有部署的完整变现路径。
几个关键问题仍待验证。保险条款的 PDF 格式极其多样,不同保险公司的排版、术语体系差异很大,信息提取的准确率能否达到实用水平是第一个门槛。其次,AI 标注的「红旗」条款如果出现误判,对用户的实际决策影响可能比不标注更糟糕。最后,Ollama + Gemma 的本地推理对普通消费者的硬件要求不低,这可能限制 C 端用户的获取。
项目代码已在 GitHub 开源,感兴趣可以自行部署测试。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。